TL;DR
- El problema: El diseño de sistemas suele aprenderse como un montón de casos de estudio sin relación entre sí. La gente memoriza "cómo funciona Twitter" y luego se bloquea cuando el enunciado cambia un poco.
- El camino: Aprende primero el proceso (marco, estimaciones, escalado), luego los bloques (particionado, replicación, IDs, limitación de tasa), después los diseños de producto clásicos que los combinan y por último los grandes sistemas con muchos datos. Practica cada uno en voz alta, con cronómetro, antes de leer la solución.
- El resultado: Dejas de memorizar diseños y empiezas a reconocer la misma docena de ideas en combinaciones nuevas. Eso es lo que se transfiere a las entrevistas y a las revisiones de arquitectura reales.
Cada artículo de esta serie reutiliza el mismo pequeño conjunto de ideas: repartir los datos, copiar los datos, poner una cola delante del trabajo lento, cachear lo que se lee mucho y decidir qué pasa cuando algo falla. Los casos de estudio son solo distintas formas de ordenar esas ideas.
Este artículo es el mapa: qué leer y en qué orden, qué practicar y adónde ir cuando se acabe esta serie.
La hoja de ruta
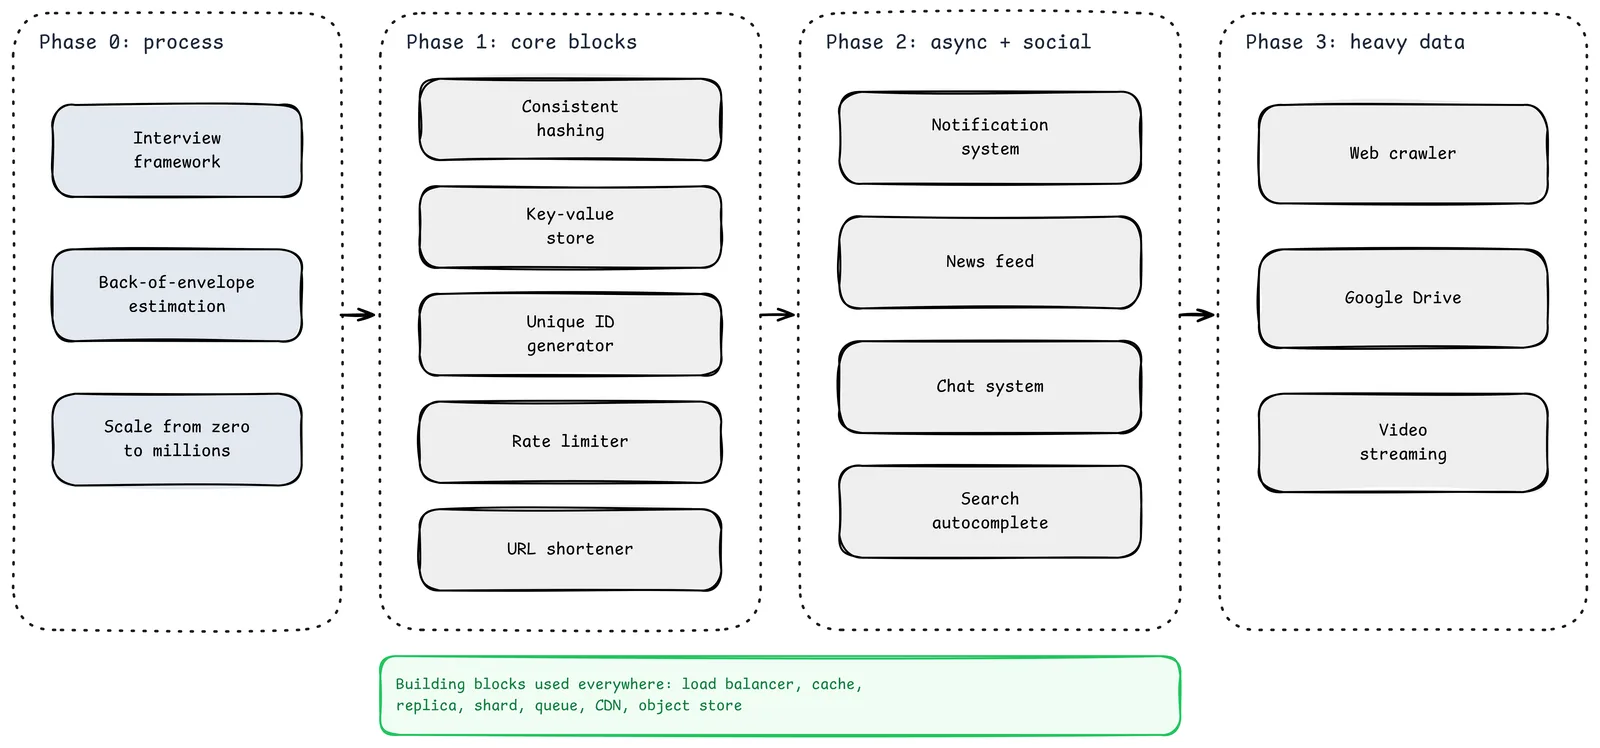
Las fases están ordenadas para que cada una se apoye en la anterior. El news feed es mucho más fácil cuando ya sabes cómo se comportan el particionado y la caché; la plataforma de vídeo es mucho más fácil cuando las colas y los workers idempotentes ya te resultan rutinarios.
Fase 0: el proceso
Lee estos primero, aunque ya hayas hecho diseño de sistemas antes. Son los hábitos que el resto de la serie da por supuestos.
- Un marco práctico para entrevistas de diseño de sistemas: cómo repartir 45 minutos y qué se puntúa.
- Estimaciones de servilleta: convertir adjetivos en cifras que eligen el diseño por ti.
- Escala de cero a millones de usuarios: la evolución típica de un servidor a un sistema multirregión, con cada paso provocado por un cuello de botella real.
Fase 1: los bloques
Cada uno es lo bastante pequeño para diseñarlo entero y aparece dentro de casi cualquier diseño mayor.
| Artículo | La idea que te llevas |
|---|---|
| Consistent hashing | Añadir un nodo debería mover una pequeña fracción de las claves, no casi todas |
| Almacén clave-valor distribuido | Quórums, replicación, gestión de conflictos y cómo el almacenamiento LSM abarata las escrituras |
| Generador de IDs únicos | IDs ordenados sin contador central, y el coste de los problemas de reloj |
| Limitador de tasa | Compromisos entre algoritmos y contadores atómicos en un almacén compartido |
| Acortador de URL | Generación de claves, caché para mucha lectura y una ruta caliente mínima |
Fase 2: diseños de producto
Combinan los bloques en sistemas que los usuarios tocan directamente. Lo interesante está en la latencia, el fan-out y las garantías de entrega.
| Artículo | La idea que te llevas |
|---|---|
| Sistema de notificaciones | Colas, reintentos, idempotencia y respeto a las preferencias del usuario |
| News feed | Fan-out en escritura frente a lectura, y el híbrido que resuelve las celebridades |
| Sistema de chat | Conexiones de larga duración, orden por conversación y estados de entrega |
| Autocompletado de búsqueda | Precalcular las respuestas fuera de línea para que la ruta en línea sea una consulta |
Fase 3: grandes sistemas con muchos datos
Aquí lo difícil es el volumen y el coste: petabytes, miles de millones de páginas, millones de espectadores simultáneos.
| Artículo | La idea que te llevas |
|---|---|
| Rastreador web | Una frontera que equilibra prioridad y cortesía, más deduplicación a escala |
| Google Drive | Sincronización por bloques, direccionamiento por contenido y gestión de conflictos |
| Streaming de vídeo | Subidas reanudables, transcodificación en paralelo, bitrate adaptativo y la economía del CDN |
Los bloques, una línea cada uno
Si solo te quedas con una tabla de esta serie, que sea esta. Casi cualquier pregunta de diseño es una combinación de estos bloques.
| Bloque | Úsalo cuando | Coste principal |
|---|---|---|
| Balanceador | Tienes más de una instancia | Un salto más; comprobaciones de salud que hay que acertar |
| Caché | Dominan las lecturas y algo de antigüedad es aceptable | Invalidación y arranques en frío |
| Réplicas de lectura | Las lecturas superan a una base de datos | Retraso de replicación |
| Particionado | Los datos o las escrituras superan a una base de datos | Consultas entre particiones, rebalanceo, claves calientes |
| Replicación y quórums | Necesitas sobrevivir a la pérdida de nodos | Latencia de escritura y gestión de conflictos |
| Cola de mensajes | El trabajo puede ser asíncrono o debe reintentarse | Duplicados; necesitas consumidores idempotentes |
| CDN | Contenido estático o multimedia para muchos usuarios | Coste e invalidación de caché |
| Almacenamiento de objetos | Ficheros grandes | Más latencia que el disco local |
| Consistent hashing | Los nodos entran y salen a menudo | Carga desigual sin nodos virtuales |
| Limitación de tasa | Proteger recursos compartidos | Falsos positivos en picos legítimos |
Cómo practicar para que se quede
Leer una solución da sensación de aprender. Casi nunca lo es. Lo que funciona:
- Intenta primero. Antes de leer un artículo de esta serie, pon un cronómetro de 45 minutos y diseña tú el sistema en papel, en voz alta, usando el marco.
- Luego compara. Lee el artículo y apunta la una o dos cosas que se te escaparon. Esas notas son tu verdadero material de estudio.
- Repasa una semana después. Vuelve a diseñar el mismo sistema desde cero sin mirar. Si puedes explicar el compromiso principal sin notas, ya es tuyo.
- Cambia un requisito. Rehaz un diseño con un giro: el acortador de URL con audiencia global y privacidad estricta, el chat con cifrado de extremo a extremo, el feed sin ranking. Los giros son lo que de verdad hacen las entrevistas.
- Practica con otra persona. Las entrevistas simuladas con un compañero sacan a la luz los fallos de comunicación que la práctica en solitario oculta. Turnaos como entrevistador; ese papel te enseña cómo suena una buena respuesta.
Adónde ir después de esta serie
Libros
- Designing Data-Intensive Applications, de Martin Kleppmann. El mejor libro sobre cómo funcionan de verdad el almacenamiento, la replicación y la consistencia. Léelo despacio.
- System Design Interview, volúmenes 1 y 2, de Alex Xu. Buena variedad de casos; esta serie cubre muchos de los mismos problemas desde otro ángulo.
- Site Reliability Engineering (el libro de SRE de Google). Gratis en línea. Los capítulos sobre riesgo, monitorización y sobrecarga explican la parte operativa que los diseños en pizarra se saltan.
Artículos académicos que merece la pena leer una vez
- El artículo de Dynamo de Amazon (las ideas detrás del artículo del almacén clave-valor).
- Los artículos de Bigtable y MapReduce de Google.
- El artículo de Raft, para una explicación legible del consenso.
Blogs de ingeniería
Los blogs de ingeniería de las empresas describen sistemas reales con restricciones reales. Netflix, Discord, Cloudflare, Uber, Slack y Meta publican artículos detallados sobre cómo construyeron y escalaron sistemas concretos. Lee uno a la semana y pregúntate qué bloques usa.
Cómo saber que estás listo
Estás listo para las entrevistas, y para discusiones de diseño reales, cuando:
- Puedes tomar un enunciado desconocido y producir una lista de requisitos en cinco minutos sin atascarte.
- Tus estimaciones terminan con una conclusión, no solo con cifras.
- De cada componente que dibujas, sabes decir qué se rompe sin él.
- Puedes nombrar el compromiso principal de tu diseño y qué te haría elegir otra cosa.
- Puedes profundizar en al menos un área (almacenamiento, mensajería o caché) hasta que al entrevistador se le acaben las preguntas.
Lo que queda
Antes pensaba que el objetivo era conocer más arquitecturas. Resultó que el objetivo era necesitar menos. Cuando la docena de bloques te resulta familiar, cada sistema nuevo parece una remezcla, y la pregunta real pasa a ser qué compromiso puede permitirse este producto en concreto.
Es un lugar mucho más tranquilo desde el que diseñar. Empieza por la fase 0.
Fuentes
- Martin Kleppmann, "Designing Data-Intensive Applications"
- Libro de SRE de Google (gratis en línea)
- DeCandia et al., "Dynamo: Amazon's Highly Available Key-value Store" (2007)
- Chang et al., "Bigtable: A Distributed Storage System for Structured Data" (2006)
- Ongaro y Ousterhout, "In Search of an Understandable Consensus Algorithm" (Raft, 2014)
- Alex Xu, "System Design Interview: An Insider's Guide"