TL;DR
- El problema: Un único autoincremento de base de datos es único y ordenado, pero pone una máquina en cada ruta de escritura. En cuanto particionas, o creas IDs antes del insert, necesitas IDs únicos entre muchas máquinas sin preguntar a nadie.
- El diseño: Para la mayoría de sistemas, un ID de 64 bits estilo Snowflake: 41 bits de milisegundos desde una época propia, 10 bits de ID de worker arrendado a un servicio de coordinación y 12 bits de secuencia por milisegundo. Donde 128 bits sean aceptables, UUIDv7 da la misma ordenación temporal sin ninguna coordinación de workers.
- El resultado: Hasta 4.096 IDs por milisegundo por generador, unos 69 años de rango, IDs ordenados aproximadamente por tiempo que mantienen baratas las inserciones en el B-tree, y una política clara para el único modo de fallo real: que el reloj retroceda.
Los IDs parecen fontanería hasta que fallan. Los IDs duplicados corrompen datos en silencio. Los IDs aleatorios inflan los índices. Los IDs secuenciales revelan tu volumen de negocio a cualquiera que se registre dos veces con una semana de diferencia. Y los IDs que dependen de una sola base de datos convierten esa base de datos en el techo de rendimiento de toda la empresa.
Este artículo recorre las opciones en el orden en que la mayoría de empresas las descubren y luego diseña la que casi todas acaban usando.
Requisitos
- Únicos entre todos los generadores, para siempre. Sin excepciones, también tras reinicios y problemas de reloj.
- Ordenables aproximadamente por fecha de creación, para que las consultas de "lo más nuevo primero" y el almacenamiento por intervalos de tiempo funcionen sin un índice de fecha aparte.
- Que quepan en 64 bits si es posible, porque los enteros de 64 bits son baratos de guardar, indexar, comparar y pasar por cualquier lenguaje y base de datos.
- Sin coordinación en la ruta caliente. Generar un ID no debería requerir una llamada de red.
- Alto rendimiento: decenas de miles de IDs por segundo por servicio, con ráfagas.
No todos los sistemas necesitan los cinco. La comparación de abajo muestra a qué renuncias con cada opción.
Las opciones
| Enfoque | Tamaño | Ordenable | Coordinación | Debilidad |
|---|---|---|---|---|
| Autoincremento de base de datos | 64 bits | Sí | Cada insert pasa por una base de datos | Cuello de botella único de escritura; se rompe al particionar; revela volumen |
| Autoincremento multimaestro (paso = N) | 64 bits | Solo por servidor | Número fijo de servidores | Añadir un servidor obliga a renumerar el esquema |
| UUIDv4 | 128 bits | No | Ninguna | Las inserciones aleatorias fragmentan los índices B-tree; claves grandes |
| UUIDv7 (RFC 9562) | 128 bits | Sí (ms) | Ninguna | 128 bits; sigue siendo mayor que una clave entera |
| Servidor de tickets (Flickr) | 64 bits | Sí | Una llamada de red por ID, o por lote | Los servidores de tickets pasan a ser infraestructura crítica |
| Snowflake (Twitter) | 64 bits | Sí (ms) | Solo la asignación del ID de worker al arrancar | Depende de que los relojes se porten bien |
UUIDv4 son 122 bits aleatorios. Las colisiones no son un problema práctico. La localidad del índice sí: cada inserción cae en una página aleatoria del B-tree de la clave primaria, lo que provoca divisiones de página y mantiene caliente en memoria mucha más parte del índice. En tablas grandes es una penalización medible en rendimiento de escritura y eficiencia de caché.
UUIDv7, estandarizado en la RFC 9562 en 2024, pone una marca de tiempo Unix de 48 bits en milisegundos en los bits altos seguida de bits aleatorios. Obtienes orden temporal y buena localidad de índice sin coordinación alguna. Si tu base de datos tiene un tipo UUID nativo y las claves de 16 bytes son aceptables, UUIDv7 es la respuesta buena más sencilla en 2025.
Los servidores de tickets son lo que Flickr describió en 2010: una tabla MySQL diminuta donde REPLACE INTO Tickets64 (stub) VALUES ('a'); SELECT LAST_INSERT_ID(); entrega el siguiente número. Dos servidores configurados con auto_increment_increment = 2 y desplazamientos 1 y 2 dan redundancia (IDs pares e impares). Funciona bien y es fácil de razonar, pero cada ID necesita un viaje de ida y vuelta salvo que entregues lotes.
Snowflake, que Twitter publicó como código abierto en 2010, consigue a la vez orden, 64 bits y ninguna coordinación por ID. Por eso aparecen variantes en Discord, en el esquema de IDs particionados de Instagram y en Sonyflake de Sony.
El formato Snowflake
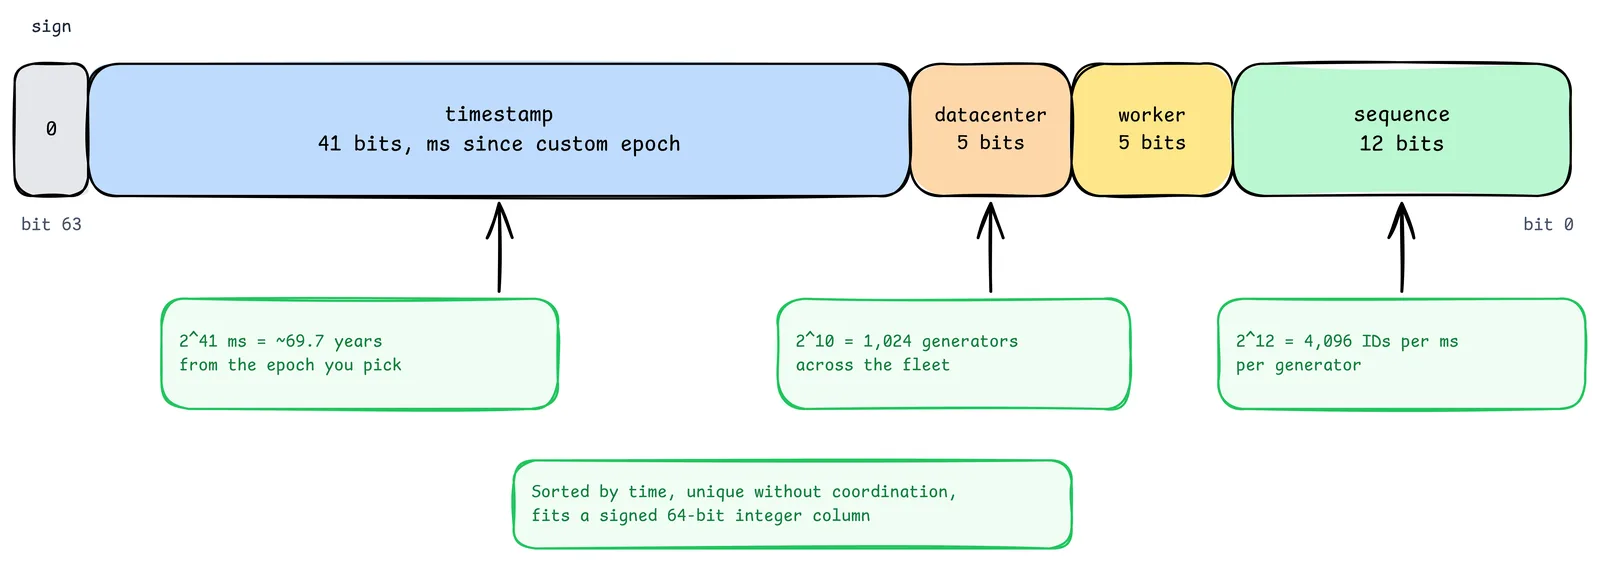
- Bit de signo (0). Se mantiene a cero para que el ID sea un entero positivo con signo de 64 bits en lenguajes y bases de datos sin tipo sin signo.
- Marca de tiempo, 41 bits. Milisegundos desde una época que eliges tú. 2^41 milisegundos son unos 69,7 años. La época de Twitter es de noviembre de 2010; la de Discord, el primer milisegundo de 2015. Elige una época reciente para no desperdiciar rango.
- Centro de datos y worker, 10 bits. Identifican al generador. Dividirlo en 5 + 5 es una convención, no un requisito. Lo que importa es que dos generadores vivos nunca compartan valor.
- Secuencia, 12 bits. Un contador que se reinicia cada milisegundo. 4.096 IDs por milisegundo por generador son unos 4 millones por segundo.
Como la marca de tiempo está en los bits altos, ordenar los IDs numéricamente los ordena por fecha de creación (al milisegundo, y entre generadores solo con la precisión con que coincidan sus relojes).
La variante de Instagram de 2012 cambia el formato a 41 bits de tiempo, 13 bits de ID de fragmento lógico y 10 bits de secuencia, generados dentro del propio PostgreSQL. El principio es idéntico: primero el tiempo, luego el "quién", luego el "cuántos en este milisegundo".
Un generador que funciona
Este es un generador completo y seguro para hilos. Usa un ID de worker plano de 10 bits en lugar de la división 5 + 5, y resuelve los dos casos límite que importan: agotar la secuencia dentro de un milisegundo y que el reloj retroceda.
import threading
import time

EPOCH_MS = 1_704_067_200_000          # 2024-01-01T00:00:00Z, your own epoch
WORKER_BITS, SEQ_BITS = 10, 12
MAX_WORKER, MAX_SEQ = (1 << WORKER_BITS) - 1, (1 << SEQ_BITS) - 1
MAX_BACKWARD_MS = 5

class Snowflake:
    def __init__(self, worker_id: int):
        if not 0 <= worker_id <= MAX_WORKER:
            raise ValueError("worker_id out of range")
        self.worker_id, self.last_ms, self.seq = worker_id, -1, 0
        self.lock = threading.Lock()

    def next_id(self) -> int:
        with self.lock:
            now = time.time_ns() // 1_000_000
            if now < self.last_ms:                      # clock moved backward
                if self.last_ms - now > MAX_BACKWARD_MS:
                    raise RuntimeError("clock moved backward, refusing to mint IDs")
                now = self._wait_until(self.last_ms)
            if now == self.last_ms:
                self.seq = (self.seq + 1) & MAX_SEQ
                if self.seq == 0:                       # 4,096 IDs used this ms
                    now = self._wait_until(self.last_ms + 1)
            else:
                self.seq = 0
            self.last_ms = now
            return ((now - EPOCH_MS) << (WORKER_BITS + SEQ_BITS)) | (self.worker_id << SEQ_BITS) | self.seq

    @staticmethod
    def _wait_until(target_ms: int) -> int:
        while (now := time.time_ns() // 1_000_000) < target_ms:
            time.sleep(0.0001)
        return now
Lo ejecuté para 300.000 IDs en un generador: todos únicos, estrictamente crecientes, y cada uno se decodificó a la marca de tiempo y al worker correctos. Decodificar son solo desplazamientos y máscaras: timestamp = (id >> 22) + EPOCH_MS, worker = (id >> 12) & 1023, sequence = id & 4095.
Dónde vive el generador
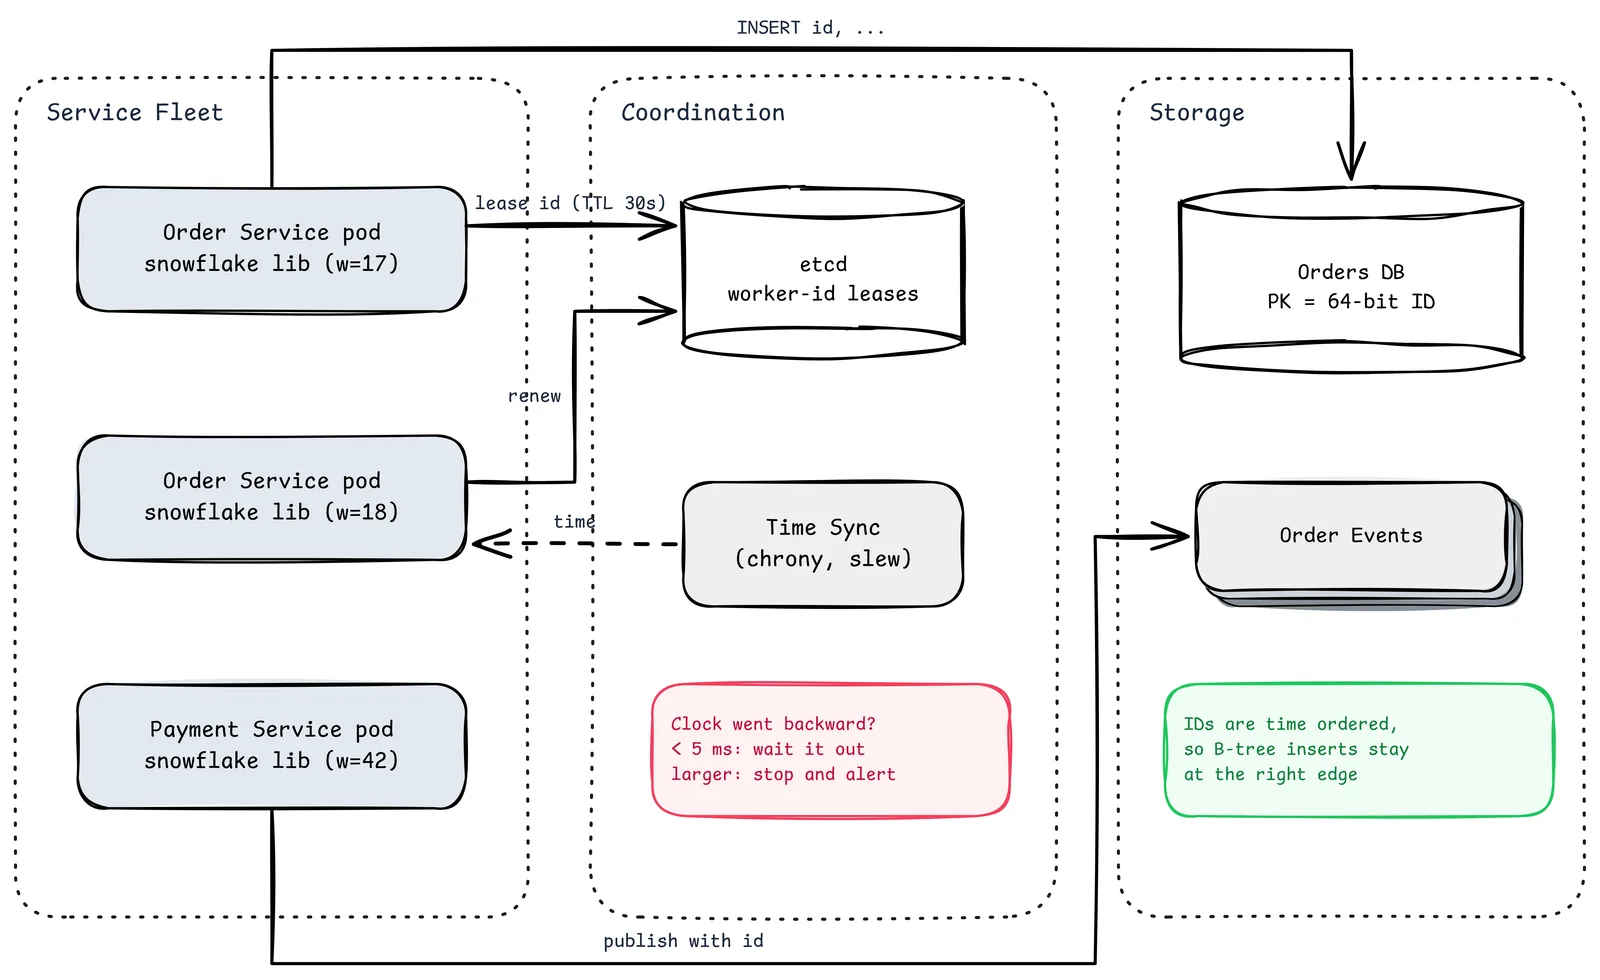
- Pods de servicio con librería integrada. El generador es una librería dentro de cada servicio, no un servicio de red. Crear un ID es una llamada a función bajo un cerrojo: sin saltos ni dependencias en la ruta de la petición.
- etcd (arriendos de ID de worker). Al arrancar, cada pod arrienda un ID de worker libre con un TTL (por ejemplo, 30 segundos) y lo renueva mientras vive. Si el pod muere, el arriendo caduca y el ID puede reutilizarse, pero solo después del TTL, así que dos pods vivos nunca lo comparten. Los nodos efímeros de ZooKeeper o una tabla de arriendos en base de datos funcionan igual. La configuración estática también sirve en flotas fijas, pero es justo lo que rompe el autoescalado.
- Time Sync (chrony, modo slew). La disciplina del reloj es la dependencia real del generador. Configura NTP/chrony para ajustar gradualmente (acelerar o frenar el reloj poco a poco) en lugar de dar saltos, para que las correcciones no lleven el tiempo hacia atrás.
- Orders DB. La clave primaria es el ID de 64 bits. Como los IDs están ordenados por tiempo, las filas nuevas caen en el borde derecho del B-tree, el caso barato para cualquier motor relacional.
- Order Events. El mismo ID viaja en eventos, logs y trazas, lo que hace trivial relacionar una fila con todo lo que pasó a su alrededor.
La nota roja es la política para el único fallo que da miedo, que se trata a continuación.
El verdadero problema son los relojes
La unicidad de Snowflake descansa en una suposición: un generador nunca reutiliza un par (timestamp, sequence). Un reloj que salta hacia atrás rompe esa suposición.
Por qué los relojes saltan hacia atrás: un salto de NTP tras una deriva larga, una VM que migra a un host con otro reloj, un cambio manual o una implementación de segundo intercalar que repite un segundo.
Defensas, por orden de preferencia:
- Evitar saltos grandes. Usa chrony o ntpd configurados para ajuste gradual. Usa el "leap smear" (Google y AWS publican hora suavizada) para que nunca haya un segundo repetido.
- Absorber saltos pequeños. Si el reloj va unos milisegundos por detrás de la última marca usada, espera a que se ponga al día, como hace el código de arriba.
- Rechazar saltos grandes. Si el reloj va muy por detrás, deja de generar IDs y lanza una alerta. Fallar con ruido es mucho mejor que producir duplicados en silencio.
- Sobrevivir a los reinicios. Al arrancar, espera a que el reloj supere la última marca que pudo usar el proceso anterior (o persístela), sobre todo si un reinicio puede caer en otro host.
Recuerda también que el orden temporal entre generadores es tan bueno como el acuerdo entre sus relojes. Dos IDs generados con un milisegundo de diferencia en máquinas distintas pueden ordenarse en cualquier sentido. "Aproximadamente ordenados" es la promesa honesta.
Notas de seguridad y de producto
- Los IDs filtran información. Un ID Snowflake revela cuándo se creó algo y a veces en qué centro de datos. Los IDs secuenciales de base de datos revelan volumen (crea dos pedidos con una semana de diferencia y resta). Para identificadores públicos, considera un ID opaco aparte o cifrar el interno.
- Nunca uses IDs como secretos. Imposible de adivinar no significa autorizado. Las comprobaciones de autorización siguen aplicándose a cada búsqueda por ID.
- Precisión en JavaScript. Los números en JavaScript son dobles, seguros solo hasta 2^53. Un Snowflake de 64 bits enviado como número JSON se redondeará en silencio en los navegadores. Envía los IDs como cadenas en JSON. La API de Discord hace exactamente eso.
Cómo elegiría
| Situación | Elección |
|---|---|
| Una base de datos, ritmo de escritura moderado, IDs internos | El autoincremento basta. No sobrediseñes |
| Necesitas IDs antes del insert, puedes guardar 16 bytes, sin presupuesto de operaciones para coordinar | UUIDv7 |
| Necesitas enteros de 64 bits, muchos servicios, alto rendimiento | Snowflake con IDs de worker arrendados |
| Necesitas números estrictamente consecutivos (facturas, secuencias legales) | Un servidor de tickets o una secuencia de base de datos, aceptando el cuello de botella |
Lista de comprobación para producción
- Época elegida reciente y documentada; horizonte de 69 años anotado
- IDs de worker arrendados con TTL a un servicio de coordinación, nunca asignados a mano en flotas autoescaladas
- Sincronización de reloj en modo de ajuste gradual; leap smear activado
- Política de reloj hacia atrás implementada: esperar con desfases pequeños, fallar y alertar con desfases grandes
- Agotar la secuencia espera al siguiente milisegundo en lugar de dar la vuelta
- IDs serializados como cadenas en las APIs JSON
- IDs públicos revisados para evitar fugas de información
- Métricas: IDs generados por segundo, esperas por secuencia agotada, errores de desfase de reloj, fallos al renovar arriendos
Lo que queda
Un ID Snowflake es una autobiografía diminuta: cuándo nació, dónde y cuántos hermanos tuvo en ese milisegundo.
También es una apuesta silenciosa a que el reloj de esa máquina seguirá avanzando. Casi siempre lo hace. Todo el diseño trata de las pocas veces que no, y de asegurarse de que el generador se da cuenta antes que tu base de datos.
Fuentes
- Twitter Engineering: Announcing Snowflake (2010)
- Flickr: Ticket Servers, Distributed Unique Primary Keys on the Cheap
- Instagram Engineering: Sharding and IDs at Instagram
- RFC 9562: Universally Unique IDentifiers (UUIDv7)
- Documentación para desarrolladores de Discord: Snowflakes
- Google Public NTP: leap smear
- Relacionado en esta serie: Diseña un acortador de URL, Diseña un almacén clave-valor