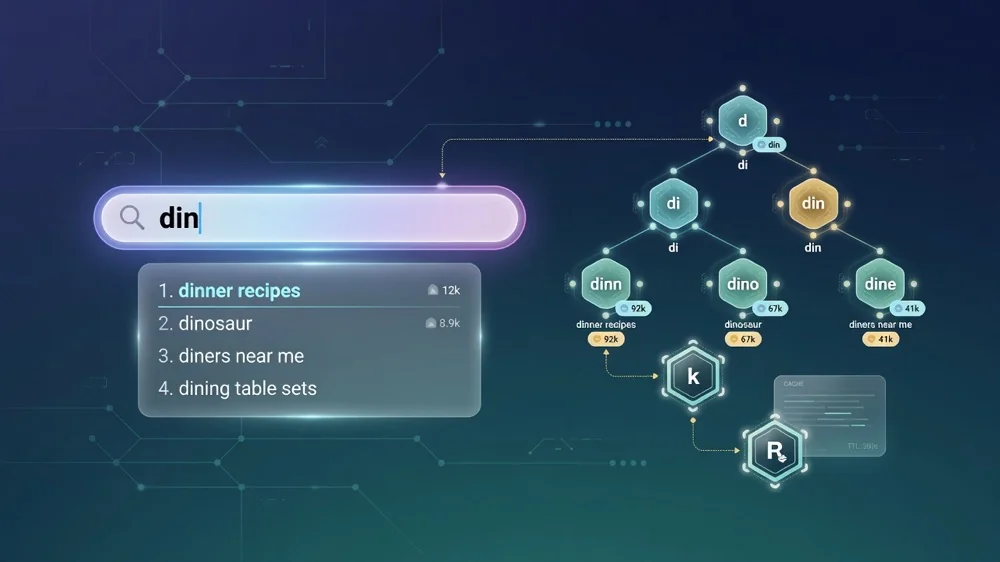
TL;DR
- El problema: Devolver las diez mejores terminaciones para el prefijo que haya escrito el usuario, en cada pulsación, tan rápido que las sugerencias parezcan instantáneas (bastante menos de 100 ms de extremo a extremo), para decenas de miles de peticiones por segundo y sin sugerir nunca nada ofensivo.
- El diseño: Dividir el sistema en dos rutas. La ruta de consulta es una búsqueda pura en memoria sobre un trie en el que cada nodo ya guarda sus k mejores terminaciones, con cachés de CDN y de cliente delante. La ruta de datos agrega los logs de búsqueda offline con decaimiento temporal, los filtra, construye nuevas instantáneas del trie y las envía a los servidores.
- El resultado: Una búsqueda cuesta un recorrido de
len(prefix)pasos y devuelve una lista calculada hace horas. Todo el trabajo caro, el ranking, el filtrado y la deduplicación, ocurre offline, donde puede ser lento y cuidadoso.
El autocompletado es una de las pocas funcionalidades donde la latencia es el producto. Un buscador que sugiere "dinner recipes" 300 ms después de que escribieras "din" parece roto, aunque las sugerencias sean buenas. El diseño sale de esa única restricción: no puede pasar nada caro mientras el usuario escribe.
Requisitos y cifras
Funcionales: dado un prefijo, devolver hasta 10 sugerencias ordenadas por popularidad (opcionalmente personalizadas y localizadas); actualizar las sugerencias cuando cambia el comportamiento de búsqueda; no sugerir nunca contenido bloqueado.
No funcionales: p99 por debajo de unos 50 ms en el servidor para que la experiencia completa quede por debajo de 100 ms; muy disponible (si el autocompletado falla, la búsqueda debe seguir funcionando); los resultados pueden tener horas de antigüedad.
| Supuesto | Valor | Derivado |
|---|---|---|
| Usuarios que buscan a diario | 10M | |
| Búsquedas por usuario y día | 10 | 100M búsquedas/día |
| Peticiones por búsqueda tras el debounce | ~6 | ~600M peticiones/día, ~7k/s de media, ~20k/s en pico |
| Consultas distintas que se guardan | ~100M | Tras descartar la cola larga vista solo una o dos veces |
| Sugerencias por nodo | 10 | La memoria crece con nodos x k, por eso k se mantiene pequeño |
La cifra de peticiones por búsqueda es donde importa el diseño del cliente. Sin debounce, una consulta de 15 caracteres son 15 peticiones.
Dos rutas
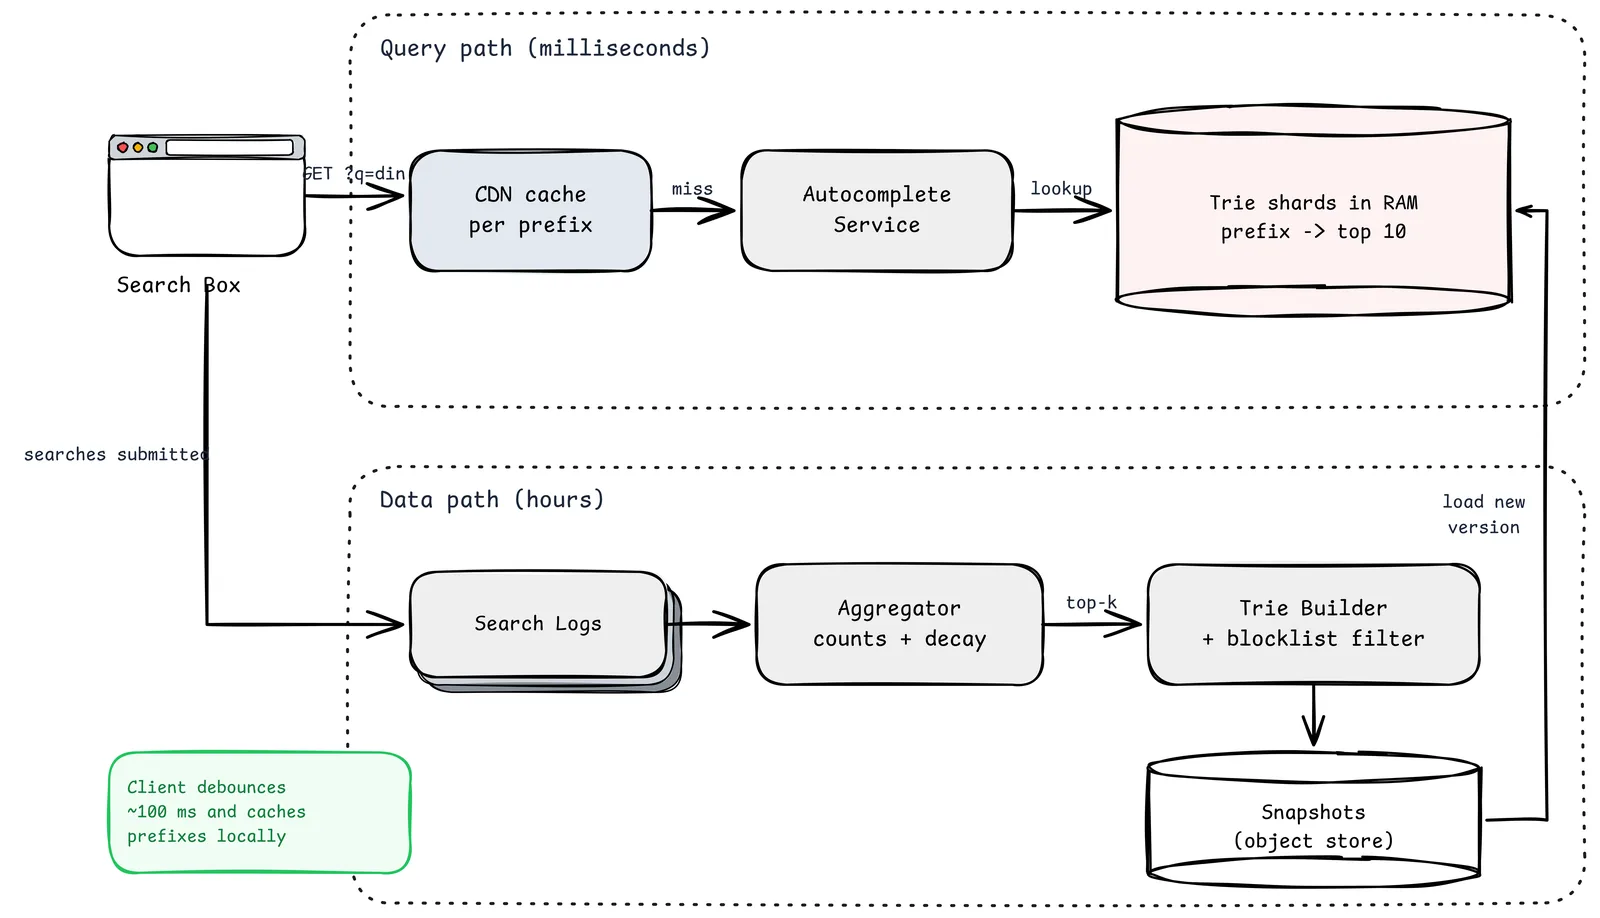
Ruta de consulta (milisegundos)
- Search Box. Aplica debounce a las pulsaciones (unos 100 ms), cachea respuestas por prefijo en local y cancela las peticiones en curso cuando se escribe un prefijo más nuevo.
- Caché de CDN por prefijo. Los prefijos cortos ("a", "th", "how") los piden millones de usuarios. Cachear las respuestas en el borde unos minutos absorbe gran parte del tráfico antes de que llegue a tus servidores. Los resultados personalizados no pueden cachearse así, y esa es una de las razones por las que la personalización suele ser una capa fina de reordenación encima.
- Autocomplete Service. Gestión de peticiones sin estado: normalizar el prefijo (minúsculas, recortar espacios, normalización Unicode), enrutar al fragmento correcto del trie y devolver la lista guardada.
- Fragmentos del trie en RAM. Todo el índice vive en memoria. Cada nodo guarda su top 10 precalculado.
Ruta de datos (horas)
- Search Logs. Se registra cada búsqueda enviada (no cada pulsación) con hora, idioma y si el usuario hizo clic en un resultado.
- Agregador (recuentos y decaimiento). Un trabajo por lotes o en streaming calcula una puntuación por consulta, dando más peso a las búsquedas recientes, para que las noticias de la semana pasada se apaguen y suba el nombre de un producto nuevo.
- Trie Builder + filtro de bloqueo. Descarta términos bloqueados, datos personales y spam, y construye el trie con listas top-k por nodo.
- Snapshots (almacenamiento de objetos). Ficheros del trie versionados. Los servidores cargan una versión nueva en segundo plano y la cambian de forma atómica; una construcción mala se deshace apuntando a la versión anterior.
La división es todo el diseño. La ruta de consulta nunca calcula nada; la ruta de datos nunca sirve nada.
El trie, con top-k en cada nodo
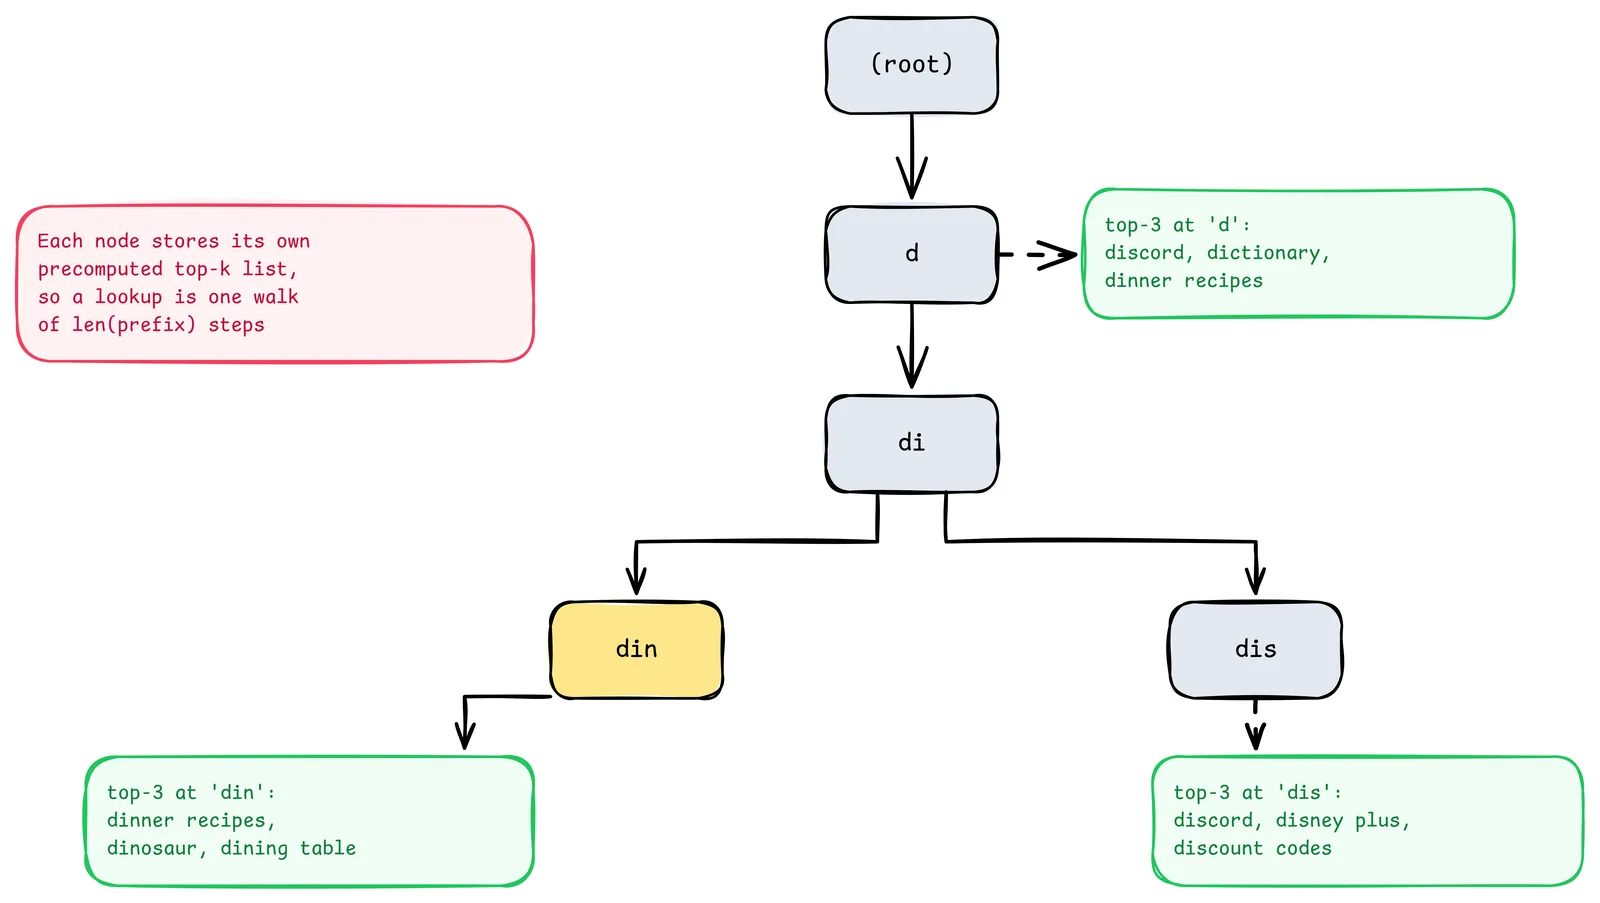
Un trie normal encuentra todas las palabras con un prefijo bajando hasta el nodo del prefijo y recorriendo todo lo que hay debajo. Para el prefijo "d", ese subárbol es enorme. La solución es guardar la respuesta en el nodo: al construir, se empuja la puntuación de cada consulta a la lista top-k de cada nodo de su camino. Una búsqueda es entonces un recorrido de len(prefix) pasos seguido de devolver una lista.
import heapq

class Node:
    __slots__ = ("children", "top")
    def __init__(self):
        self.children, self.top = {}, []

def build(counts: dict[str, int], k: int = 10) -> Node:
    root = Node()
    for query, score in counts.items():
        node = root
        for ch in query:
            node = node.children.setdefault(ch, Node())
            heapq.heappush(node.top, (score, query))
            if len(node.top) > k:
                heapq.heappop(node.top)          # keep only the k best
    for node in _walk(root):                      # freeze: best first
        node.top = [q for _, q in sorted(node.top, reverse=True)]
    return root

def _walk(node):
    yield node
    for child in node.children.values():
        yield from _walk(child)

def suggest(root: Node, prefix: str) -> list[str]:
    node = root
    for ch in prefix.lower():
        node = node.children.get(ch)
        if node is None:
            return []
    return node.top
Con las puntuaciones discord: 2000, dictionary: 1200, dinner recipes: 900, disney plus: 850, discount codes: 800, dinosaur: 700, dining table: 650 y k = 3, suggest("din") devuelve ["dinner recipes", "dinosaur", "dining table"], igual que el diagrama. Lo ejecuté para comprobarlo.
El coste en memoria. Guardar k sugerencias en cada nodo multiplica la memoria, así que los sistemas en producción guardan IDs de consulta en lugar de cadenas, limitan la profundidad a la que se guardan listas (los prefijos profundos son raros y pueden recurrir a recorrer el subárbol) y comprimen la estructura. El completion suggester de Lucene y Elasticsearch usa transductores de estado finito (FST) exactamente por esto: comparten prefijos y sufijos comunes y meten vocabularios grandes en memoria.
Ranking y frescura
| Señal | Efecto |
|---|---|
| Frecuencia de la consulta con decaimiento temporal | Popularidad base que aun así deja subir las tendencias nuevas |
| Clics en los resultados | Se degradan las consultas que no llevan a ninguna parte |
| Idioma y región | "football" significa cosas distintas en distintos países |
| Historial personal | Una ligera reordenación de la lista global, hecha en el servicio, no en el trie |
| Detección de tendencias | Una pequeña ruta de streaming que inyecta consultas en auge entre reconstrucciones completas |
Una reconstrucción completa cada pocas horas cubre casi todas las necesidades de frescura. Para noticias de última hora, un trabajo en streaming puede calcular un pequeño trie de "tendencias" que el servicio mezcla con el resultado principal, para que un pico repentino aparezca en minutos y no en horas.
Escalar la ruta de consulta
- Replica antes de particionar. Un trie filtrado para un idioma cabe a menudo en decenas de gigabytes de RAM. Replicar el trie entero en cada servidor es más sencillo que particionarlo y le da a cada servidor la respuesta completa.
- Particiona por prefijo cuando ya no quepa. Divide por el primer carácter o los dos primeros, con cortes más finos para las letras con sesgo (muchas más consultas empiezan por "s" que por "x"). El servicio enruta por el prefijo normalizado.
- Cachea con fuerza en el borde. Los prefijos cortos son los más calientes y los menos personales; dales TTL de CDN de minutos.
- Falla devolviendo nada. Si el autocompletado está caído, devuelve rápido una lista vacía. La caja de búsqueda sigue funcionando; los usuarios solo escriben un poco más.
La seguridad no es opcional
El autocompletado pone palabras en boca de los usuarios. Todas las grandes empresas de búsqueda han pasado vergüenza por una sugerencia que completaba el nombre de una persona con una acusación o el de un colectivo con un insulto.
- Mantén listas de bloqueo para odio, violencia, contenido sexual y autolesiones, aplicadas en el constructor y revisadas de nuevo al servir para añadidos de urgencia.
- Elimina datos personales como teléfonos y emails de los logs antes de agregarlos.
- Ten especial cuidado con las consultas sobre personas; muchos productos no sugieren terminaciones sobre personas con nombre en contextos sensibles.
- Exige un número mínimo de usuarios distintos antes de que una consulta pueda sugerirse, para que una sola persona o un bot no puedan inyectar sugerencias.
- Ofrece un interruptor de emergencia por sugerencia que surta efecto en minutos, no en la siguiente reconstrucción.
Lista de comprobación para producción
- Debounce en el cliente, caché local por prefijo y cancelación de peticiones
- Normalización de prefijos idéntica en el constructor y en el servicio
- Top-k guardado por nodo; memoria medida en cada construcción
- Construcciones versionadas, validadas (tamaño, consultas de muestra, lista de bloqueo) y cambiadas de forma atómica
- Vuelta a la instantánea anterior en un solo paso
- Caché de CDN para prefijos cortos y no personalizados
- Umbral mínimo de usuarios distintos y listas de bloqueo, más una vía de retirada de emergencia
- Fallar rápido con una lista vacía; la búsqueda no debe depender del autocompletado
- Paneles: latencia p99, tasas de aciertos de caché (cliente, CDN, servicio), clics en sugerencias, antigüedad de la construcción
Lo que queda
El mejor autocompletado es aquel en el que los usuarios nunca piensan. Escriben tres letras, lo que querían ya está ahí y pulsan intro.
Detrás de ese momento hay un pipeline que se ejecutó hace horas, una lista de bloqueo que alguien actualizó a medianoche y una instantánea que se cargó sin hacer ruido. El usuario vio diez palabras. El sistema recordó a millones de personas que hicieron la misma pregunta antes.
Fuentes
- Elasticsearch: completion suggester (basado en FST)
- Apache Lucene: documentación del paquete FST
- Ayuda de la Búsqueda de Google: cómo funciona el autocompletado y sus políticas
- MDN: debounce (glosario)
- Relacionado en esta serie: Diseña un rastreador web, Estimaciones de servilleta, Patrones de caché con Redis