TL;DR
- El problema: Guardar miles de millones de valores pequeños detrás de
put(key, value)yget(key), en muchas máquinas, siguiendo disponible para escribir cuando algunas fallan y con una latencia predecible de pocos milisegundos.- El diseño: Particionar las claves en un anillo de consistent hashing, replicar cada clave en N nodos y dejar que los clientes elijan W y R por petición. Aceptar escrituras durante los fallos con quórums laxos y hinted handoff, reparar la deriva con read repair y árboles de Merkle, detectar fallos con gossip y guardar los datos de cada nodo en un árbol LSM.
- El resultado: Un sistema que cambia algo de consistencia por disponibilidad de forma controlada y ajustable. Es el diseño detrás del artículo de Dynamo de Amazon, de Cassandra y de Riak, y el modelo mental detrás de DynamoDB.
Un almacén clave-valor tiene la API más pequeña de toda esta serie: dos verbos. Justo por eso es una buena pregunta de entrevista. Sin nada detrás de lo que esconderse, cada decisión trata de la distribución: dónde viven los datos, cuántas copias existen, qué pasa cuando falta una copia y qué significa siquiera "el valor actual" cuando dos máquinas no están de acuerdo.
Este artículo construye un almacén al estilo Dynamo, porque ese diseño te obliga a enfrentarte de forma explícita a cada una de esas preguntas.
Requisitos
- API:
put(key, value),get(key)y opcionalmentedelete(key). Valores de hasta 1 MB aproximadamente; la mayoría por debajo de 10 KB. - Escala: decenas de terabytes, cientos de miles de operaciones por segundo.
- Primero la disponibilidad: las escrituras deben funcionar aunque unos pocos nodos o una zona de disponibilidad entera no respondan. Los carritos de la compra y los almacenes de sesión son los ejemplos clásicos: perder una escritura es peor que leer brevemente un valor antiguo.
- Consistencia ajustable: algunos llamantes necesitan leer lo que acaban de escribir; otros aceptan encantados un valor algo antiguo a cambio de menos latencia.
- Operabilidad: añadir y quitar nodos sin cortes; recuperarse de la pérdida de un disco automáticamente.
Esbozo de capacidad: 20 TB de datos con factor de replicación 3 son 60 TB en disco. Con nodos de unos 2 TB cada uno, y manteniéndolos por debajo del 60% para dejar margen a la compactación, salen unos 50 nodos. Si cada nodo sirve con holgura 10.000 operaciones por segundo, el clúster sirve unas 500.000 operaciones por segundo antes de cualquier caché.
CAP, dicho con precisión
El teorema CAP dice que durante una partición de red un sistema debe elegir entre consistencia (cada lectura ve la última escritura) y disponibilidad (cada petición a un nodo vivo recibe una respuesta que no es un error). Sin partición, puedes tener las dos.
PACELC añade la parte que la gente olvida: si no hay partición, sigues intercambiando latencia por consistencia, porque esperar a más réplicas tarda más.
| Estilo de sistema | Durante una partición | Normalmente | Ejemplos |
|---|---|---|---|
| CP | Rechaza peticiones en el lado minoritario | Consistente, más latencia | etcd, ZooKeeper, Spanner |
| AP | Sigue aceptando lecturas y escrituras en todas partes | Ajustable; a menudo consistencia eventual | Dynamo, Cassandra, Riak |
Este artículo construye la variante AP, con perillas que permiten a los llamantes acercarse a la consistencia cuando la necesitan.
Particionado y replicación
Las claves se colocan en un anillo de consistent hashing con nodos virtuales (mira el artículo de consistent hashing de esta serie). La lista de preferencia de cada clave son los N primeros nodos físicos distintos en sentido horario desde su posición, repartidos entre zonas de disponibilidad. Con N = 3, cada clave tiene tres réplicas, y perder un nodo o una zona no pierde datos.
Cualquier nodo puede actuar como coordinador de una petición. Los clientes envían las peticiones a cualquier nodo (que las reenvía si hace falta) o usan un cliente consciente de las particiones que envía directamente a una réplica, ahorrando un salto.
Quórums: la perilla de la que todos hablan
En cada petición, el coordinador envía la operación a las N réplicas y espera a un subconjunto:
- W = cuántas réplicas deben confirmar una escritura para que tenga éxito.
- R = cuántas réplicas deben responder a una lectura para que devuelva un resultado.
Si R + W > N, cada quórum de lectura se solapa con cada quórum de escritura en al menos una réplica, así que una lectura verá al menos una copia de la última escritura con éxito.
| N, W, R | Comportamiento | Úsalo cuando |
|---|---|---|
| 3, 1, 1 | El más rápido y el más débil; las lecturas pueden perderse escrituras recientes con facilidad | Datos tipo caché, métricas |
| 3, 2, 2 | Quórums solapados; tolera una réplica lenta o caída en cada ruta | El valor por defecto habitual |
| 3, 3, 1 | Lecturas rápidas; las escrituras fallan si cae cualquier réplica | Datos de mucha lectura que casi no cambian |
| 3, 1, 3 | Escrituras rápidas, lecturas lentas | Registros de mucha escritura que casi no se leen |
Lo que los quórums no te dan. R + W > N no es linealizabilidad. Con escrituras concurrentes, marcas de tiempo de última escritura gana y quórums laxos (más abajo), una lectura todavía puede devolver un valor antiguo o uno que se sobrescribió después. Designing Data-Intensive Applications de Martin Kleppmann es la explicación más clara de estos casos límite. Si necesitas semántica real de compare-and-set, necesitas un protocolo de consenso (Paxos, Raft) o una escritura condicional, no un quórum más grande.
La ruta de escritura cuando una réplica está caída
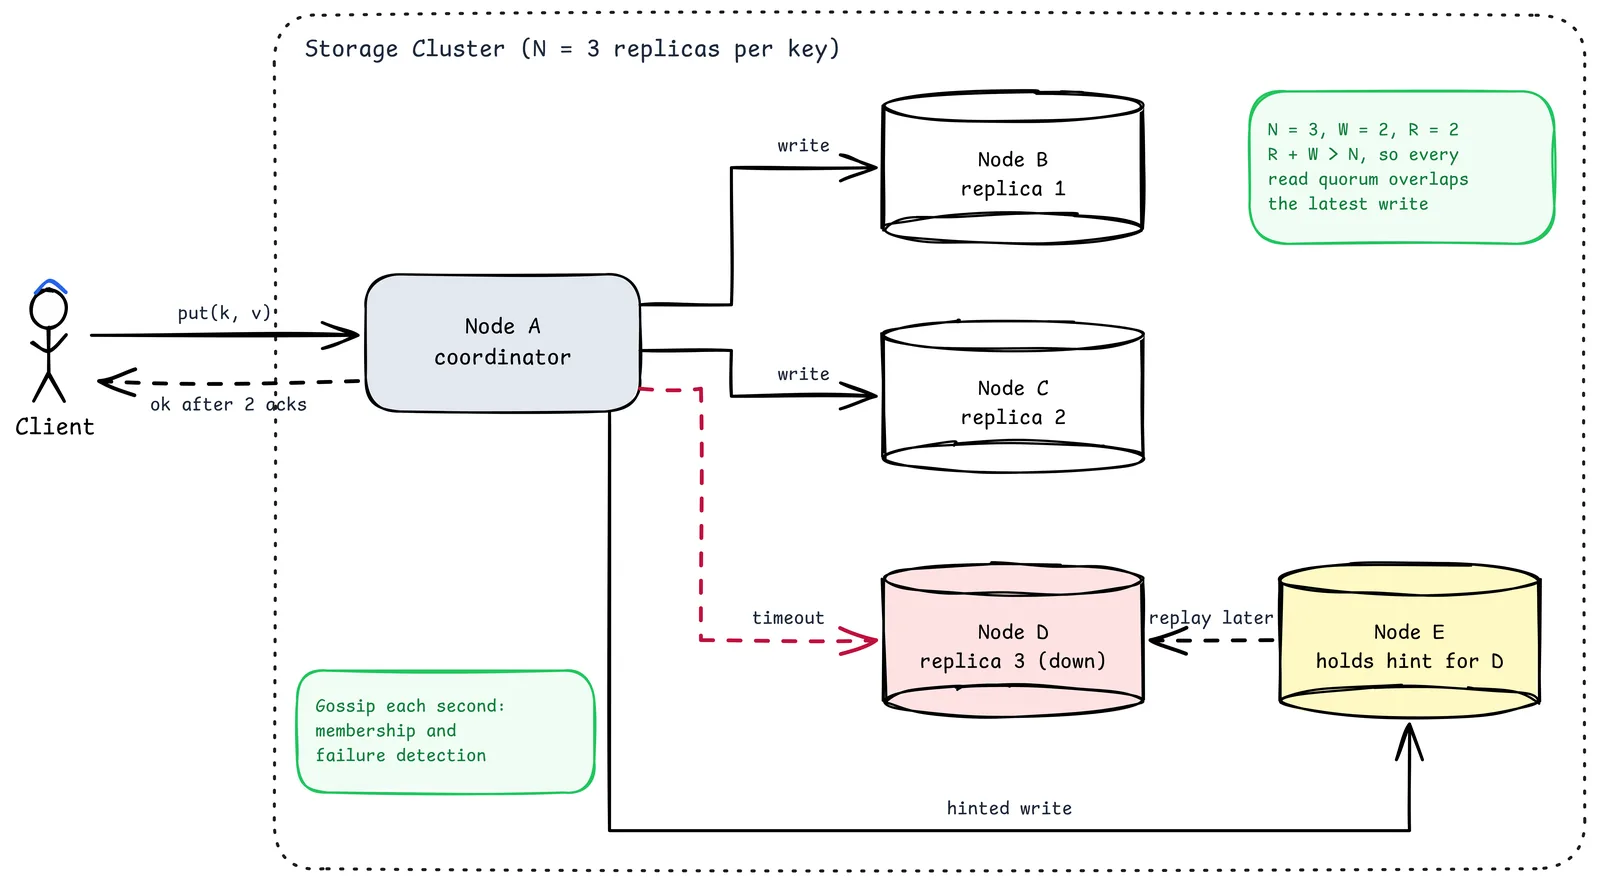
- Client. Envía
put(k, v)con el nivel de consistencia que elige. - Node A (coordinador). Reenvía la escritura a la lista de preferencia de la clave y responde cuando W réplicas han confirmado. No espera a la réplica más lenta.
- Nodes B y C (réplicas 1 y 2). Confirman. Con W = 2, el cliente recibe el éxito aquí.
- Node D (réplica 3, caída). La escritura agota el tiempo. En un quórum estricto, el coordinador contaría solo B y C y seguiría.
- Node E (guarda la pista para D). En un quórum laxo, el coordinador escribe la copia de D en el siguiente nodo sano del anillo, etiquetada con una pista que dice "esto es de D". Así la durabilidad se mantiene en tres copias durante la caída.
- Reenvío posterior. Cuando el gossip informa de que D ha vuelto, E le transmite las escrituras con pista y las borra. Esto es el hinted handoff.
- Gossip. Cada nodo intercambia cada segundo el estado de membresía y latidos con unos pocos pares aleatorios. Cassandra usa encima un detector de fallos phi accrual, que da un nivel de sospecha en lugar de un sí o no, para que una red lenta no marque nodos como muertos al instante.
La nota verde enuncia la regla del solapamiento. El precio de los quórums laxos es que, durante un tiempo, los "W nodos" que confirmaron pueden no ser los nodos de destino reales de la clave, que es una de las razones por las que los quórums por sí solos no garantizan consistencia fuerte.
Cuando las réplicas no coinciden
Las réplicas se desvían: un nodo se pierde escrituras durante una caída más larga que la ventana de pistas, se cambia un disco, la red parpadea. Tres mecanismos las vuelven a juntar:
- Read repair. Cuando una lectura con R > 1 ve versiones distintas, el coordinador devuelve la más reciente y la reescribe en las réplicas atrasadas.
- Antientropía con árboles de Merkle. Cada nodo construye un árbol de hashes sobre sus rangos de claves. Dos réplicas comparan los hashes raíz y bajan solo a los subárboles que difieren, de modo que encuentran unas pocas claves distintas entre miles de millones intercambiando muy pocos datos. Cassandra lo ejecuta como
nodetool repair. - Hinted handoff, visto arriba, para caídas cortas.
¿Qué versión gana? Necesitas una regla:
| Estrategia | Cómo funciona | Coste |
|---|---|---|
| Última escritura gana (LWW) | Gana la marca de tiempo más alta | Sencilla, pero las escrituras concurrentes pierden datos en silencio; depende de la sincronización de relojes |
| Relojes vectoriales | Cada versión lleva contadores por nodo; las versiones concurrentes se conservan como hermanas | Sin pérdidas silenciosas, pero la aplicación debe fusionar las hermanas (el carrito de Dynamo lo hacía) |
| CRDT | Tipos de datos cuya fusión está libre de conflictos por construcción (contadores, conjuntos, mapas) | Elegantes donde encajan; no todo tipo de dato tiene un CRDT natural |
Cassandra usa LWW por columna. El Dynamo original usaba relojes vectoriales y delegaba la fusión en la aplicación. DynamoDB ofrece escrituras condicionales para que las aplicaciones eviten los conflictos en lugar de resolverlos.
Los borrados son escrituras. Un borrado escribe una lápida, una marca que dice "esta clave se borró en el instante T". Las lápidas deben vivir más que la caída de réplica más larga posible, o una réplica que se perdió el borrado resucitará el valor durante la reparación. El gc_grace_seconds de Cassandra (10 días por defecto) existe precisamente por esto.
Dentro de un nodo: el motor de almacenamiento LSM
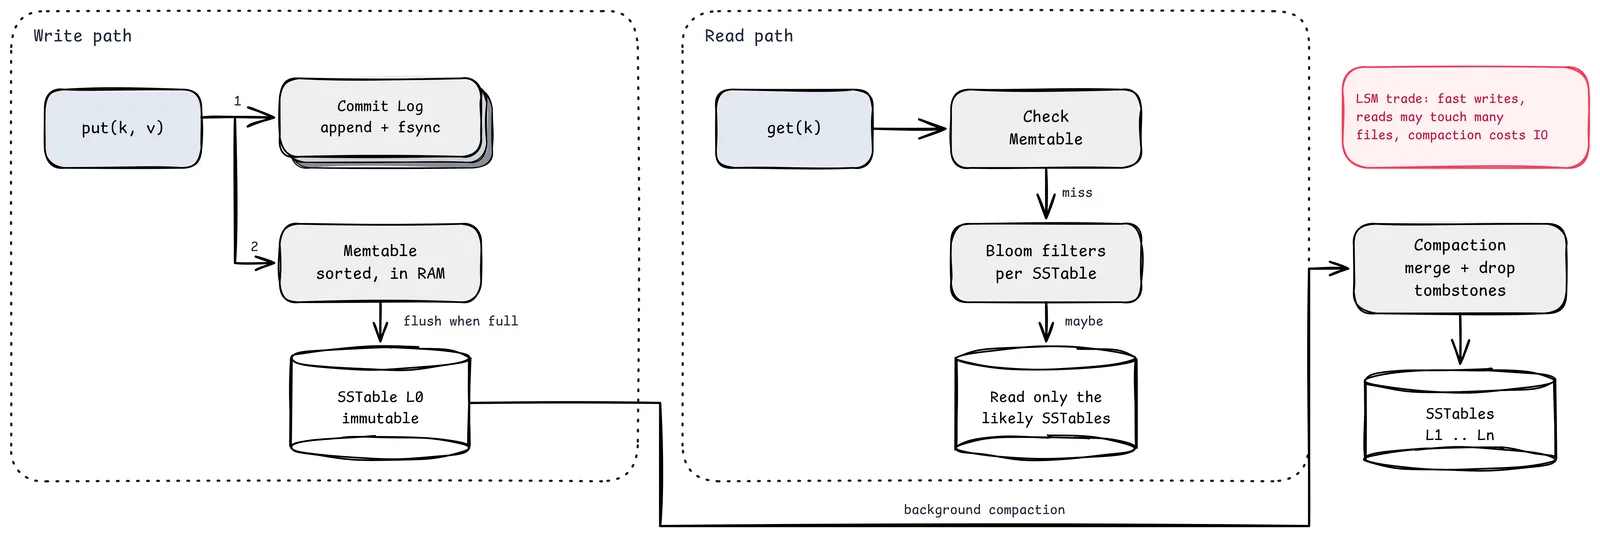
La mayoría de almacenes al estilo Dynamo usan un árbol LSM (log-structured merge tree), el diseño detrás de LevelDB, RocksDB y el motor de almacenamiento de Cassandra.
Ruta de escritura
- Añadir la escritura al commit log y hacer fsync (o confirmar en grupo), para que sobreviva a una caída.
- Insertarla en el memtable, una estructura ordenada en memoria.
- Cuando el memtable se llena, volcarlo a disco como una SSTable, un fichero ordenado e inmutable. Las escrituras nunca modifican ficheros en su sitio, lo que las hace secuenciales y rápidas.
Ruta de lectura
- Mirar el memtable.
- Para cada SSTable, consultar su filtro de Bloom, una estructura probabilística compacta que responde "seguro que no está" o "quizá esté". Un filtro bien dimensionado descarta la inmensa mayoría de ficheros que no contienen la clave.
- Leer solo las SSTables que podrían contenerla, de la más nueva a la más antigua.
La compactación se ejecuta en segundo plano, fusionando SSTables y descartando valores sobrescritos y lápidas caducadas. La compactación por tamaños favorece el rendimiento de escritura; la compactación por niveles favorece la latencia de lectura y el espacio a costa de más amplificación de escritura.
| Árbol LSM | B-tree | |
|---|---|---|
| Escrituras | Secuenciales, rápidas | Actualizaciones de páginas en su sitio, IO aleatoria |
| Lecturas | Pueden tocar varios ficheros; los filtros de Bloom ayudan | Un recorrido del árbol |
| Espacio | Duplicación temporal hasta la compactación | Fragmentación con el tiempo |
| Motores típicos | RocksDB, LevelDB, Cassandra | InnoDB, PostgreSQL, BoltDB |
Historias de fallo para contar
| Evento | Qué hace el sistema |
|---|---|
| Un nodo cae durante 5 minutos | Las escrituras con quórum laxo van al siguiente nodo con pistas; el hinted handoff las reenvía al recuperarse |
| El disco de un nodo muere para siempre | Se sustituye el nodo; sus rangos se transmiten desde las otras réplicas; la reparación con Merkle lo verifica |
| Una zona de disponibilidad queda aislada | Con réplicas en varias zonas y W = 2, las escrituras continúan en el lado mayoritario; el minoritario puede seguir aceptando escrituras con quórums laxos, para reconciliarlas después |
| Desfase de reloj en un nodo | Con LWW, sus escrituras pueden ganar o perder de forma incorrecta. Monitoriza el desfase de reloj y alerta |
| Una clave caliente | Las réplicas de esa clave se sobrecargan; el particionado no lo arregla. Cachéala o rediseña la clave |
Chuleta de perillas
| Perilla | Valor típico | Súbela para | Bájala para |
|---|---|---|---|
| Factor de replicación N | 3 | Durabilidad, capacidad de lectura | Coste de almacenamiento |
| Quórum de escritura W | 2 | Durabilidad al confirmar | Latencia de escritura, disponibilidad |
| Quórum de lectura R | 2 | Lecturas más frescas | Latencia de lectura |
| Ventana de pistas | 3 horas | Cubrir caídas más largas con handoff | Disco usado por las pistas |
| Periodo de gracia de lápidas | 10 días | Seguridad frente a resurrecciones | Espacio y coste de lectura de las lápidas |
Lista de comprobación para producción
- Réplicas repartidas entre zonas de disponibilidad, no solo entre nodos
- Nivel de consistencia por defecto elegido por tabla y documentado para los llamantes
- Estrategia de conflictos explícita (LWW con relojes monitorizados, relojes vectoriales o CRDT)
- Ventana de hinted handoff y calendario de reparación alineados con el periodo de gracia de lápidas
- Reparación antientropía periódica en marcha y monitorizada
- Tasa de falsos positivos de los filtros de Bloom y SSTables por lectura vigiladas
- Estrategia de compactación elegida por carga; disco por debajo del ~60% para tener margen
- Paneles: p99 por operación y nivel de consistencia, pistas pendientes, progreso de la reparación, mutaciones descartadas
Lo que queda
Un almacén clave-valor es donde los sistemas distribuidos dejan de ser abstractos. Dos verbos y, aun así, aparecen todas las preguntas difíciles: qué copia es la real, cuánto esperar, qué hacer con el nodo que estuvo fuera una hora y tiene opiniones sobre el pasado.
Los mejores diseños no fingen que esas preguntas tienen una sola respuesta. Le dan al llamante una perilla y dejan escrito, con mucha claridad, qué promete cada posición y qué no.
Fuentes
- DeCandia et al., "Dynamo: Amazon's Highly Available Key-value Store" (SOSP 2007)
- Lakshman y Malik, "Cassandra: A Decentralized Structured Storage System"
- O'Neil et al., "The Log-Structured Merge-Tree (LSM-Tree)" (1996)
- Documentación de Apache Cassandra: hints, repair y compactación
- Abadi, "Consistency Tradeoffs in Modern Distributed Database System Design" (PACELC)
- Hayashibara et al., "The Phi Accrual Failure Detector"
- Relacionado en esta serie: Diseña consistent hashing, Diseña un generador de IDs únicos