TL;DR
- El problema: Un feed principal tiene que mostrar a cada usuario las publicaciones más nuevas y relevantes de cientos de cuentas a las que sigue, en menos de 200 ms, para cientos de millones de usuarios, mientras algunas cuentas tienen decenas de millones de seguidores.
- El diseño: Precalcular timelines empujando IDs de publicación a la lista de Redis de cada seguidor cuando se crea una publicación (fan-out en escritura), salvo para las cuentas muy grandes, cuyas publicaciones se obtienen y se mezclan en lectura. Un servicio de feed combina ambas fuentes, ordena candidatos, hidrata datos de publicaciones y usuarios desde cachés y pagina con cursores.
- El resultado: Leer el feed se convierte en una consulta barata a una lista más hidratación, las escrituras las absorben workers de forma asíncrona y el problema de las celebridades pasa de ser una tormenta de escrituras a una pequeña mezcla en lectura.
El news feed es el problema de diseño de sistemas que más premia una idea concreta. Todo lo demás (cachés, particionado, ranking) es reparto secundario. La idea es esta: tienes que decidir cuándo se hace el trabajo de montar un feed, en escritura o en lectura, y la respuesta es "en ambas, según quién publique".
Este artículo construye el feed alrededor de esa decisión.
Requisitos y cifras
Funcionales: los usuarios publican (texto, imágenes, vídeo); los usuarios ven un feed principal con publicaciones de las cuentas que siguen, primero lo más nuevo o lo más relevante; scroll infinito.
No funcionales: p99 de carga del feed por debajo de 200 ms; una publicación nueva aparece en los feeds de los seguidores en segundos (no necesariamente al instante); el sistema sigue en pie cuando publica una celebridad.
| Supuesto | Valor | Derivado |
|---|---|---|
| Usuarios activos diarios | 300M | |
| Cargas de feed por usuario y día | 10 | 3.000M lecturas/día, ~35k/s de media, ~100k/s en pico |
| Publicaciones al día | 50M | ~600/s de media |
| Seguidores medios por autor | 200 | 10.000M inserciones en timelines/día, ~115k/s |
| Longitud de timeline guardada | 800 IDs x 8 bytes | ~6,4 KB/usuario, ~2 TB en bruto para todos antes del sobrecoste de Redis |
Saltan dos cosas a la vista. Las lecturas del feed dominan el volumen de peticiones. Pero el fan-out multiplica las escrituras por el número de seguidores, así que las inserciones en timelines, no la creación de publicaciones, son la mayor carga de escritura. Cualquier diseño tiene que tenerlo en cuenta.
Twitter publicó cifras con esta misma forma en 2012: unas 300.000 lecturas de timeline por segundo frente a unos 6.000 tuits escritos por segundo, timelines principales limitados a 800 entradas en Redis y un fan-out que tardaba minutos para cuentas con decenas de millones de seguidores.
La decisión central: ¿cuándo se construye el feed?
| Fan-out en escritura (push) | Fan-out en lectura (pull) | |
|---|---|---|
| Cuándo se trabaja | Al publicar, empujar el ID a la timeline de cada seguidor | Al leer, traer publicaciones recientes de cada cuenta seguida y mezclar |
| Coste de lectura | Una lectura de lista | N consultas, una por cuenta seguida, más la mezcla |
| Coste de escritura | Una inserción por seguidor | Una inserción |
| Frescura | Segundos de retraso por el fan-out | Siempre fresco |
| Trabajo desperdiciado | Timelines para usuarios que nunca abren la app | Ninguno |
| Se rompe con | Celebridades con millones de seguidores | Usuarios que siguen a miles de cuentas |
Ninguno de los dos enfoques puros sobrevive al contacto con un grafo social real. Push convierte una publicación de una celebridad en decenas de millones de escrituras. Pull convierte cada carga de feed en cientos de consultas.
El híbrido al que convergen los sistemas en producción: push para cuentas normales, pull para un pequeño conjunto de cuentas muy grandes, y mezcla en lectura. Twitter describió exactamente esto. Multifeed de Facebook fue más allá hacia el montaje en lectura, con servidores agregadores que consultan almacenes de actividad por usuario cuando se pide el feed. Ambos son válidos; el híbrido es el más fácil de defender en una entrevista y de operar a escala moderada.
La ruta de publicación
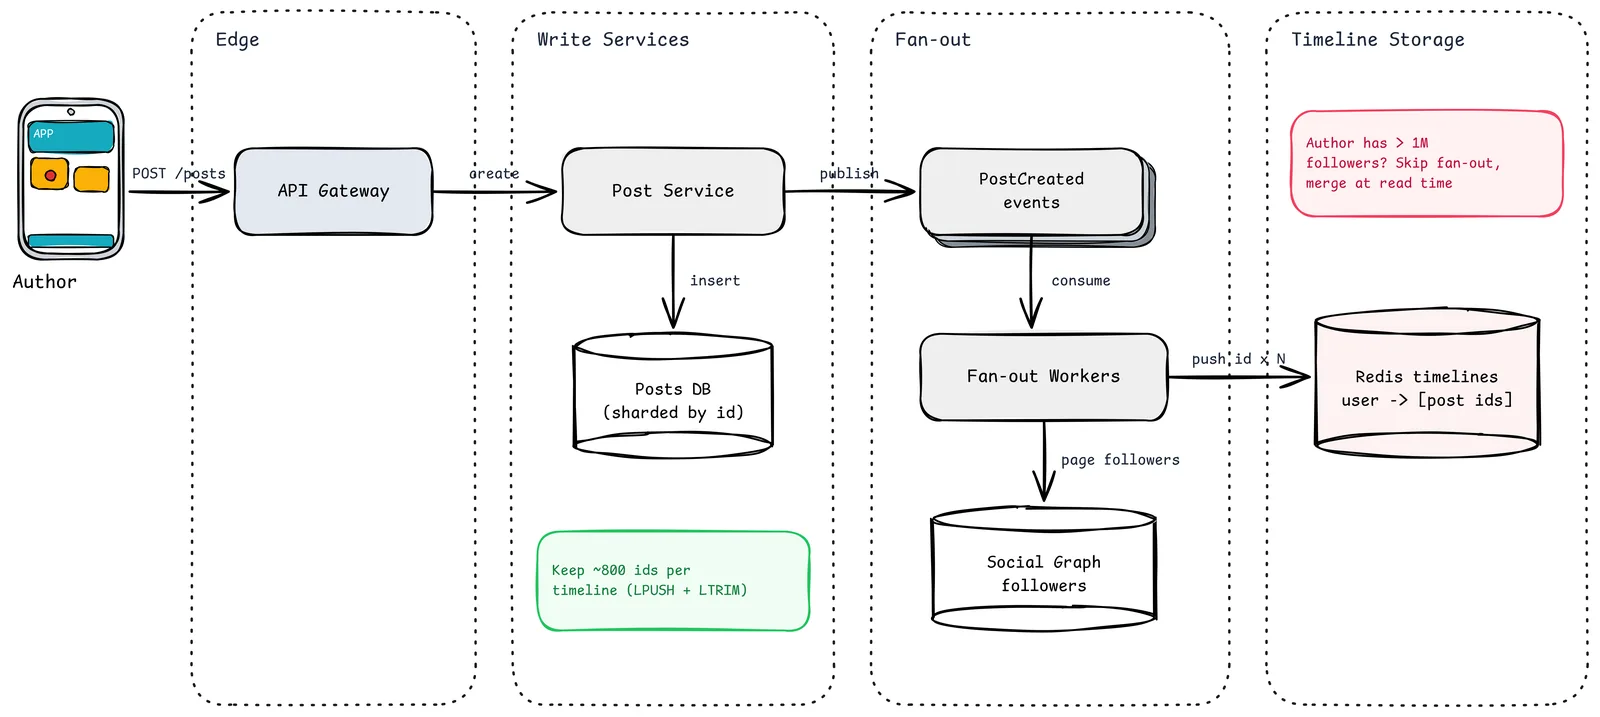
- Author. Publica. Los ficheros multimedia van primero directamente al almacenamiento de objetos (URLs prefirmadas); la publicación solo los referencia.
- API Gateway. Autenticación, limitación de tasa y validación de peticiones.
- Post Service. Asigna un ID ordenado por tiempo (estilo Snowflake, mira el artículo de IDs únicos), escribe la publicación y responde al usuario de inmediato. No espera al fan-out.
- Posts DB (particionada por id). Fuente de verdad del contenido. Los IDs ordenados por tiempo hacen que "publicaciones recientes del autor X" sea una consulta de rango barata con un índice sobre
(author_id, post_id). - Eventos PostCreated. Un log duradero desacopla la petición del usuario del costoso fan-out. Si el fan-out se retrasa, publicar sigue funcionando.
- Fan-out Workers. Consumen eventos, recorren los seguidores del autor en lotes de unos miles y empujan el ID a la timeline de cada uno. Pueden saltarse a los seguidores inactivos desde hace semanas; su feed se reconstruye bajo demanda si vuelven.
- Social Graph (seguidores). Un almacén optimizado para "quién sigue a X" y "a quién sigue Y". TAO de Facebook es el ejemplo canónico a gran escala. A menor escala basta una tabla particionada de aristas con dos índices.
- Timelines en Redis. Una lista por usuario con IDs recientes.
LPUSHdel nuevo ID yLTRIMa 800. Solo IDs, nunca publicaciones completas, para que editar o borrar una publicación no obligue a tocar millones de listas.
La nota roja es la regla de las celebridades: por encima de un umbral de seguidores (un millón es un buen punto de partida), se salta el fan-out y los lectores tiran de la publicación.
La ruta de lectura
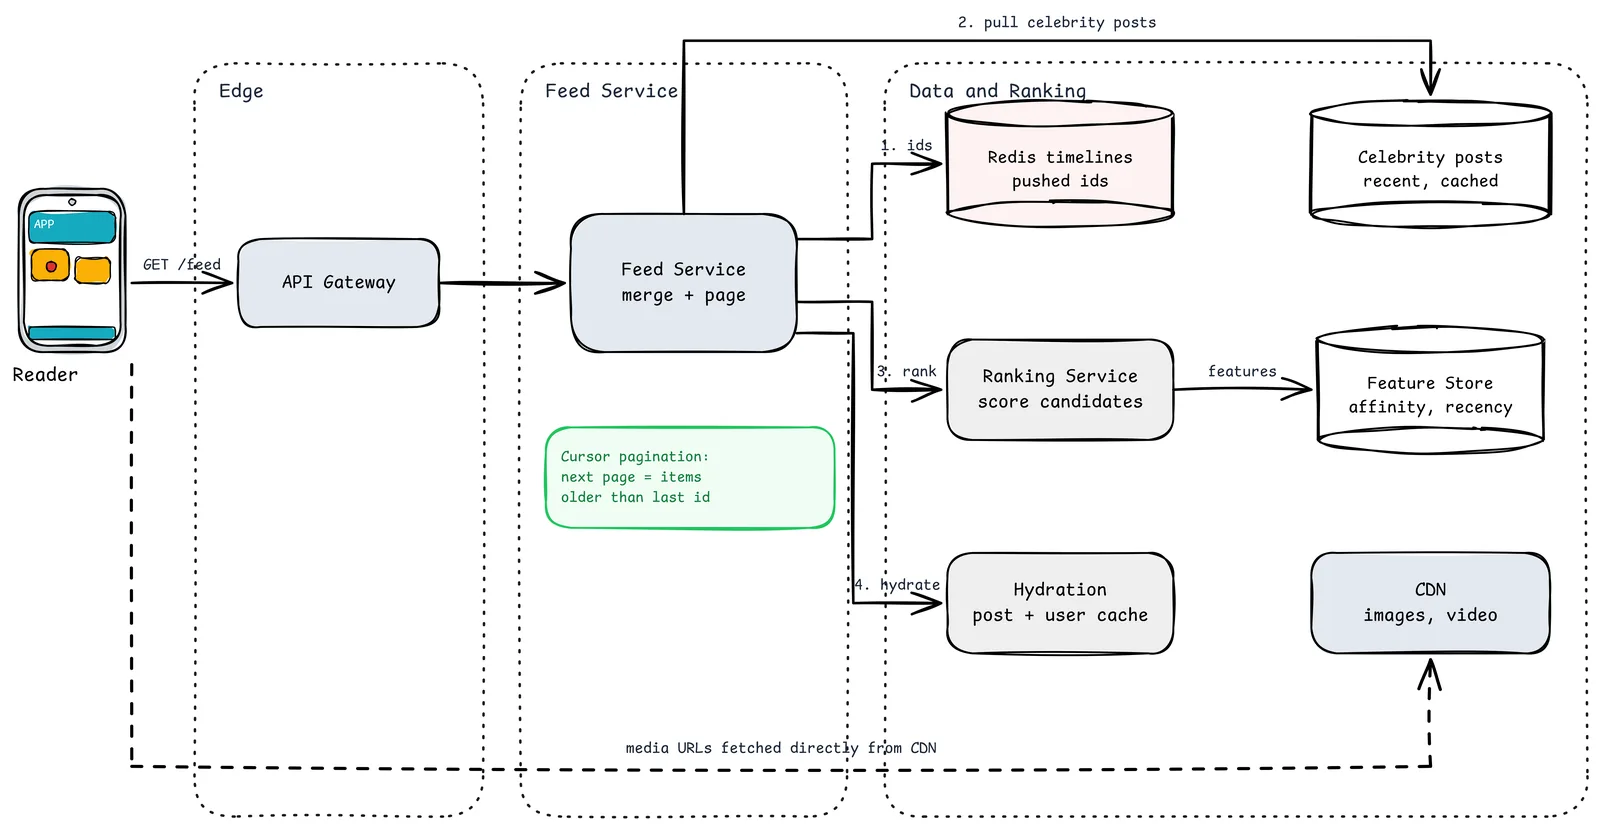
- Leer los IDs empujados de la timeline del usuario en Redis.
- Traer las publicaciones de celebridades. Para el puñado de cuentas grandes que sigue el usuario, obtener sus IDs recientes de un almacén muy cacheado de "publicaciones recientes por autor". Como muchos lectores siguen a las mismas celebridades, esta caché tiene una tasa de aciertos excelente.
- Ordenar. Juntar ambas listas en un conjunto de candidatos (unos cientos de publicaciones) y enviarlo al servicio de ranking, que puntúa con señales como afinidad con el autor, antigüedad, interacción acumulada y tipo de contenido.
- Hidratar. Traer cuerpos de publicación, perfiles de autor y contadores de los mejores resultados desde cachés en una sola llamada por lotes.
- Devolver una página con un cursor. Las URLs multimedia apuntan al CDN, así que imágenes y vídeos nunca pasan por el servicio de feed.
La nota verde cubre la paginación, fácil de hacer mal. Usa cursores, no offsets. Con offsets, una publicación nueva que llega entre la página 1 y la 2 lo desplaza todo una posición y los usuarios ven duplicados. Con un cursor ("publicaciones más antiguas que el ID X", o un token opaco que codifica la posición del ranker), las páginas son estables.
Ranking, de lo simple a lo real
| Etapa | Enfoque | Coste |
|---|---|---|
| Versión 1 | Cronológico inverso por ID de publicación | Nada. Los IDs ordenados por tiempo lo hacen gratis |
| Versión 2 | Puntuación heurística: afinidad x peso del contenido x decaimiento temporal | Unas pocas señales por candidato; fácil de explicar |
| Versión 3 | Ranking de ML en dos etapas: generación barata de candidatos y luego un modelo aprendido sobre unos cientos | Feature store, servicio de modelos, plataforma de experimentación |
El primer EdgeRank de Facebook era una heurística de versión dos con exactamente esta forma. La mayoría de grandes feeds hoy son versión tres. En una entrevista, empieza con la versión uno, describe la dos y menciona que existe la tres. No diseñes el sistema de ML salvo que te lo pidan.
Sea cual sea el ranking, mantenlo fuera de la ruta de escritura. Depende del lector, de la hora del día y de interacciones que todavía no han ocurrido, así que pertenece a la lectura.
Esbozo del modelo de datos
| Almacén | Clave | Valor | Notas |
|---|---|---|---|
| Posts DB | post_id |
autor, texto, referencias multimedia, created_at | Índice sobre (author_id, post_id) para las timelines de autor |
| Grafo social | (follower_id, followee_id) |
created_at | Ambas direcciones indexadas: seguidores de X, seguidos por Y |
| Timeline en Redis | timeline:{user_id} |
lista de IDs | Limitada a 800; TTL para usuarios inactivos |
| Caché de publicaciones | post:{post_id} |
publicación serializada | Escritura directa al crear, invalidada al editar o borrar |
| Contadores | post:{post_id}:likes |
entero | Separados del cuerpo; se actualizan de forma asíncrona |
Qué sale mal
| Problema | Síntoma | Solución |
|---|---|---|
| Publicaciones de celebridades | La cola de fan-out se atasca durante minutos | Umbral de seguidores; pull en lectura |
| Publicación caliente | Los contadores y la clave de caché de una publicación se saturan | Contadores particionados; caché local; recuentos aproximados |
| Publicación borrada que sigue visible | Los IDs siguen en millones de timelines | Filtrar al hidratar: se descartan publicaciones inexistentes o borradas |
| Retraso del fan-out | Las publicaciones nuevas aparecen tarde | Priorizar el fan-out a los seguidores activos recientemente |
| Pérdida de un nodo de Redis | Algunas timelines vacías | Reconstruir bajo demanda tirando de los autores seguidos; réplicas de Redis |
| Usuarios que siguen a miles | Mezclas grandes si muchos son "celebridades" | Limitar los autores obtenidos por pull; confiar en push para el resto |
| El feed muestra dos veces la misma publicación | Paginación por offset | Paginación por cursor |
Cierre de entrevista
Una respuesta sólida encaja en este orden:
- Requisitos y cifras de lectura y escritura, incluido el multiplicador del fan-out.
- Tabla push frente a pull, y por qué ninguno basta solo.
- Híbrido con umbral de celebridades.
- Ruta de publicación con workers de fan-out asíncronos y timelines solo de IDs.
- Ruta de lectura: mezclar, ordenar, hidratar, cursor.
- Uno o dos modos de fallo (celebridades, borrados).
Lista de comprobación para producción
- El fan-out es asíncrono; publicar nunca lo espera
- Las timelines guardan solo IDs, con longitud limitada y TTL para usuarios inactivos
- Umbral de celebridades configurado y vigilado (retraso del fan-out por tamaño de autor)
- Seguidores inactivos omitidos en el fan-out; la reconstrucción bajo demanda funciona
- La hidratación filtra contenido borrado, privado y bloqueado
- Paginación basada en cursores
- Ranking aislado de la ruta de escritura, con orden cronológico de respaldo si el ranker cae
- Paneles: p99 del feed, retraso de la cola de fan-out, tasa de aciertos de la caché de timelines, tamaño de los lotes de hidratación
Lo que queda
El feed es el lugar donde la desigualdad de tu grafo social se convierte en un problema de ingeniería. La mayoría de la gente tiene unos cientos de seguidores. Unos pocos tienen decenas de millones. Un solo diseño no sirve para ambos, así que construyes dos y los coses en el último momento posible.
Ahora mismo, en algún punto de la cola de fan-out, hay una publicación de alguien con diez seguidores esperando detrás de una estrella del pop. El híbrido existe para que esa publicación también llegue a tiempo.
Fuentes
- High Scalability: The Architecture Twitter Uses to Deal with 150M Active Users, 300K QPS (charla de Raffi Krikorian)
- Bronson et al., "TAO: Facebook's Distributed Data Store for the Social Graph" (USENIX ATC 2013)
- Facebook Engineering: Serving Facebook Multifeed
- Documentación de Redis: listas (LPUSH, LTRIM)
- Relacionado en esta serie: Diseña un generador de IDs únicos, Diseña un sistema de chat, Escala de cero a millones