TL;DR
- El problema: Descargar mil millones de páginas al mes de millones de sitios independientes, sin sobrecargar a ninguno, sin bajar dos veces lo mismo, sin quedarse atrapado en espacios infinitos de URLs y volviendo a visitar las páginas que cambian.
- El diseño: Un ciclo de frontera, descarga, almacenamiento, análisis, filtrado, deduplicación y vuelta a la frontera. La frontera tiene colas de prioridad delante y una cola por host detrás, regidas por un montículo con la "próxima hora permitida de descarga", así que la cortesía se cumple por construcción. Las comprobaciones de URLs vistas usan un filtro de Bloom respaldado por un almacén clave-valor; el contenido casi duplicado se detecta con SimHash.
- El resultado: Unas 400 páginas por segundo sostenidas con una flota modesta, cada host contactado como mucho una vez cada pocos segundos, y el esfuerzo de rastreo dedicado a páginas nuevas, importantes o con probabilidad de haber cambiado.
Un rastreador parece el programa más sencillo de esta serie: descarga una página, encuentra sus enlaces, descarga esos. Escribir ese bucle lleva diez minutos. Ejecutarlo contra la web real durante una semana te enseña todo lo demás: servidores que se ralentizan cuando eres maleducado, calendarios con infinitos enlaces de "mes siguiente", un millón de páginas que son la misma con distintos IDs de sesión y dueños de sitios que te escriben.
Este artículo diseña un rastreador de propósito general como los que alimentan un índice de búsqueda o un gran corpus de investigación como Common Crawl.
Requisitos y cifras
Funcionales: partir de URLs semilla, descubrir y descargar páginas HTML, guardar el contenido en bruto, extraer enlaces, respetar robots.txt y volver a visitar páginas con el tiempo.
No funcionales: cortesía (no sobrecargar nunca un sitio), robustez frente a HTML mal formado y espacios de URLs hostiles, escalar a miles de millones de páginas y ampliable a nuevos tipos de contenido.
| Supuesto | Valor | Derivado |
|---|---|---|
| Páginas al mes | 1.000 millones | ~385 páginas/s de media |
| Página HTML media | ~100 KB | ~100 TB/mes en bruto, unas pocas decenas de TB comprimidos |
| Tiempo medio de descarga | ~500 ms | ~200 descargas simultáneas mantienen el ritmo; planifica miles para tener margen |
| Enlaces por página | ~50 | ~20.000 URLs candidatas nuevas/s antes de deduplicar |
| URLs vistas en un año | Decenas de miles de millones | El conjunto de URLs vistas no cabe ingenuamente en la memoria de una máquina |
Las cifras interesantes no son el ancho de banda. Son las 20.000 URLs candidatas por segundo que necesitan una respuesta a "¿ya he visto esto?" y los millones de hosts que necesitan cada uno su propio límite de ritmo.
El pipeline
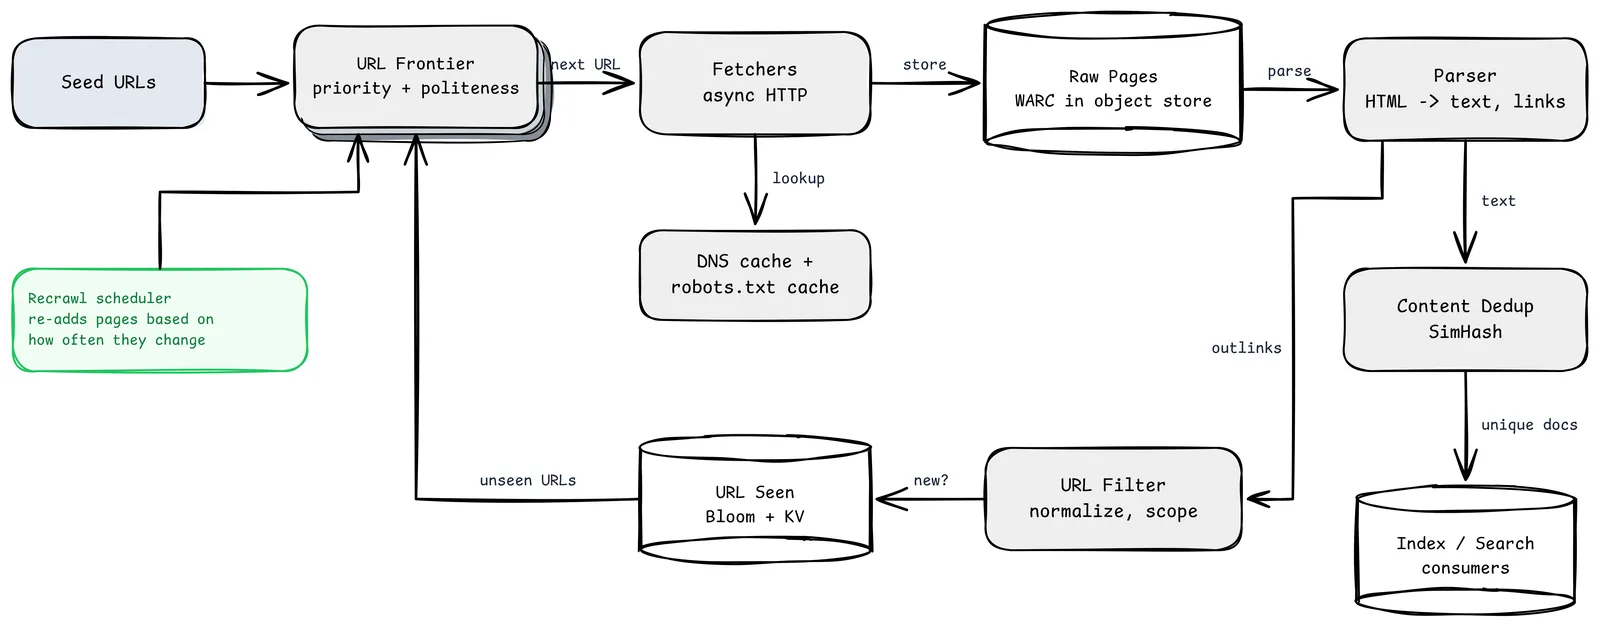
- Seed URLs. Un conjunto inicial de sitios conocidos y de calidad. Su calidad da forma a todo el rastreo.
- URL Frontier. La lista de tareas. Decide tanto qué descargar después (prioridad) como cuándo puede contactarse cada host (cortesía). Es el corazón del diseño y tiene su propio diagrama más abajo.
- Fetchers (HTTP asíncrono). Miles de conexiones simultáneas desde unas pocas máquinas con IO no bloqueante. Timeouts, límites de tamaño y de redirecciones en cada petición. Identifícate con un user agent claro y una URL de contacto.
- Caché de DNS y de robots.txt. Las consultas DNS pueden convertirse fácilmente en el cuello de botella a cientos de descargas por segundo, así que se cachean de forma agresiva. Descarga el
robots.txtde cada host una vez, cachéalo un día más o menos y comprueba cada URL contra él antes de descargarla. La RFC 9309 (2022) estandarizó por fin el protocolo de exclusión de robots. - Raw Pages (WARC en almacenamiento de objetos). Guarda exactamente lo que descargaste, con cabeceras, en ficheros WARC (el formato de archivo que usan Common Crawl y el Internet Archive). El análisis puede repetirse después; la descarga no.
- Parser. Convierte HTML en texto y enlaces, resuelve URLs relativas y sobrevive al marcado roto.
- Content Dedup (SimHash). Muchas URLs sirven contenido idéntico o casi idéntico (espejos, vistas de impresión, parámetros de seguimiento). Una huella SimHash de 64 bits permite detectar casi duplicados comparando la distancia de Hamming; Google describió exactamente esto en su artículo de 2007 sobre rastreo.
- URL Filter. Normaliza URLs (host en minúsculas, sin puertos por defecto ni fragmentos, parámetros de seguimiento ordenados o eliminados), aplica reglas de alcance y bloquea trampas conocidas.
- URL Seen (Bloom + KV). Un filtro de Bloom responde "seguro que no vista" en memoria; los "quizá" se confirman contra un almacén clave-valor persistente indexado por un hash de la URL normalizada.
- Consumidores de índice o búsqueda. Los documentos únicos van a quien use el rastreo.
- Planificador de re-rastreo. Devuelve URLs conocidas a la frontera según la frecuencia con que cambian.
La frontera: prioridad delante, cortesía detrás
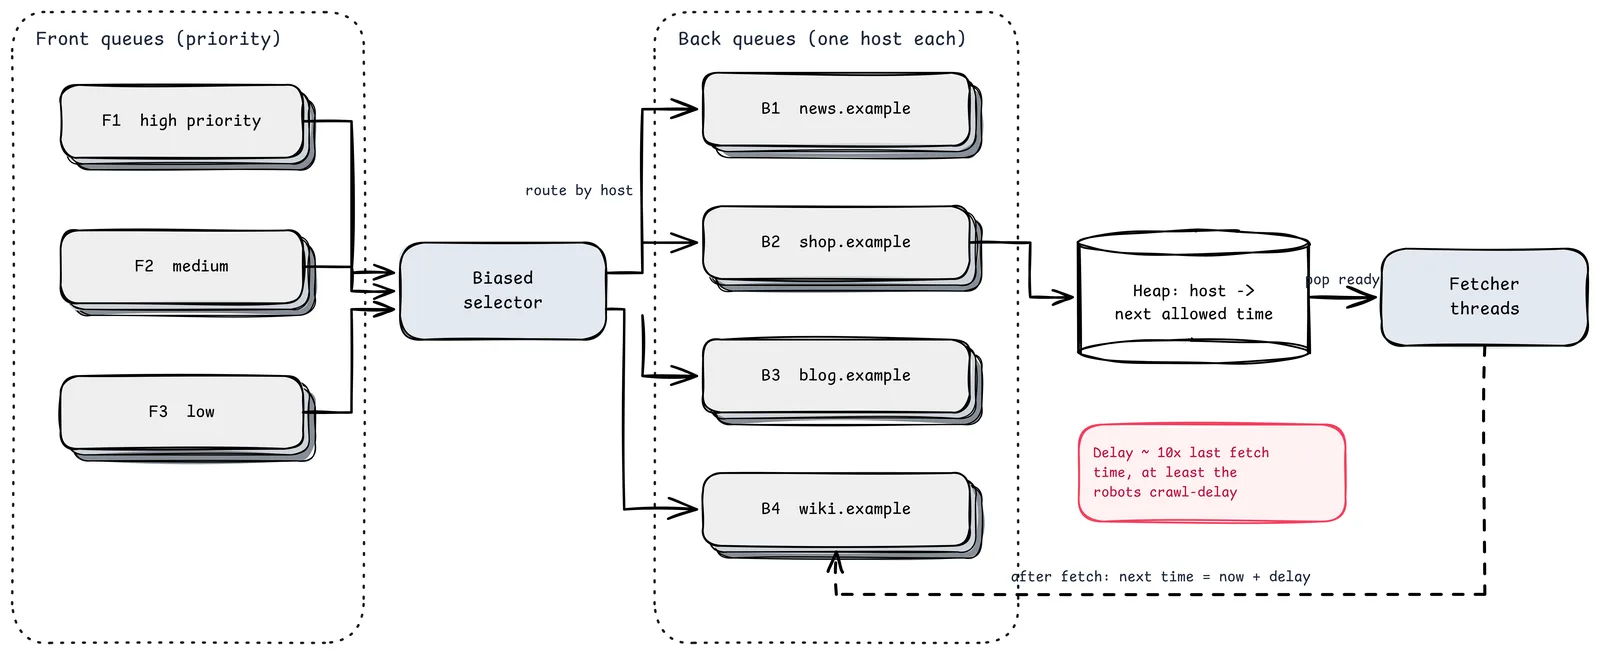
Este diseño en dos etapas viene del rastreador Mercator (Heydon y Najork, 1999) y sigue siendo la respuesta estándar:
- Las colas delanteras guardan URLs por prioridad. La prioridad puede venir de una importancia al estilo PageRank, de la necesidad de frescura o simplemente de la calidad del dominio.
- Un selector sesgado saca de las colas delanteras favoreciendo la prioridad alta sin dejar morir de hambre a la baja.
- Las URLs se enrutan a colas traseras, con exactamente un host por cola trasera. Todas las URLs de
news.exampleesperan en la misma fila. - Un montículo guarda una entrada por cola trasera: el primer momento en que puede volver a contactarse ese host.
- Los hilos de descarga sacan el host cuyo momento ha llegado, descargan una URL de su cola y lo devuelven con una hora nueva: ahora más un retardo, habitualmente un múltiplo (por ejemplo 10 veces) de lo que tardó la última descarga, y nunca menos que el crawl-delay que pida el sitio.
La nota roja es toda la política de cortesía en una línea. Un servidor lento recibe automáticamente más respiro, porque sus descargas tardan más y su retardo crece.
Repartir la frontera entre máquinas es sencillo una vez ves esta estructura: particiona por host (hash del nombre de host), de modo que la cola trasera y el estado de cortesía de cada host vivan en exactamente una máquina.
Trampas y otros territorios hostiles
| Trampa | Ejemplo | Defensa |
|---|---|---|
| Espacios infinitos de URLs | Calendario con enlaces de "mes siguiente" sin fin | Profundidad y longitud máximas de URL; presupuesto de páginas por host |
| IDs de sesión y parámetros de seguimiento | ?sid=abc123 hace única cada URL |
Reglas de normalización; aprendizaje de parámetros por host |
| Falsos 404 | Páginas de "no encontrado" servidas con estado 200 | La deduplicación de contenido detecta la plantilla repetida |
| Respuestas enormes o binarias | Un fichero de 2 GB en una URL con pinta de HTML | Comprobación de tipo de contenido, topes de tamaño, streaming con corte temprano |
| Servidores de goteo lento | Respuestas que sueltan un byte por segundo | Timeouts de tiempo total, no solo de conexión |
| Spam y granjas de enlaces | Millones de páginas autogeneradas | Señales de calidad en la prioridad; presupuestos por dominio |
El presupuesto de páginas por host es la defensa individual más eficaz. Ningún sitio recibe más de lo que le toca, por muchos enlaces que genere.
Re-rastreo: la frescura es un presupuesto
Las páginas cambian a ritmos muy distintos. La portada de un periódico cambia cada pocos minutos; un artículo archivado no cambia nunca. Descargarlo todo en un ciclo fijo desperdicia la mayor parte del presupuesto.
- Guarda el historial de cambios por URL (¿cambió el SimHash desde la última descarga?).
- Estima una tasa de cambio y programa la próxima visita en proporción, entre un intervalo mínimo y uno máximo.
- Usa peticiones condicionales (
If-Modified-Since,If-None-Match) para que una página sin cambios cueste un304en lugar de una descarga completa. - Da intervalos más cortos a las páginas importantes; deja envejecer la cola larga.
- Usa los sitemaps cuando los sitios los ofrezcan, porque suelen incluir fechas de última modificación.
Ser un buen ciudadano
- Respeta
robots.txt, incluidas las reglas de exclusión para tu user agent y cualquier crawl-delay. - Identifica el rastreador en el user agent con una URL que explique qué es y cómo excluirse.
- Publica los rangos de IP desde los que rastreas, para que los operadores puedan verificarte.
- Retírate ante
429y503, y respetaRetry-After. - Ofrece una dirección de contacto y léela de verdad.
La tolerancia de la web hacia los rastreadores es un bien común. Cada rastreador maleducado hace que los operadores bloqueen con más agresividad a todos.
Lista de comprobación para producción
- La frontera garantiza un host por cola trasera con un montículo de próxima hora permitida
- robots.txt descargado, cacheado y comprobado antes de cada URL; semántica de la RFC 9309
- DNS cacheado; timeouts por petición de conexión, primer byte y tiempo total
- Reglas de normalización y alcance de URLs versionadas y probadas
- Comprobación de URLs vistas con filtro de Bloom y almacén persistente
- Detección de casi duplicados con SimHash o similar
- Presupuestos de páginas por host y por dominio; límites de profundidad y longitud de URL
- Respuestas en bruto guardadas como WARC antes de analizar
- Re-rastreo planificado según la tasa de cambio observada; peticiones condicionales
- Paneles: páginas/s, tasas de error por clase, hosts en espera, tamaño de la frontera, tasa de duplicados
Lo que queda
Un rastreador es un invitado en millones de casas a la vez. La ingeniería trata de velocidad, pero la reputación trata de modales: llama a la puerta, espera, no vuelvas demasiado a menudo, vete cuando te lo pidan.
En algún lugar hay un pequeño blog en un servidor barato que tu rastreador visita cada pocos días. Nunca sabrá tu nombre. Y tampoco debería notar nunca que estuviste allí.
Fuentes
- Heydon y Najork, "Mercator: A Scalable, Extensible Web Crawler" (1999)
- Manku, Jain y Das Sarma, "Detecting Near-Duplicates for Web Crawling" (WWW 2007)
- RFC 9309: Robots Exclusion Protocol
- Common Crawl: descripción general y datos WARC
- ISO 28500: formato de fichero WARC (descripción de la Biblioteca del Congreso)
- Relacionado en esta serie: Diseña un autocompletado de búsqueda, Estimaciones de servilleta, Cómo funciona el DNS