TL;DR
- El problema: Las discusiones de diseño se atascan en adjetivos ("mucho tráfico", "ficheros grandes") porque nadie los ha convertido en cifras. Sin cifras no puedes saber si necesitas una base de datos o cien, o si las imágenes pueden servirse desde tus propios servidores.
- El método: Memoriza unas pocas constantes (un día son unos 10^5 segundos, potencias de dos, latencias aproximadas) y aplica cinco recetas: consultas por segundo, almacenamiento, ancho de banda, tamaño de caché y número de servidores. Redondea sin miedo, enuncia cada supuesto y para en cuanto las cifras hacen obvia una decisión.
- El resultado: En cinco minutos sabes qué parte del sistema es difícil. En el ejemplo de abajo, las cuentas muestran que las imágenes deben pasar por un CDN y un almacenamiento de objetos mucho antes de dibujar una sola caja.
Estimar no consiste en acertar. Consiste en acertar con un margen de unas pocas veces, rápido, para que la conversación de diseño se centre en lo que importa.
Un sistema que necesita 50 escrituras por segundo y otro que necesita 50.000 son sistemas distintos. Un conjunto de datos de 50 GB cabe en RAM; uno de 50 TB no. No hace falta precisión para distinguirlos. Hace falta el orden de magnitud y la disciplina de apuntarlo.
Constantes que merece la pena memorizar
Tiempo
| Magnitud | Valor aproximado |
|---|---|
| Segundos en un día | 86.400, tómalo como 10^5 |
| Segundos en un mes | ~2,6 millones, tómalo como 2,5 x 10^6 |
| Segundos en un año | ~31,5 millones, tómalo como 3 x 10^7 |
Tamaños
| Potencia de dos | Aproximadamente | Unidad |
|---|---|---|
| 2^10 | mil | KB |
| 2^20 | un millón | MB |
| 2^30 | mil millones | GB |
| 2^40 | un billón | TB |
| 2^50 | mil billones | PB |
Latencia (órdenes de magnitud)
| Operación | Tiempo aproximado |
|---|---|
| Acceso a memoria principal | ~100 ns |
| Leer 1 MB secuencial de memoria | unos pocos µs |
| Lectura aleatoria en SSD | decenas de µs |
| Viaje de ida y vuelta dentro de un centro de datos | ~0,5 ms |
| Leer 1 MB secuencial de SSD | de decenas de µs a ~1 ms |
| Búsqueda en disco giratorio | ~5 a 10 ms |
| Viaje de ida y vuelta cruzando un océano | ~100 a 150 ms |
Salen de la clásica lista de "números de latencia que todo programador debería conocer" que popularizaron Jeff Dean y Peter Norvig y que después se ha actualizado para el hardware moderno. Los valores exactos cambian; lo que importa son las proporciones. La memoria es mil veces más rápida que un viaje de red, que a su vez es cien veces más rápido que cruzar un océano.
Disponibilidad
| Disponibilidad | Inactividad al año | Inactividad al mes |
|---|---|---|
| 99% | ~3,65 días | ~7,3 horas |
| 99,9% | ~8,8 horas | ~44 minutos |
| 99,99% | ~53 minutos | ~4,4 minutos |
| 99,999% | ~5,3 minutos | ~26 segundos |
Cada nueve adicional cuesta más o menos un orden de magnitud más de ingeniería. Cuatro nueves significa que una persona no puede estar en el bucle de la mayoría de incidentes; la recuperación tiene que ser automática.
Las cinco recetas
- QPS. Eventos diarios divididos entre 10^5. Después, multiplica por un factor de pico (2x para tráfico global uniforme, de 5 a 10x para productos de consumo con picos).
- Almacenamiento. Elementos al día x tamaño por elemento x periodo de retención x sobrecoste de replicación o codificación.
- Ancho de banda. QPS x tamaño de la respuesta, por separado para lecturas y escrituras.
- Caché. Supón que el 20% de los elementos recibe el 80% de las lecturas; dimensiona la caché para el 20% caliente del conjunto de trabajo de un día.
- Servidores. QPS de pico dividido entre lo que aguanta un servidor, más margen (apunta a un 50-70% de uso en pico).
Un ejemplo completo: una app para compartir fotos
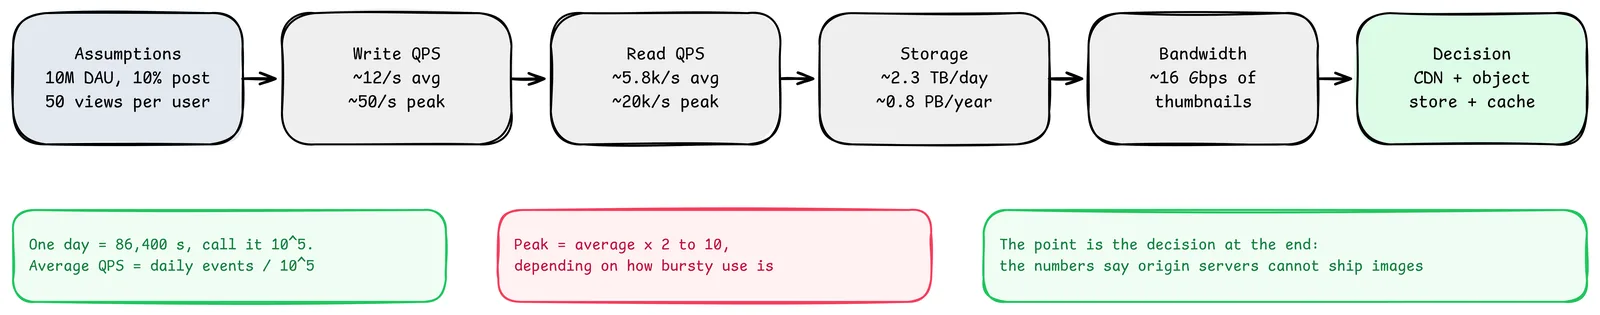
Supuestos (dilos en voz alta; el entrevistador o tu equipo pueden cambiarlos):
- 10M de usuarios activos al día.
- El 10% publica una foto al día.
- Cada usuario ve 50 fotos al día.
- Cada subida se guarda como un original de 2 MB más miniaturas, unos 2,3 MB en total.
- Cada visualización carga una miniatura de ~100 KB.
QPS de escritura: 1M de subidas al día / 10^5 ≈ 10 a 12 por segundo de media. Con un pico de 4x, unas 50 por segundo. Las escrituras no son el problema.
QPS de lectura: 10M x 50 = 500M de visualizaciones al día / 10^5 ≈ 5.800 por segundo, unas 20.000 por segundo en pico. Las lecturas son entre 400 y 500 veces las escrituras.
Almacenamiento: 1M x 2,3 MB ≈ 2,3 TB al día, unos 0,8 PB al año antes de replicar. Con replicación 3x son unos 2,5 PB al año; con códigos de borrado (alrededor de 1,5x de sobrecoste), unos 1,2 PB. Los metadatos a 1 KB por foto son solo 1 GB al día: nada al lado de las imágenes.
Ancho de banda: 20.000 miniaturas por segundo x 100 KB ≈ 2 GB/s ≈ 16 Gbps en pico, solo en miniaturas.
Lo que deciden las cifras:
- Las imágenes van a almacenamiento de objetos, no a una base de datos. Petabytes de blobs no pertenecen a filas.
- Las imágenes se sirven desde un CDN. Dieciséis gigabits por segundo desde servidores de origen serían caros y lentos para usuarios lejanos; un CDN sirve casi todo desde el borde.
- La base de datos de metadatos es modesta. Una principal con réplicas de lectura y una caché aguanta 20.000 lecturas por segundo sin problema, sobre todo porque el CDN absorbe el tráfico de imágenes.
- Las escrituras son pocas, así que una ruta de escritura sencilla y consistente basta. No hace falta un escalado de escrituras exótico.
Esa última lista es todo el sentido del ejercicio. La caja verde del diagrama es el resultado; todo lo anterior es cómo te ganaste el derecho a decirlo.
Número de servidores sin fingir
¿Cuántas peticiones aguanta un servidor? Depende muchísimo del trabajo de cada petición, así que usa rangos y dilo:
| Componente | Capacidad aproximada por nodo (operaciones sencillas) |
|---|---|
| Servidor de aplicación sin estado, API JSON sencilla | ~1.000 a 10.000 peticiones/s |
| Redis o memcached | ~100.000+ operaciones sencillas/s |
| Base de datos relacional, lecturas puntuales indexadas | de miles a decenas de miles/s, muy dependiente de la carga |
| Borde de CDN | prácticamente ilimitado desde tu punto de vista |
Con 20.000 peticiones por segundo en pico y 2.000 por servidor de aplicación con un uso saludable, necesitas unos 10 servidores, más unos cuantos de margen y para despliegues. Mide tu propio servicio con una prueba de carga antes de fiarte de cualquiera de estas cifras en producción.
Errores que vuelven inútiles las estimaciones
- Falsa precisión. "11,574 QPS" indica que no has entendido el objetivo. Di "unas 10".
- Olvidar el pico. Las medias esconden la hora en la que todo el mundo abre la app.
- Olvidar la replicación y el sobrecoste. Tres réplicas triplican el almacenamiento. Índices, logs y copias de seguridad suman más.
- Mezclar bits y bytes. Los enlaces de red se expresan en bits por segundo; el almacenamiento en bytes. Divide entre 8.
- Estimarlo todo. Para cuando las cifras hayan tomado la decisión. No necesitas tasas de aciertos de caché para saber que las imágenes van a un CDN.
- No enunciar los supuestos. Una estimación sin sus supuestos no se puede comprobar ni corregir.
Cómo practicar
Elige una app que uses a diario y estima en cinco minutos su QPS de escritura, su QPS de lectura y su almacenamiento anual. Después busca cifras públicas (blogs de ingeniería, presentaciones de resultados, charlas) y mira cuánto te has desviado. Tras diez ejercicios así, tu intuición para los órdenes de magnitud se vuelve fiable, y esa es la habilidad que evalúan las entrevistas y las revisiones de diseño.
Lo que queda
La mejor estimación que he hecho se equivocó por un factor de tres y no importó, porque acertó en lo único que tenía que acertar: la base de datos no iba a ser el problema y el ancho de banda de las imágenes sí.
Eso es todo lo que es estimar. Una servilleta, unas cuantas potencias de diez y el valor de decir "esta parte es fácil, esa no" antes de que nadie haya dibujado una caja.
Fuentes
- Jeff Dean, "Designs, Lessons and Advice from Building Large Distributed Systems" (números de latencia)
- Colin Scott: Latency numbers every programmer should know (interactivo, actualizado por año)
- Libro de SRE de Google: Embracing Risk (disponibilidad y presupuestos de error)
- Backblaze: códigos de borrado y sobrecoste de almacenamiento
- Relacionado en esta serie: Escala de cero a millones, Un marco práctico para entrevistas de diseño de sistemas, Diseña un acortador de URL