TL;DR
- El problema: Un limitador de tasa debe decidir si permite o rechaza cada petición, de forma coherente en toda una flota de gateways, añadiendo bastante menos de un milisegundo de latencia y sin convertirse en la caída que pretendía evitar.
- El diseño: Aplicarlo en el API gateway. Construir la clave por tenant, usuario, IP y ruta. Ejecutar un token bucket como un único script Lua atómico contra un clúster Redis particionado, cachear localmente las claves calientes y decidir por endpoint si un fallo del limitador falla abierto o cerrado. Devolver
429conRetry-Aftery cabeceras de límite legibles por máquina.- El resultado: Un viaje a Redis por petición, límites justos entre muchos nodos de gateway, un comportamiento elegante cuando Redis va lento y límites que los clientes pueden entender.
Toda API pública acaba aprendiendo la misma lección: el bucle de reintentos de un cliente es la caída de otro. Un limitador de tasa es el seguro más barato que puedes comprar contra eso y, como casi todos los seguros, solo importa el peor día del año.
Este artículo diseña uno como lo harías para una plataforma de API real. Tiene opinión sobre los algoritmos, es preciso con la implementación en Redis y honesto sobre lo que se rompe.
Para qué sirve realmente un limitador de tasa
Cuando la gente dice "rate limiting" se refiere a cuatro cosas distintas. El conocido artículo de Stripe sobre sus limitadores las separa con claridad, y la distinción sigue vigente:
| Tipo de limitador | Pregunta que responde | Regla típica |
|---|---|---|
| Limitador de tasa de peticiones | ¿Este cliente envía demasiadas peticiones por unidad de tiempo? | 100 peticiones por segundo por clave de API |
| Limitador de peticiones concurrentes | ¿Este cliente tiene demasiadas peticiones en vuelo? | 20 búsquedas caras concurrentes por usuario |
| Recorte de carga de la flota | ¿Está todo el sistema cerca de su capacidad? | Reservar el 20% de la capacidad para tráfico crítico |
| Recorte por uso de workers | ¿Está saturado este grupo concreto de workers? | Descartar trabajos de baja prioridad cuando el grupo está al 90% |
Este artículo se centra en el primero, que es lo que quieren decir los entrevistadores y la mayoría de equipos de producto. Merece la pena nombrar los otros tres, porque un limitador de tasa por sí solo no te salvará de un único cliente que lanza unas pocas consultas carísimas.
Requisitos y presupuesto
- Decidir añadiendo menos de 1 ms de latencia p99 en el gateway.
- Aplicar los límites de forma global entre muchos nodos de gateway, no por nodo.
- Soportar reglas por tenant, usuario, clave de API, IP y ruta, con distintos niveles (gratuito, pro, empresa).
- Tolerar ráfagas legítimas (una página que lanza 15 llamadas de API al cargar) sin dejar pasar el abuso sostenido.
- Degradarse de forma predecible cuando el almacén de estado del propio limitador va lento o está caído.
- Decir a los clientes cuándo reintentar.
Con 200.000 peticiones por segundo en la flota, un viaje al almacén de estado por petición son 200.000 operaciones por segundo. Un único fragmento de Redis gestiona sin problema del orden de 100.000 operaciones simples por segundo, así que planifica un clúster particionado con margen, más una caché local para las claves más calientes.
Elegir el algoritmo
| Algoritmo | Cómo funciona | Comportamiento ante ráfagas | Memoria por clave | Precisión | Dónde se ve |
|---|---|---|---|---|---|
| Ventana fija | Cuenta peticiones por ventana de calendario (por ejemplo, por minuto) | Permite el doble del límite en el cambio de ventana | Un contador | Baja en los bordes | Cuotas simples, topes diarios |
| Registro deslizante | Guarda cada marca de tiempo y cuenta las de la última ventana | Sin ráfaga en el borde | Una entrada por petición | Exacta | Endpoints de poco volumen y mucho valor |
| Contador de ventana deslizante | Mezcla ponderada de la ventana fija actual y la anterior | Suaviza los bordes | Dos contadores | Aproximada, muy cercana en la práctica | Cloudflare describió este enfoque para su limitación en el borde |
| Token bucket | Cubo de capacity fichas que se rellena a rate; cada petición gasta fichas |
Permite ráfagas hasta la capacidad y luego un ritmo constante | Dos números | Exacta para su modelo | API gateways, APIs de proveedores cloud |
| Leaky bucket | Las peticiones se encolan y salen a ritmo fijo | Suaviza la salida, añade latencia | Cola | Exacta | Modelado de tráfico |
| GCRA | Sigue un único "tiempo teórico de llegada" | Igual que el token bucket | Una marca de tiempo | Exacta | Herencia de telecomunicaciones; librerías como redis-cell |
Mi opción por defecto es el token bucket. Expresa los dos números que de verdad importan a los equipos de producto (ritmo sostenido y tamaño de ráfaga), cuesta dos campos por clave y es fácil de explicar a los clientes: "100 por segundo, con ráfagas de hasta 200".
Merece la pena decir en voz alta en una entrevista el problema de borde de la ventana fija: con un límite de 100 por minuto, un cliente puede enviar 100 peticiones a las 12:00:59 y otras 100 a las 12:01:00, es decir, 200 peticiones en dos segundos.
Dónde vive el limitador
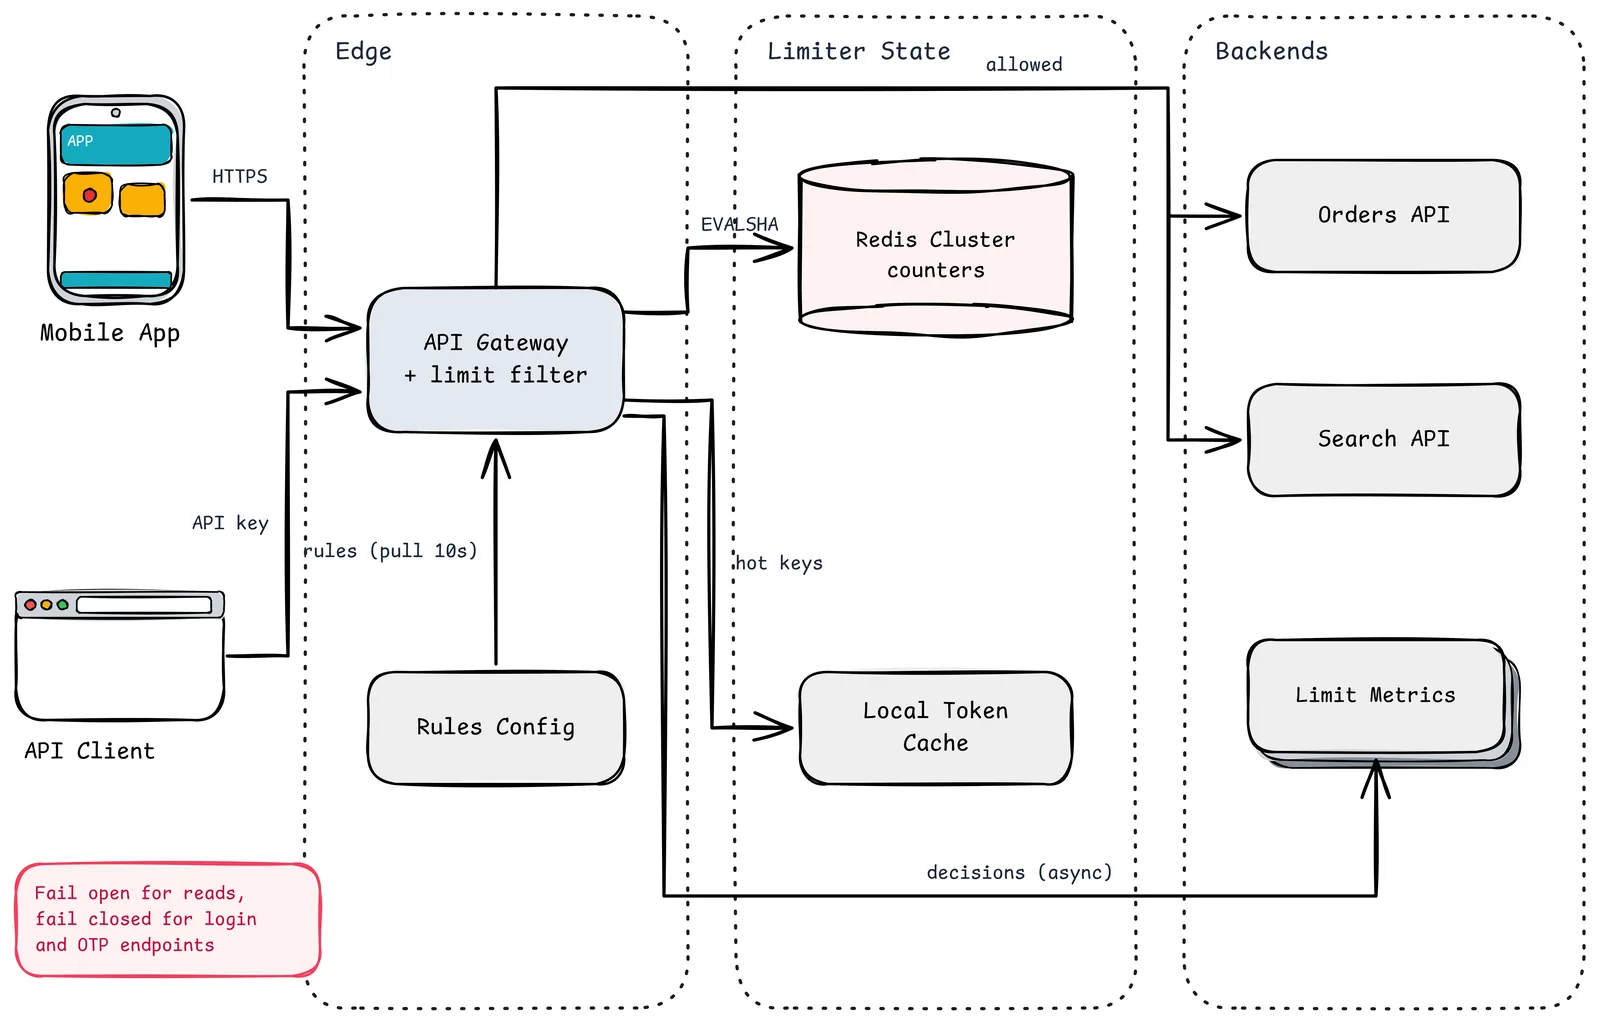
- Mobile App / API Client. Llamantes no confiables. Algunos tienen bugs, unos pocos son hostiles, la mayoría está bien.
- API Gateway + filtro de límites. El punto de aplicación. Ya analiza la autenticación y el enrutado, así que tiene la identidad y la ruta necesarias para construir la clave. Aplicarlo aquí protege todos los backends con una sola implementación (el servicio global de rate limit de Envoy y la mayoría de gateways gestionados siguen esta forma).
- Rules Config. Un pequeño servicio o repositorio de configuración que define límites por nivel, tenant y ruta. Los gateways leen las reglas cada pocos segundos y las guardan en memoria, así que una caída de la configuración nunca bloquea el tráfico.
- Redis Cluster (contadores). El estado compartido. Cada decisión es un
EVALSHAde un script Lua precargado, lo que hace atómicos la lectura, el relleno y el descuento. - Local Token Cache. Para un puñado de claves extremadamente calientes (un gran tenant martilleando una ruta), los gateways pueden arrendar a Redis un pequeño lote de fichas y gastarlas localmente, cambiando un poco de precisión por muchos menos viajes.
- Orders API / Search API. Los backends solo ven tráfico permitido. Las rutas caras (búsqueda) tienen límites más estrictos que las baratas (lectura de pedidos).
- Limit Metrics. Cada decisión se emite de forma asíncrona, para que puedas ver a quién se limita, ajustar reglas y detectar falsos positivos. Este flujo nunca debe estar en la ruta de la petición.
La nota roja del diagrama es la decisión de política más importante de este sistema, y se trata más abajo.
La ruta de decisión de una petición
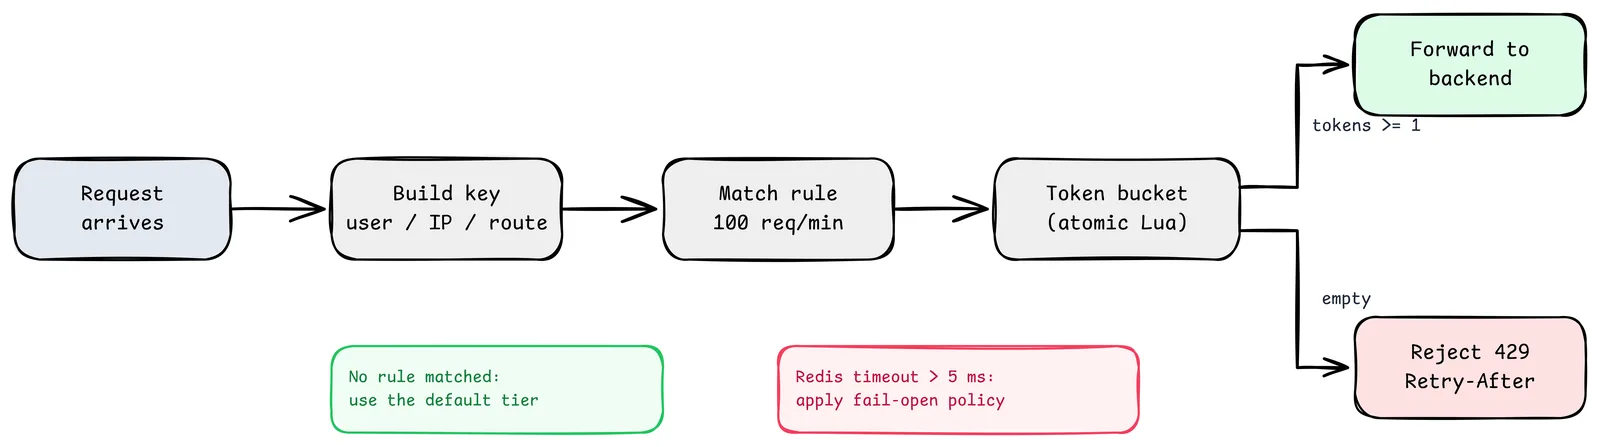
- Construir la clave. Por ejemplo
rl:{tenant:acme}:route:search. Las llaves son una hash tag de Redis Cluster, que fija todas las claves de un tenant en el mismo slot por si alguna vez necesitas operaciones con varias claves. - Encontrar la regla. Gana la más específica: excepción del tenant para la ruta, luego el nivel del tenant, luego un nivel por defecto. Una petición sin regla aplicable sigue recibiendo la regla por defecto, nunca "ilimitado".
- Ejecutar el cubo de forma atómica. Leer, rellenar, gastar y escribir deben ser una sola operación. Dos gateways que lean y luego escriban en paralelo verán ambos una ficha y ambos la gastarán.
- Permitir o rechazar. Las peticiones permitidas continúan con cabeceras que describen el presupuesto restante. Las rechazadas reciben
429 Too Many Requestsy unRetry-After.
Este es el cubo completo como script Lua de Redis. Usa la hora del servidor Redis en lugar del reloj del gateway, lo que elimina de la ecuación el desfase de reloj entre nodos.
-- KEYS[1]: bucket key   ARGV[1]: capacity   ARGV[2]: refill tokens/sec   ARGV[3]: cost
local cap, rate, cost = tonumber(ARGV[1]), tonumber(ARGV[2]), tonumber(ARGV[3])
local t = redis.call('TIME')  -- Redis 5+ replicates script effects, so TIME is safe here
local now = tonumber(t[1]) * 1000 + math.floor(tonumber(t[2]) / 1000)

local b = redis.call('HMGET', KEYS[1], 'tokens', 'ts')
local tokens = tonumber(b[1]) or cap
local ts = tonumber(b[2]) or now

tokens = math.min(cap, tokens + (now - ts) / 1000 * rate)
local allowed = 0
if tokens >= cost then
  tokens = tokens - cost
  allowed = 1
end

redis.call('HSET', KEYS[1], 'tokens', tokens, 'ts', now)
redis.call('PEXPIRE', KEYS[1], math.ceil(cap / rate * 1000) + 1000)

local retry_ms = 0
if allowed == 0 then retry_ms = math.ceil((cost - tokens) / rate * 1000) end
return { allowed, math.floor(tokens), retry_ms }
El PEXPIRE importa más de lo que parece: los cubos inactivos caducan cuando ya se habrían rellenado del todo, así que la memoria crece con los clientes activos, no con todos los que han existido.
Explicar a los clientes qué ha pasado
Un limitador que rechaza sin explicación genera tickets de soporte y empeora los reintentos de los clientes.
- Estado:
429 Too Many Requests(definido en la RFC 6585). No uses503para límites por cliente; eso les dice que todo el servicio está caído. Retry-After: segundos hasta que un reintento tenga probabilidades de funcionar (RFC 9110). El script Lua de arriba devuelve exactamente ese número.- Cabeceras de presupuesto: la API de GitHub devuelve
x-ratelimit-limit,x-ratelimit-remainingyx-ratelimit-reseten cada respuesta, y el grupo de trabajo HTTPAPI del IETF está estandarizando los camposRateLimityRateLimit-Policy. Elige una convención y documéntala. - Guía para clientes: publica que deben reintentar con espera exponencial y jitter. Sin jitter, todos los clientes limitados reintentan en el mismo instante y obtienes una estampida sincronizada.
¿Fallar abierto o cerrado?
Cuando Redis va lento o no responde, el limitador tiene que adivinar. No hay una respuesta correcta universal, y por eso debe configurarse por ruta, no de forma global.
| Tipo de ruta | Política | Por qué |
|---|---|---|
| Lecturas, navegación de catálogo, la mayoría de APIs | Fallar abierto | Una caída del limitador no debe convertirse en una caída total. Los backends tienen su propio recorte de carga |
| Login, restablecimiento de contraseña, verificación OTP | Fallar cerrado | Estos límites existen para frenar el relleno de credenciales y la fuerza bruta. Fallar abierto quita la protección justo cuando un atacante podría estar causando la inestabilidad |
| Escrituras caras, pagos | Fallar cerrado o recurrir a un límite local conservador | Aquí la sobrecarga es costosa y difícil de deshacer |
Pon un timeout estricto a la llamada a Redis (pocos milisegundos). Un limitador que espera 2 segundos a Redis ya ha fallado, solo que más despacio.
Los problemas que aparecen a escala
Claves calientes. Un tenant enorme puede concentrar gran parte del tráfico en una sola clave de Redis y, por tanto, en un solo fragmento. Opciones: partir la clave (rl:{acme}:search:0..7, cada una con una octava parte del ritmo) o arrendar fichas por lotes a los gateways mediante la caché local. Ambas cambian un poco de precisión por rendimiento.
Varias regiones. Un límite global entre regiones necesita un almacén global (latencia) o un presupuesto repartido (cada región recibe una parte que se reequilibra periódicamente). La mayoría de sistemas eligen presupuestos por región y aceptan que un cliente que golpea dos regiones obtenga algo más que el límite nominal.
Desfase de relojes. Usar los relojes de los gateways en la cuenta del cubo hace que dos nodos discrepen sobre el tiempo transcurrido. Usar TIME de Redis, como arriba, lo evita. Si tu almacén no tiene reloj de servidor, usa tiempo monótono en una única autoridad.
Los reintentos amplifican la carga. Clientes, SDK y service meshes reintentan. Si cada capa reintenta tres veces, una petición de usuario puede convertirse en decenas. Cuenta los reintentos contra el mismo presupuesto y asegúrate de que los reintentos internos también respetan Retry-After.
Los límites son producto. Los límites forman parte de tu precio y de tu contrato. Cambiarlos en silencio rompe integraciones. Versiónalos y anúncialos como una API.
Una respuesta del tamaño de una entrevista
- Aclara qué se limita (por usuario, por IP, por clave) y si los límites son estrictos o flexibles.
- Pon el limitador en el gateway, con el estado compartido en Redis.
- Elige token bucket y usa como argumento el problema de borde de la ventana fija.
- Haz la comprobación atómica con un script Lua.
- Devuelve
429conRetry-After. - Comenta fallar abierto o cerrado por endpoint y el problema de las claves calientes.
Eso cubre lo que la mayoría de entrevistadores quieren oír. El resto es profundidad que puedes ofrecer si hay tiempo.
Lista de comprobación para producción
- Reglas definidas por nivel, tenant y ruta, con un nivel por defecto para todo lo demás
- Comprobación y gasto atómicos (Lua u operación equivalente en el servidor)
- Hora del servidor para la cuenta del cubo
- Las claves de los cubos caducan cuando están inactivas
- Timeout estricto en las llamadas al almacén de estado, con política por ruta de fallar abierto o cerrado
-
429,Retry-Aftery cabeceras de presupuesto documentadas para los clientes - Mitigación de claves calientes (claves partidas o arriendo local de fichas)
- Decisiones enviadas a métricas; paneles de tasa de limitación por tenant y ruta
- Límites de concurrencia separados para endpoints caros
- Prueba de carga que incluya un Redis lento, no solo un Redis caído
Lo que queda
El limitador de tasa es el único componente cuyo trabajo es decir que no a tus propios clientes. Si lo configuras un poco mal, a quienes limitas son a los mejores, aquellos cuyas integraciones crecieron más rápido que tus reglas.
Así que registra cada rechazo y lee el registro. En algún lugar de ahí hay un cliente al que deberías haber llamado en lugar de limitar.
Fuentes
- Stripe: Scaling your API with rate limiters
- Cloudflare: How we built rate limiting capable of scaling to millions of domains
- Envoy proxy: global rate limiting
- RFC 6585: Additional HTTP Status Codes (429)
- Borrador del IETF: RateLimit header fields for HTTP
- GitHub REST API: rate limits
- Redis: scripting with Lua
- Relacionado en esta serie: Diseña un acortador de URL, Patrones de caché con Redis