TL;DR
- El problema: Colocar claves con
hash(key) % Nfunciona hasta que N cambia. Añade un undécimo nodo de caché a diez y alrededor del 90% de las claves pasan a apuntar a otro sitio, lo que para una caché significa una tormenta de fallos casi total contra la base de datos que hay detrás.- El diseño: Proyectar claves y servidores sobre el mismo espacio circular. Una clave pertenece al primer punto de servidor en sentido horario. Dar a cada servidor unos cientos de nodos virtuales para equilibrar la carga, y seguir avanzando en sentido horario para elegir réplicas en servidores distintos.
- El resultado: Añadir o quitar un nodo mueve aproximadamente 1/N de las claves. En una prueba medida con 10 nodos y 200 nodos virtuales cada uno, el nodo más cargado llevaba 1,11 veces la media, frente a 2,3 veces con un punto por nodo.
La mayoría de sistemas distribuidos tienen que responder millones de veces por segundo a una pregunta aburrida: ¿qué máquina es dueña de esta clave? Cachés, bases de datos particionadas, balanceadores que quieren afinidad de sesión y almacenes de objetos necesitan una respuesta rápida, sin consulta central, que no se venga abajo cuando se añade una máquina o se cae otra.
Consistent hashing es la respuesta clásica. Lo presentaron Karger y sus colegas en 1997 para cachés web, lo popularizó el artículo de Dynamo de Amazon en 2007, y hoy está dentro de Cassandra, de clientes de memcached, del balanceador de Envoy y de muchos más. Este artículo explica cómo funciona, mide lo que realmente aportan los nodos virtuales y repasa las alternativas que a veces son mejores.
Por qué hash(key) % N se rompe
La colocación por módulo está perfectamente equilibrada y es perfectamente frágil. Una clave solo se queda en el mismo nodo cuando N pasa a N+1 si h % N == h % (N+1), lo que ocurre aproximadamente con 1 de cada N+1 claves.
Lo medí con 200.000 claves:
| Cambio | Claves que se movieron |
|---|---|
De % 10 a % 11 |
90,7% |
| Anillo de consistent hashing, de 10 a 11 nodos, 200 nodos virtuales cada uno | 9,0% |
En una caché, mover el 90% significa que el 90% de las lecturas fallan a la vez y caen sobre la base de datos, normalmente justo cuando añadías capacidad porque la carga era alta. En una base de datos particionada significa mover el 90% de los datos para añadir una máquina. Ninguna de las dos cosas es aceptable.
El anillo
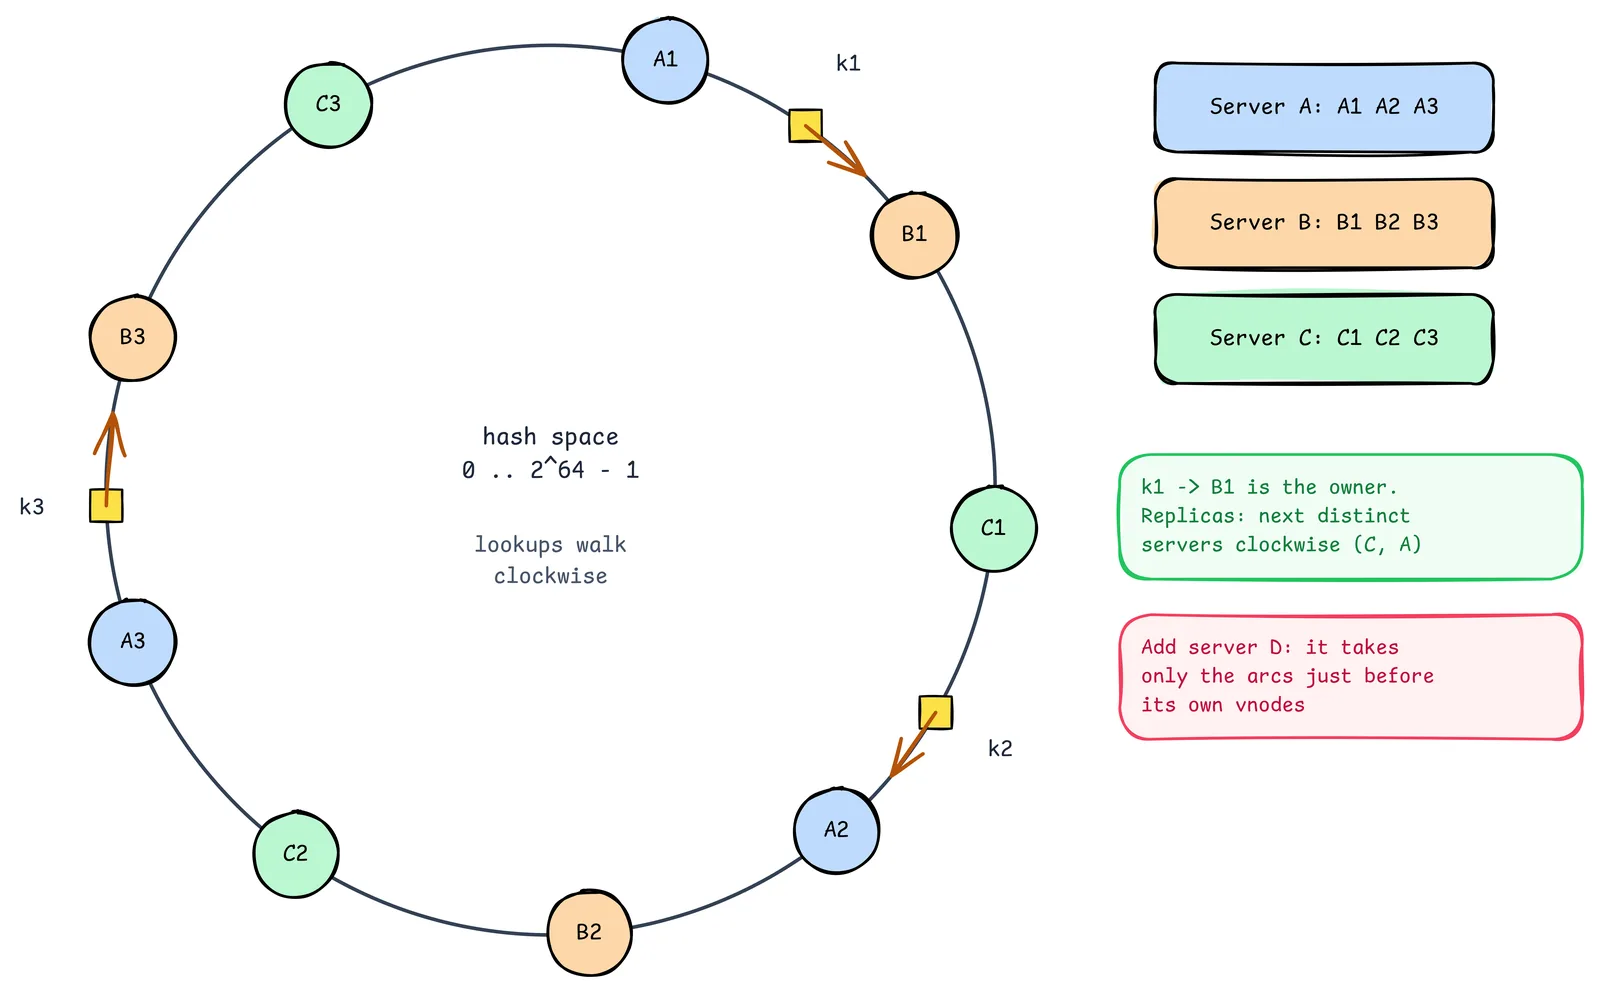
- Espacio de hash. Elige una función de hash con una salida grande (64 bits es de sobra) y trata su rango como un círculo: después del valor más alto viene el cero.
- Servidores en el anillo. Cada servidor se proyecta sobre el círculo, en la práctica muchas veces, como nodos virtuales (A1, A2, A3 en el diagrama).
- Claves en el anillo. Cada clave se proyecta sobre el mismo círculo.
- Propiedad. Una clave pertenece al primer nodo virtual que se encuentra avanzando en sentido horario.
k1cae justo antes deB1, así que el dueño es el servidor B. - Entrada. Un servidor nuevo D coloca sus nodos virtuales en el anillo. Cada uno se queda solo con el arco entre él y el punto anterior. Todo lo demás sigue donde estaba.
- Salida. Cuando un servidor sale, cada uno de sus arcos lo absorbe el siguiente punto en sentido horario. De nuevo, solo se mueven las claves de ese servidor.
La búsqueda es una búsqueda binaria sobre la lista ordenada de posiciones de nodos virtuales: O(log V), donde V es el número total de nodos virtuales. Con 100 servidores y 200 nodos virtuales cada uno, es una búsqueda sobre 20.000 enteros, que tarda muy por debajo de un microsegundo.
import bisect, hashlib

def h(s: str) -> int:
    return int.from_bytes(hashlib.md5(s.encode()).digest()[:8], "big")

class Ring:
    def __init__(self, nodes, vnodes=200):
        self.vnodes, self.points, self.owner = vnodes, [], {}
        for n in nodes:
            self.add(n)

    def add(self, node):
        for i in range(self.vnodes):
            p = h(f"{node}#{i}")
            bisect.insort(self.points, p)
            self.owner[p] = node

    def remove(self, node):
        self.points = [p for p in self.points if self.owner[p] != node]
        self.owner = {p: n for p, n in self.owner.items() if n != node}

    def lookup(self, key):
        i = bisect.bisect(self.points, h(key)) % len(self.points)
        return self.owner[self.points[i]]
Aquí MD5 se usa por su distribución, no por seguridad. Sirve cualquier hash rápido y bien mezclado; en producción se suele usar Murmur3 o xxHash.
Nodos virtuales: lo que aportan de verdad
Con un punto por servidor, los arcos tienen longitudes muy distintas, así que algunos servidores poseen mucho más anillo que otros. Los nodos virtuales lo corrigen promediando muchos arcos pequeños. Mismo experimento, 200.000 claves entre 10 servidores:
| Nodos virtuales por servidor | Más cargado / media | Menos cargado / media |
|---|---|---|
| 1 | 2,30x | 0,12x |
| 10 | 1,46x | 0,69x |
| 200 | 1,11x | 0,92x |
El anillo de un solo punto es casi inútil: un servidor lleva más del doble de lo que le toca mientras otro está casi parado. Con 200 nodos virtuales, la dispersión ronda el ±10%.
Los nodos virtuales tienen dos ventajas más:
- Capacidad ponderada. Un servidor con el doble de memoria recibe el doble de nodos virtuales.
- Fallos más suaves. Cuando un servidor muere, sus muchos arcos pequeños los absorben muchos sucesores distintos, en lugar de que un vecino desafortunado herede toda su carga.
El coste es memoria para el anillo y más metadatos que mover. Cassandra usó durante años 256 tokens por nodo por defecto; la versión 4.0 bajó el valor por defecto a 16 junto a un algoritmo de asignación de tokens más inteligente, porque cifras muy altas encarecían las reparaciones y el streaming. Más no es gratis.
Replicación sobre el anillo
Los sistemas tipo Dynamo usan el anillo también para elegir réplicas. Para guardar una clave con factor de replicación 3, avanza en sentido horario desde la clave y toma los tres primeros servidores físicos distintos, saltando los nodos virtuales adicionales de un servidor ya elegido. La nota del diagrama lo muestra con k1: el dueño es B, y luego C y A guardan réplicas.
En producción importan dos refinamientos:
- Conciencia de rack o zona. "Servidores distintos" debería significar en realidad "dominios de fallo distintos". Tres réplicas en un mismo rack son una sola réplica durante un corte de energía.
- Listas de preferencia. La lista ordenada de candidatos (los tres primeros nodos sanos en sentido horario) es lo que permite a un coordinador esquivar una réplica caída temporalmente, y así funcionan los quórums laxos y el hinted handoff en Dynamo y Cassandra.
Un clúster de caché construido sobre el anillo
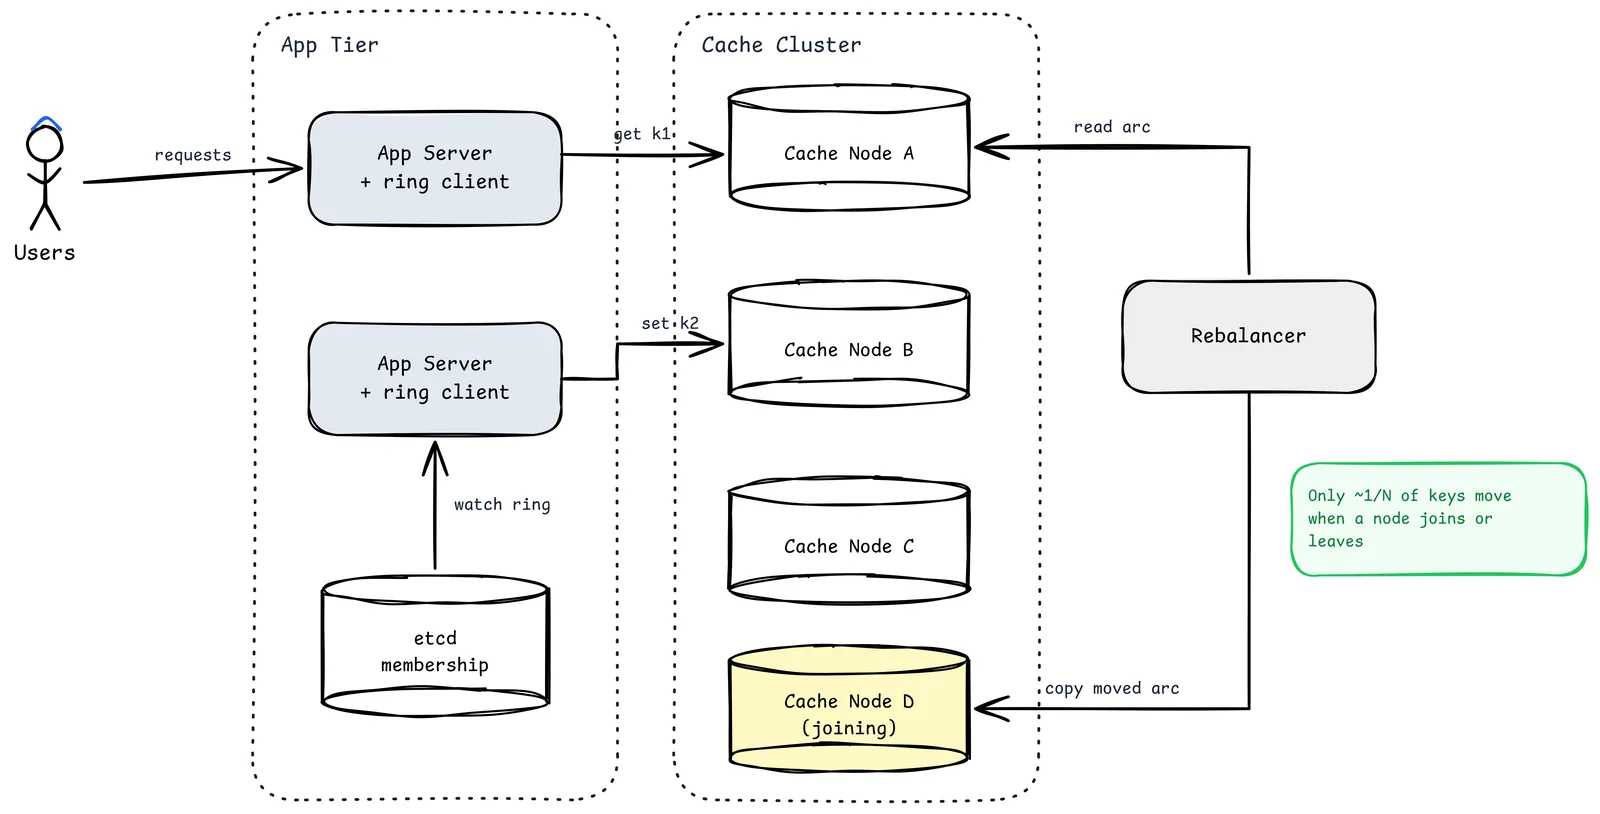
- App Server + cliente de anillo. El anillo vive en la librería cliente (así funcionan los clientes de memcached de estilo ketama). Sin salto por un proxy ni consulta central en la ruta de la petición.
- etcd (membresía). La fuente de verdad de qué nodos están en el anillo y con qué peso. Los clientes la observan y reconstruyen su anillo cuando cambia. ZooKeeper, Consul o un protocolo de gossip pueden hacer el mismo papel.
- Cache Nodes A, B, C. Servidores clave-valor normales. No necesitan saber nada del anillo.
- Cache Node D (incorporándose). Se añade primero a la membresía en estado de "calentamiento". Los clientes empiezan a enviar escrituras de sus arcos mientras el rebalanceador lo rellena.
- Rebalancer. En una caché, rebalancear es opcional: los fallos se rellenan solos. En una base de datos, o en cualquier cosa con estado que no puedas regenerar, el rebalanceador transmite los arcos que cambiaron de dueño, con un límite de velocidad para no asfixiar el tráfico real.
La nota verde es lo esencial: solo se mueve alrededor de 1/N de las claves.
Lo que consistent hashing no resuelve
- Claves calientes. Si una clave recibe el 10% de todo el tráfico, sigue viviendo en un solo servidor. El anillo equilibra claves, no peticiones. Necesitas replicar las claves calientes, coalescer peticiones o una caché cercana local.
- Vistas del anillo inconsistentes. Si durante un cambio de membresía la mitad de tus clientes tiene el anillo nuevo y la otra mitad el viejo, la misma clave se lee desde dos sitios. En cachés eso significa más fallos. En bases de datos significa que necesitas propiedad versionada (épocas) y un protocolo de traspaso.
- Sobrecarga en cascada. Cuando un nodo muere, sus sucesores absorben su carga. Si ya estaban al 80%, pueden caer también. "Consistent hashing with bounded loads" (Mirrokni, Thorup y Zadimoghaddam) limita la carga de cada nodo y desborda al siguiente en sentido horario; Vimeo explicó que lo adoptó para el balanceo de su entrega de vídeo.
Las alternativas que conviene conocer
| Técnica | Cómo funciona | Ventaja | Inconveniente | Dónde se ve |
|---|---|---|---|---|
| Anillo de hash con nodos virtuales | Sucesor en sentido horario sobre un círculo | Altas y bajas arbitrarias de nodos, listas de réplicas naturales | Necesita nodos virtuales para equilibrar; metadatos del anillo | Dynamo, Cassandra, clientes ketama, ring hash de Envoy |
| Rendezvous (peso aleatorio más alto) | Para cada clave, puntuar cada nodo con hash(key, node) y elegir el más alto |
Sin anillo, equilibrio casi perfecto, réplicas ponderadas triviales (los K primeros) | O(N) por búsqueda |
Balanceadores y clústeres pequeños |
| Jump consistent hash | Función aritmética de salto que asigna una clave a un cubo 0..N-1 | Sin memoria, muy rápido, equilibrio excelente | Solo se pueden añadir o quitar nodos al final de la numeración | Almacenamiento particionado con fragmentos numerados |
| Hashing Maglev | Tabla precalculada rellenada a partir de permutaciones por backend | Búsquedas O(1), muy uniforme, disrupción mínima |
Reconstruir la tabla al cambiar; pensado para balanceadores | Google Maglev, política Maglev de Envoy |
Mi regla práctica: rendezvous para conjuntos pequeños de backends (decenas), anillo con nodos virtuales para sistemas de almacenamiento que necesitan listas de réplicas y cambios arbitrarios de membresía, jump hash cuando los fragmentos están numerados y solo crecen, y Maglev para balanceadores L4.
Guion para la entrevista
- Empieza con
hash % Ny muestra qué pasa cuando cambia N. Usa la cifra del 90%. - Dibuja el anillo y explica la propiedad en sentido horario.
- Muestra que añadir un nodo mueve un solo arco.
- Señala el desequilibrio con un punto por nodo y luego introduce los nodos virtuales.
- Añade replicación: los siguientes K servidores distintos, idealmente en zonas distintas.
- Menciona una limitación (claves calientes) y una alternativa (rendezvous o jump hash).
Lista de comprobación para producción
- Función de hash rápida y bien distribuida (Murmur3, xxHash); nunca un
hashCodeestilo Java - Número de nodos virtuales elegido y medido (dispersión de carga por debajo de tu objetivo)
- Pesos que reflejan la capacidad real de cada nodo
- La membresía tiene una única fuente de verdad y los clientes la observan
- Los cambios del anillo están versionados para detectar vistas obsoletas
- Réplicas elegidas en dominios de fallo distintos
- Los flujos de rebalanceo tienen límite de velocidad y son observables
- El tratamiento de claves calientes existe aparte de la colocación
- El panel muestra número de claves y tasa de peticiones por nodo, no solo medias
Lo que queda
El anillo es una de esas ideas que parecen obvias en cuanto las ves y siguen siendo útiles durante décadas. Hace una sola cosa: cuando el clúster cambia, mantiene casi todo el mundo donde estaba.
Es una promesa modesta. También es la diferencia entre añadir un nodo a las 3 de la madrugada para aliviar la presión y añadir un nodo a las 3 de la madrugada que se lleva por delante la base de datos.
Fuentes
- Karger et al., "Consistent Hashing and Random Trees" (STOC 1997)
- DeCandia et al., "Dynamo: Amazon's Highly Available Key-value Store" (SOSP 2007)
- Lamping y Veach, "A Fast, Minimal Memory, Consistent Hash Algorithm" (jump hash, 2014)
- Eisenbud et al., "Maglev: A Fast and Reliable Software Network Load Balancer" (NSDI 2016)
- Mirrokni, Thorup y Zadimoghaddam, "Consistent Hashing with Bounded Loads"
- Envoy: tipos de balanceador (ring hash y Maglev)
- Relacionado en esta serie: Diseña un almacén clave-valor, Escala de cero a millones