TL;DR
- El problema: Todos los diagramas de arquitectura de los sistemas grandes muestran el estado final. Los equipos copian ese estado final el primer día y se ahogan en complejidad, o ignoran la escala hasta que la base de datos se cae en un lanzamiento.
- El diseño: Crecer en ocho pasos (separar la base de datos, añadir un balanceador, añadir réplicas de lectura y una caché, llevar los estáticos a un CDN y quitar el estado a los servidores de aplicación, mandar el trabajo lento a colas, añadir regiones, particionar la base principal) y dar cada paso solo cuando una métrica diga que el diseño anterior se ha agotado.
- El resultado: Un sistema que nunca es más complejo de lo que exige su tráfico, con el siguiente movimiento listo cuando un panel se pone en rojo. Muchos productos enormes funcionaron durante años con sorprendentemente pocas máquinas porque dieron estos pasos tarde y bien.
Stack Overflow, uno de los sitios con más tráfico de internet, funcionó durante años con unos nueve servidores web y unas pocas máquinas SQL Server. Instagram llegó a decenas de millones de usuarios con un equipo pequeño y una pila bastante convencional de Django, PostgreSQL, Redis y memcached. La lección no es que escalar sea fácil. Es que la mayor parte de escalar consiste en hacer lo siguiente que es obvio en el momento adecuado, midiendo, en lugar de hacer lo impresionante demasiado pronto.
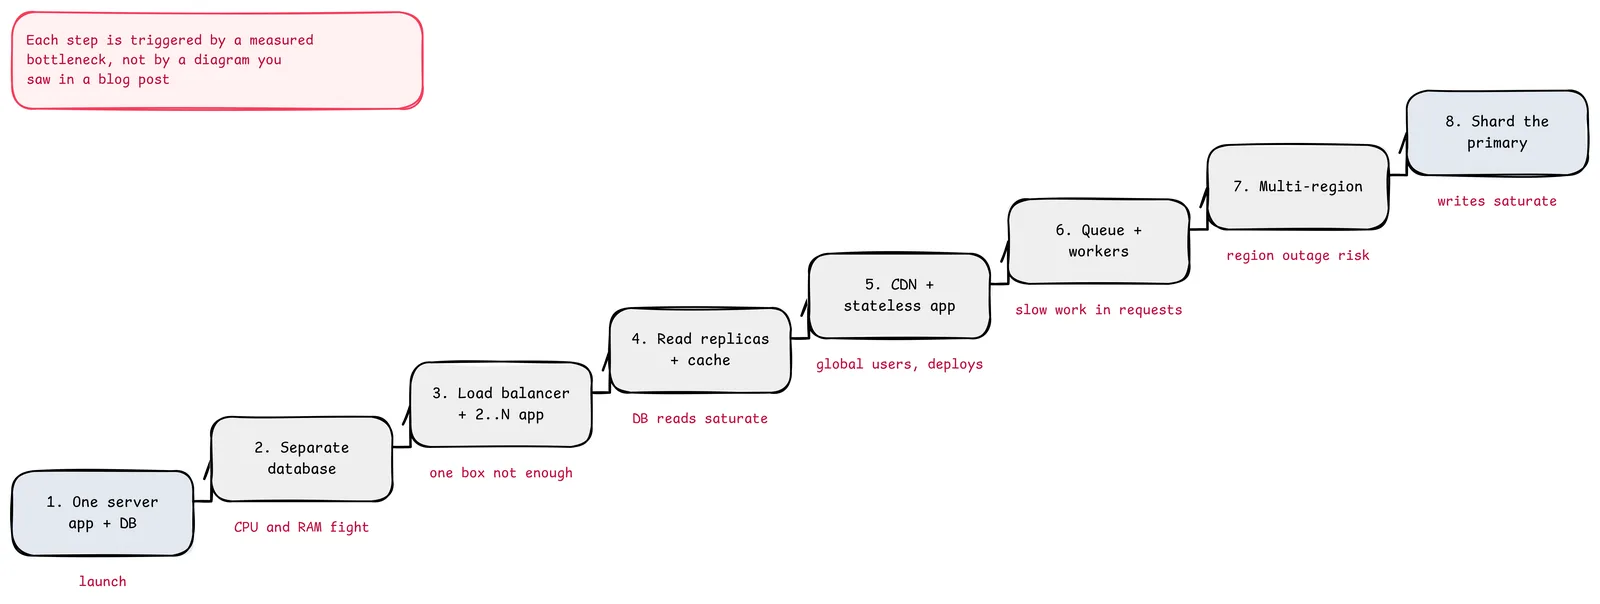
La nota roja es la regla de todo el artículo. Cada paso de abajo indica qué lo dispara, qué aporta y qué problema nuevo crea.
Paso 1: un servidor
Aplicación, base de datos y ficheros en una sola máquina. Es la arquitectura correcta para un producto nuevo: una sola cosa que desplegar, una sola cosa de la que hacer copia, ninguna red entre componentes.
Cuándo pasar al siguiente: la aplicación y la base de datos se pelean por CPU y memoria, o necesitas reiniciar una sin la otra.
Paso 2: separar la base de datos
Pon la base de datos en su propia máquina (o en un servicio gestionado). Ahora cada una se dimensiona por su cuenta, y el host de la base de datos no hace otra cosa que servir consultas.
Problema nuevo: el salto de red. Las consultas que eran baratas en localhost ahora cuestan un viaje de ida y vuelta, así que el patrón de N+1 consultas de repente importa.
Cuándo pasar al siguiente: la CPU del servidor de aplicación se satura en el pico, o no puedes tolerar el corte cuando esa máquina se reinicia.
Paso 3: balanceador y varios servidores de aplicación
Pon dos o más servidores de aplicación detrás de un balanceador. Escalar la capa web pasa a ser añadir máquinas.
Problema nuevo: el estado. Si la sesión de un usuario vive en la memoria de un servidor, la siguiente petición puede caer en otro. O usas sesiones pegajosas (sencillo y frágil) o, mejor, sacas las sesiones de los servidores de aplicación por completo (paso 5).
Cuándo pasar al siguiente: el límite ya no es la capa de aplicación sino la base de datos. Normalmente las lecturas.
Paso 4: réplicas de lectura y una caché
La mayoría de productos leen mucho más de lo que escriben. Dos herramientas atacan las lecturas:
- Las réplicas de lectura copian los datos de la principal de forma asíncrona y sirven las consultas de lectura.
- Una caché (Redis o memcached) guarda los resultados calientes en memoria con cache-aside: leer de la caché y, si falla, leer de la base de datos y rellenar la caché con un TTL.
Problemas nuevos:
- Retraso de replicación. Un usuario actualiza su perfil, recarga y ve el valor antiguo porque la lectura fue a una réplica. Envía a la principal las lecturas de un usuario durante un breve intervalo tras escribir (leer lo que escribiste) o lee los datos críticos de la principal.
- Invalidación de caché y estampidas. Borra o actualiza las claves de caché al escribir, usa TTL como red de seguridad y agrupa los fallos concurrentes de la misma clave.
Cuándo pasar al siguiente: los usuarios de otros países ven páginas lentas, o los despliegues duelen porque los servidores guardan estado.
Paso 5: CDN y servidores de aplicación sin estado
- CDN. Sirve imágenes, scripts, estilos y vídeo desde ubicaciones de borde cerca de los usuarios. El origen solo sirve respuestas dinámicas.
- Servidores sin estado. Las sesiones pasan a un almacén compartido (Redis o tokens firmados), las subidas van a almacenamiento de objetos y nada importante vive en el disco de un servidor de aplicación. Cualquier servidor puede atender cualquier petición, así que el autoescalado y los despliegues se vuelven rutina.
Problema nuevo: cabeceras de caché e invalidación de los estáticos. Pon una huella en los nombres de fichero (app.3f9c1.js) para no tener que purgar nunca.
Cuándo pasar al siguiente: las peticiones son lentas porque hacen trabajo lento en línea (enviar emails, redimensionar imágenes, llamar a terceros).
Paso 6: colas y workers
Saca de la ruta de la petición el trabajo lento o propenso a fallar. La petición escribe un mensaje y responde; los workers lo procesan.
Problemas nuevos: reintentos e idempotencia (un mensaje puede entregarse dos veces), orden (solo dentro de una partición, si acaso) y visibilidad (un atasco es invisible si no lo pones en una gráfica). Una cola de mensajes muertos y alertas de profundidad de cola son obligatorias.
Cuándo pasar al siguiente: la caída de una sola región sería un desastre para el negocio, o los usuarios lejanos tienen una latencia inaceptable en las peticiones dinámicas.
Paso 7: varias regiones
Ejecuta la pila en dos o más regiones con GeoDNS o anycast llevando a cada usuario a la región sana más cercana.
| Modelo | Cómo funciona | Coste |
|---|---|---|
| Activo-pasivo | Una región sirve tráfico; la otra está en espera con los datos replicados | La conmutación tarda minutos y hay que ensayarla; pueden perderse escrituras recientes |
| Activo-activo, particionado | Los datos de cada usuario tienen una región de origen; ambas regiones sirven tráfico | Lógica de enrutamiento y de ubicación de datos; peticiones entre regiones para los datos compartidos |
| Activo-activo, datos globales | Todas las regiones aceptan escrituras en los datos compartidos | Resolución de conflictos o una base de datos globalmente consistente con más latencia de escritura |
Problema nuevo: los datos. Las capas sin estado se replican sin esfuerzo; las bases de datos no. Elige el modelo preguntándote qué pasa con una escritura hecha un segundo antes de que caiga una región.
Cuándo pasar al siguiente: la base de datos principal ya no puede absorber la carga de escritura ni en la máquina más grande que puedas comprar.
Paso 8: particionar la base principal
Antes de particionar, agota las opciones más baratas: una máquina más grande, ajustar consultas e índices, llevar las funcionalidades con muchas escrituras a bases de datos separadas por dominio (federación) y archivar los datos fríos. El particionado es el último paso por algo.
Cuando particiones, reparte las filas entre muchas bases de datos según una clave de partición:
- Elige la clave según el patrón de acceso dominante. Un SaaS multiinquilino particiona por inquilino; una app social, a menudo por usuario. Las consultas que incluyen la clave tocan un solo fragmento.
- Evita los fragmentos calientes. Aplica un hash a la clave en lugar de usar rangos de tiempo o IDs secuenciales.
- Planifica el reparticionado desde el primer día. Usa muchos fragmentos lógicos asignados a menos bases físicas, para que crecer signifique mover fragmentos lógicos y no rehacer el hash de cada fila (mira consistent hashing).
Problemas nuevos: las consultas y transacciones entre fragmentos pasan a ser código de aplicación, las restricciones de unicidad entre fragmentos necesitan un esquema global de IDs (generador de IDs únicos) y las operaciones se multiplican por el número de fragmentos.
El destino, como referencia
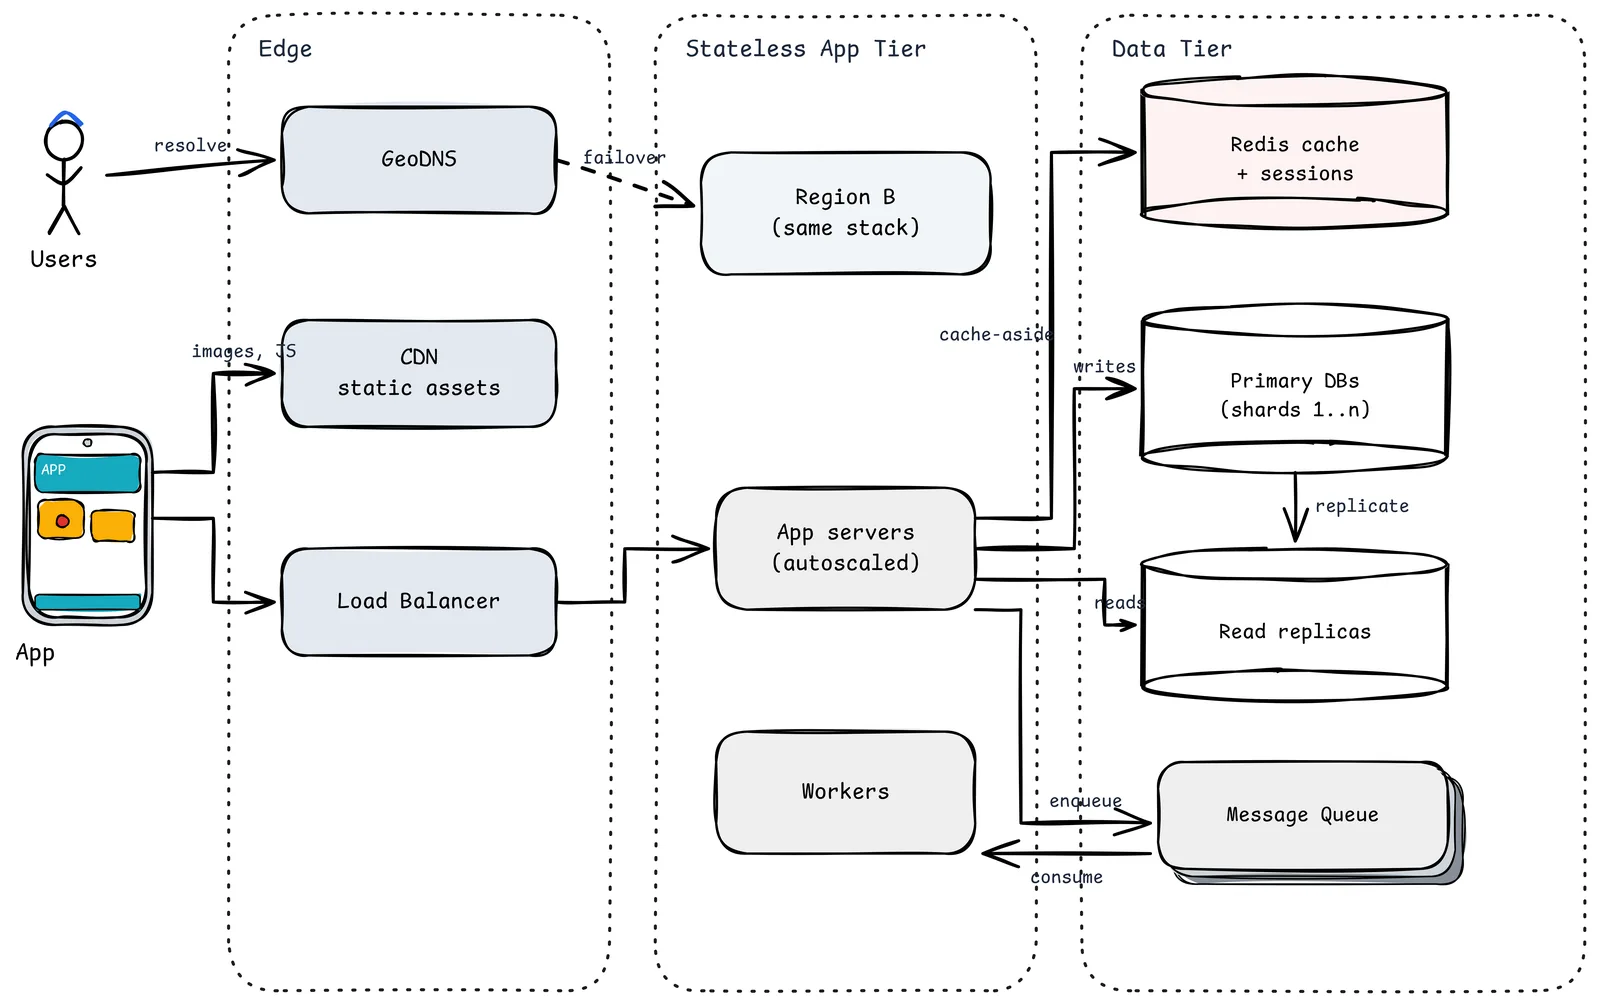
- GeoDNS envía a los usuarios a la región sana más cercana y conmuta a la Región B.
- CDN sirve los estáticos desde el borde.
- Load Balancer reparte las peticiones entre App servers sin estado y autoescalados.
- Redis guarda las entradas de caché y las sesiones.
- Primary DBs (fragmentos 1..n) reciben las escrituras; Read replicas reciben el tráfico de lectura.
- Message Queue y Workers se encargan de todo lo que no necesita terminar antes de la respuesta.
Aquí acaban muchos productos grandes. Es un pésimo sitio para empezar.
Qué medir para saber cuándo moverse
| Señal | Sugiere |
|---|---|
| CPU de aplicación alta en pico, base de datos bien | Añadir servidores de aplicación (paso 3) |
| CPU o IO de base de datos altas, sobre todo lecturas | Réplicas y caché (paso 4) |
| p99 alto para usuarios lejos de tu región | CDN (paso 5) y luego regiones (paso 7) |
| Latencia dominada por llamadas externas | Colas y workers (paso 6) |
| Rendimiento de escritura o almacenamiento de la principal cerca del límite tras afinar | Federación y luego particionado (paso 8) |
Lo que queda
La arquitectura más cara es la que construiste para un tráfico que no tienes. La segunda más cara es la que se cae el día que llega el tráfico.
El camino entre ambas es aburrido: unos cuantos paneles, una lista escrita de los próximos tres pasos y la disciplina de dar un paso solo cuando una gráfica te lo pide. El diagrama impresionante seguirá ahí cuando lo necesites.
Fuentes
- Nick Craver: Stack Overflow, The Architecture (2016 Edition)
- Instagram Engineering: What Powers Instagram
- AWS Well-Architected Framework: pilar de fiabilidad (patrones multirregión)
- Martin Fowler: CQRS y modelos de lectura
- Relacionado en esta serie: Estimaciones de servilleta, Diseña consistent hashing, Patrones de caché con Redis