TL;DR
- Le problème : Un fil d'accueil doit montrer à chaque utilisateur les publications les plus récentes et pertinentes de centaines de comptes suivis, en moins de 200 ms, pour des centaines de millions d'utilisateurs, alors que certains comptes ont des dizaines de millions d'abonnés.
- La conception : Précalculer les timelines en poussant les identifiants de publication dans la liste Redis de chaque abonné à la création d'une publication (fan-out à l'écriture), sauf pour les très gros comptes, dont les publications sont récupérées et fusionnées à la lecture. Un service de fil combine les deux sources, classe les candidats, hydrate les données de publications et d'utilisateurs depuis des caches, et pagine par curseur.
- Le résultat : Lire le fil devient une consultation de liste bon marché suivie d'une hydratation, les écritures sont absorbées de façon asynchrone par des workers, et le problème des célébrités passe d'une tempête d'écritures à une petite fusion à la lecture.
Le fil d'actualité est le problème de conception de systèmes qui récompense le plus une idée précise. Tout le reste (caches, partitionnement, classement) est un second rôle. L'idée, la voici : il faut décider quand se fait le travail d'assemblage d'un fil, à l'écriture ou à la lecture, et la réponse est « les deux, selon qui publie ».
Cet article construit le fil autour de cette décision.
Exigences et chiffres
Fonctionnelles : les utilisateurs publient (texte, images, vidéo) ; ils voient un fil d'accueil des publications des comptes qu'ils suivent, les plus récentes ou les plus pertinentes d'abord ; défilement infini.
Non fonctionnelles : p99 de chargement du fil sous 200 ms ; une nouvelle publication apparaît chez les abonnés en quelques secondes (pas forcément instantanément) ; le système tient quand une célébrité publie.
| Hypothèse | Valeur | Conséquence |
|---|---|---|
| Utilisateurs actifs quotidiens | 300 M | |
| Chargements du fil par utilisateur et par jour | 10 | 3 Md de lectures/jour, ~35 k/s en moyenne, ~100 k/s en pic |
| Publications par jour | 50 M | ~600/s en moyenne |
| Abonnés moyens par auteur | 200 | 10 Md d'insertions de timeline/jour, ~115 k/s |
| Longueur de timeline conservée | 800 identifiants x 8 octets | ~6,4 Ko/utilisateur, ~2 To bruts pour tous avant le surcoût de Redis |
Deux choses sautent aux yeux. Les lectures du fil dominent le volume de requêtes. Mais le fan-out multiplie les écritures par le nombre d'abonnés, donc ce sont les insertions dans les timelines, et non la création de publications, qui forment la plus grosse charge d'écriture. Toute conception doit en tenir compte.
Twitter a publié des chiffres de la même forme en 2012 : environ 300 000 lectures de timeline par seconde pour quelque 6 000 tweets écrits par seconde, des timelines d'accueil plafonnées à 800 entrées dans Redis, et un fan-out qui prenait plusieurs minutes pour les comptes à dizaines de millions d'abonnés.
La décision centrale : quand le fil est-il construit ?
| Fan-out à l'écriture (push) | Fan-out à la lecture (pull) | |
|---|---|---|
| Moment du travail | À la publication, pousser l'identifiant dans la timeline de chaque abonné | À la lecture, récupérer les publications récentes de chaque compte suivi et fusionner |
| Coût de lecture | Une lecture de liste | N requêtes, une par compte suivi, plus la fusion |
| Coût d'écriture | Une insertion par abonné | Une insertion |
| Fraîcheur | Quelques secondes de retard dues au fan-out | Toujours frais |
| Travail gaspillé | Des timelines pour des utilisateurs qui n'ouvrent jamais l'app | Aucun |
| Casse avec | Les célébrités à millions d'abonnés | Les utilisateurs qui suivent des milliers de comptes |
Aucune approche pure ne survit au contact d'un vrai graphe social. Le push transforme une publication de célébrité en dizaines de millions d'écritures. Le pull transforme chaque chargement de fil en centaines de requêtes.
L'hybride vers lequel convergent les systèmes en production : push pour les comptes ordinaires, pull pour un petit ensemble de très gros comptes, fusion à la lecture. Twitter a décrit exactement cela. Multifeed de Facebook est allé plus loin vers l'assemblage à la lecture, avec des serveurs agrégateurs qui interrogent des magasins d'activité par utilisateur au moment où le fil est demandé. Les deux sont valables ; l'hybride est le plus facile à défendre en entretien et à exploiter à échelle modérée.
Le chemin de publication
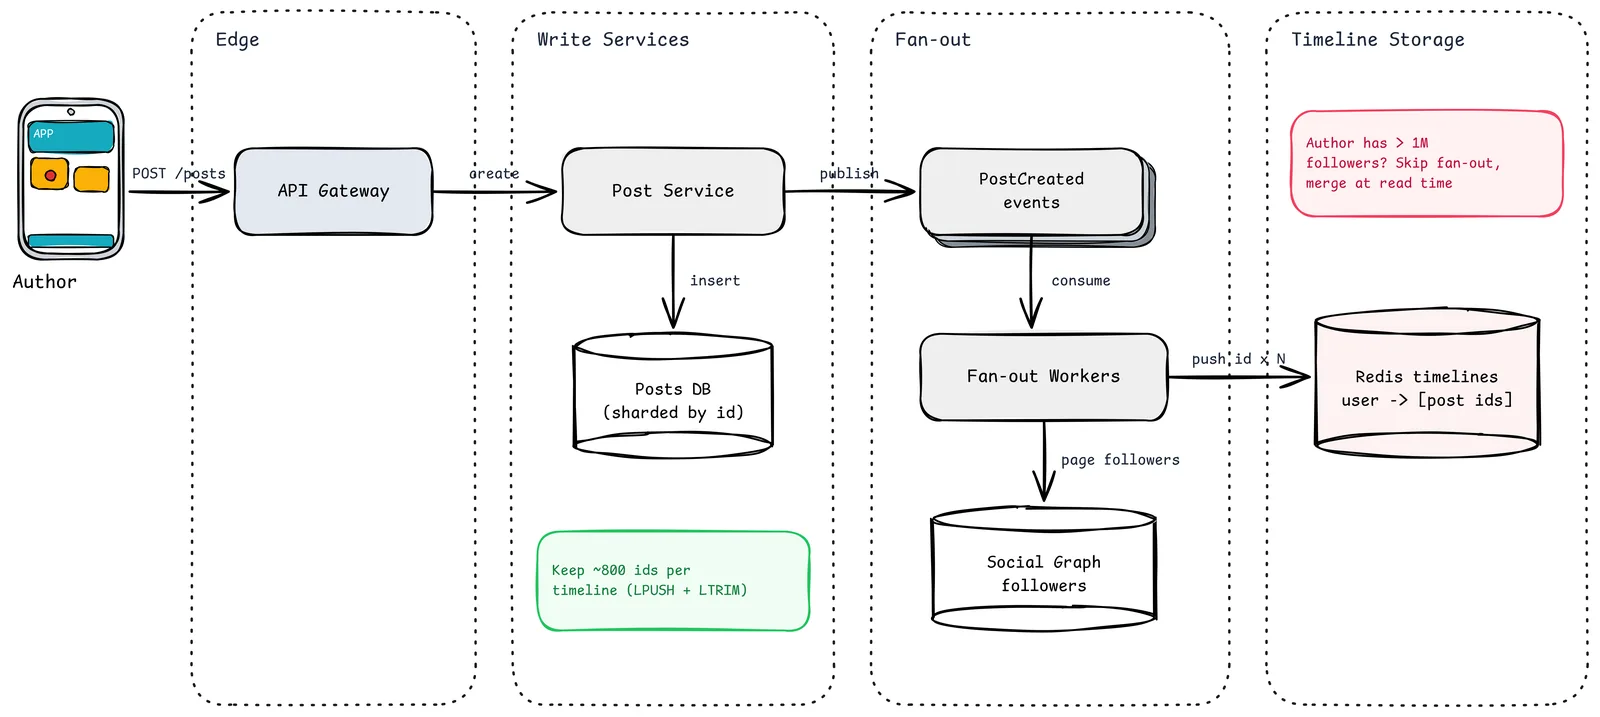
- Author. Publie. Les médias partent d'abord directement vers le stockage objet (URL présignées) ; la publication ne fait que les référencer.
- API Gateway. Authentification, limitation de débit, validation des requêtes.
- Post Service. Attribue un identifiant ordonné dans le temps (façon Snowflake, voir l'article sur les identifiants uniques), écrit la publication et répond immédiatement à l'utilisateur. Il n'attend pas le fan-out.
- Posts DB (partitionnée par identifiant). Source de vérité du contenu. Les identifiants ordonnés dans le temps font de « publications récentes de l'auteur X » une requête de plage bon marché avec un index sur
(author_id, post_id). - Événements PostCreated. Un journal durable découple la requête de l'utilisateur du coûteux fan-out. Si le fan-out prend du retard, publier fonctionne toujours.
- Fan-out Workers. Consomment les événements, parcourent les abonnés de l'auteur par lots de quelques milliers et poussent l'identifiant dans la timeline de chacun. Ils peuvent ignorer les abonnés inactifs depuis des semaines ; leur fil est reconstruit à la demande s'ils reviennent.
- Social Graph (abonnés). Un magasin optimisé pour « qui suit X » et « qui Y suit-il ». TAO de Facebook en est l'exemple canonique à grande échelle. À plus petite échelle, une table d'arêtes partitionnée avec deux index suffit.
- Timelines Redis. Une liste par utilisateur d'identifiants récents.
LPUSHdu nouvel identifiant,LTRIMà 800. Uniquement des identifiants, jamais des publications complètes, pour qu'une modification ou une suppression n'oblige pas à toucher des millions de listes.
La note rouge est la règle des célébrités : au-delà d'un seuil d'abonnés (un million est un bon point de départ), on saute entièrement le fan-out et ce sont les lecteurs qui vont chercher.
Le chemin de lecture
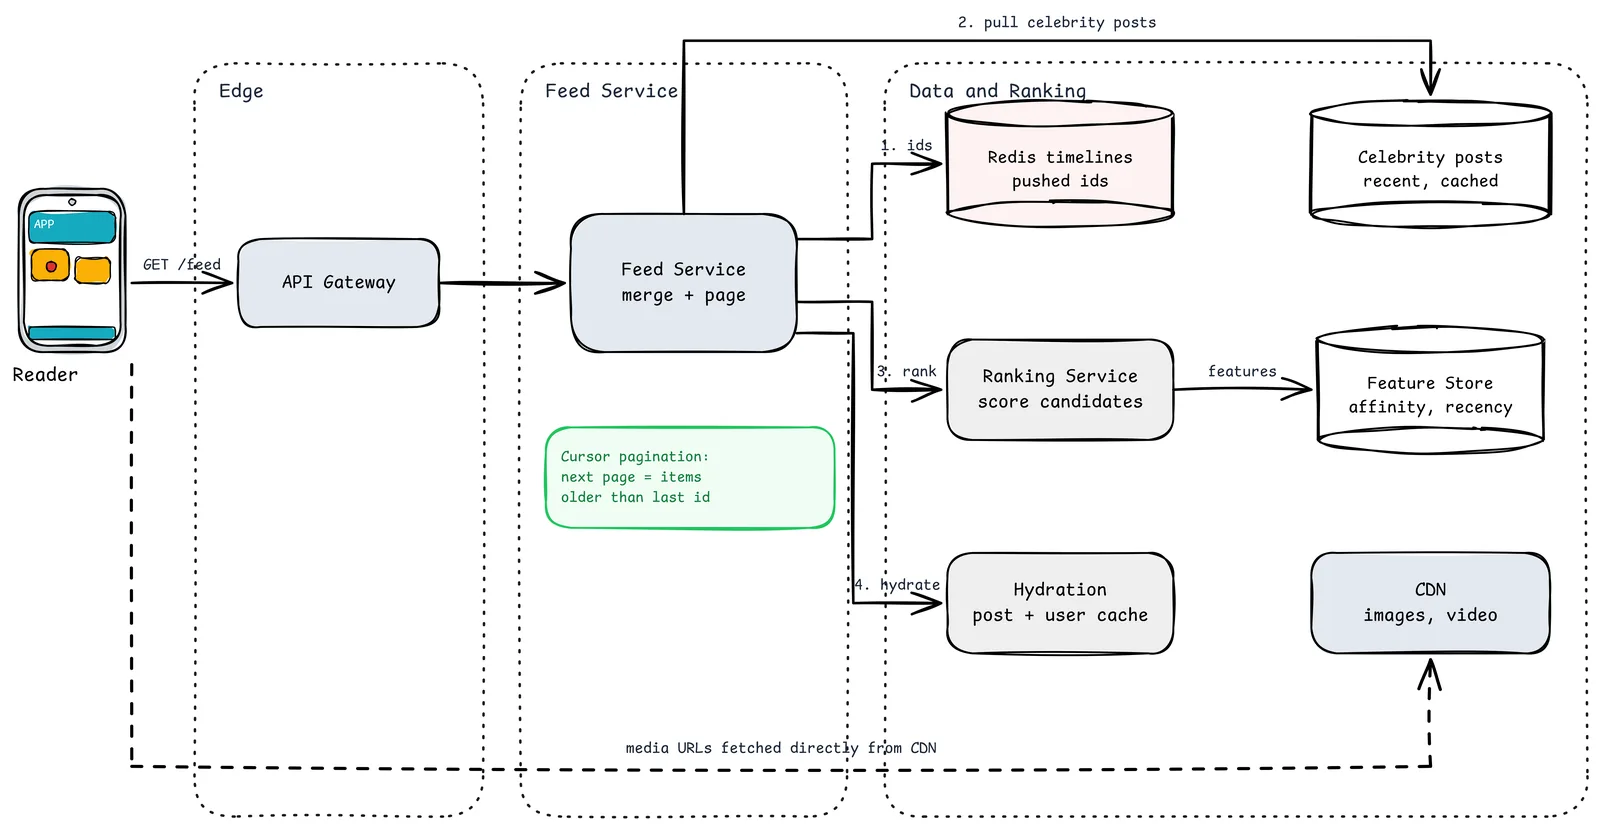
- Lire les identifiants poussés dans la timeline Redis de l'utilisateur.
- Récupérer les publications des célébrités. Pour la poignée de gros comptes suivis, aller chercher leurs identifiants récents dans un magasin très mis en cache de « publications récentes par auteur ». Comme beaucoup de lecteurs suivent les mêmes célébrités, ce cache a un excellent taux de succès.
- Classer. Fusionner les deux listes en un ensemble de candidats (quelques centaines de publications) et l'envoyer au service de classement, qui note les candidats à partir de signaux comme l'affinité avec l'auteur, l'âge de la publication, l'engagement déjà obtenu et le type de contenu.
- Hydrater. Récupérer en un seul appel groupé les corps de publications, profils d'auteurs et compteurs des meilleurs résultats, depuis les caches.
- Renvoyer une page avec un curseur. Les URL de médias pointent vers le CDN : images et vidéos ne transitent jamais par le service de fil.
La note verte concerne la pagination, facile à rater. Utilisez des curseurs, pas des offsets. Avec des offsets, une nouvelle publication arrivée entre la page 1 et la page 2 décale tout d'un cran, et les utilisateurs voient des doublons. Avec un curseur (« publications plus anciennes que l'identifiant X », ou un jeton opaque qui encode la position du classeur), les pages restent stables.
Le classement, du simple au réel
| Étape | Approche | Coût |
|---|---|---|
| Version 1 | Ordre antichronologique par identifiant | Rien. Les identifiants ordonnés dans le temps le rendent gratuit |
| Version 2 | Score heuristique : affinité x poids du contenu x décroissance temporelle | Quelques signaux par candidat ; facile à expliquer |
| Version 3 | Classement par apprentissage en deux étapes : génération de candidats peu coûteuse, puis un modèle appris sur quelques centaines | Magasin de caractéristiques, service de modèles, plateforme d'expérimentation |
Le premier EdgeRank de Facebook était une heuristique de version deux de cette forme exacte. La plupart des grands fils aujourd'hui sont en version trois. En entretien, commencez par la version un, décrivez la deux, et mentionnez l'existence de la trois. Ne concevez pas le système d'apprentissage sauf si on vous le demande.
Quel que soit le classement, gardez-le hors du chemin d'écriture. Il dépend du lecteur, de l'heure et d'un engagement qui n'a pas encore eu lieu : sa place est à la lecture.
Esquisse du modèle de données
| Magasin | Clé | Valeur | Remarques |
|---|---|---|---|
| Posts DB | post_id |
auteur, texte, références médias, created_at | Index sur (author_id, post_id) pour les timelines d'auteur |
| Graphe social | (follower_id, followee_id) |
created_at | Les deux sens indexés : abonnés de X, abonnements de Y |
| Timeline Redis | timeline:{user_id} |
liste d'identifiants | Plafonnée à 800 ; TTL pour les utilisateurs inactifs |
| Cache de publications | post:{post_id} |
publication sérialisée | Écriture directe à la création, invalidée à la modification ou suppression |
| Compteurs | post:{post_id}:likes |
entier | Séparés du corps ; mis à jour de façon asynchrone |
Ce qui tourne mal
| Problème | Symptôme | Remède |
|---|---|---|
| Publications de célébrités | La file de fan-out s'engorge pendant des minutes | Seuil d'abonnés ; pull à la lecture |
| Publication chaude | Compteurs et clé de cache d'une publication saturés | Compteurs partitionnés ; cache local ; comptes approximatifs |
| Publication supprimée encore visible | Les identifiants restent dans des millions de timelines | Filtrer à l'hydratation : publications absentes ou supprimées écartées |
| Retard du fan-out | Les nouvelles publications arrivent tard | Prioriser le fan-out vers les abonnés récemment actifs |
| Perte d'un nœud Redis | Certaines timelines vides | Reconstruction à la demande en allant chercher chez les auteurs suivis ; réplicas Redis |
| Utilisateurs qui suivent des milliers de comptes | Grosses fusions si beaucoup sont des « célébrités » | Plafonner les auteurs en pull ; compter sur le push pour le reste |
| Le fil montre deux fois la même publication | Pagination par offset | Pagination par curseur |
Conclusion d'entretien
Une réponse solide tient dans cet ordre :
- Exigences et chiffres de lecture et d'écriture, y compris le multiplicateur du fan-out.
- Tableau push contre pull, et pourquoi aucun ne suffit seul.
- Hybride avec seuil de célébrité.
- Chemin de publication avec workers de fan-out asynchrones et timelines d'identifiants seulement.
- Chemin de lecture : fusion, classement, hydratation, curseur.
- Un ou deux modes de défaillance (célébrités, suppressions).
Liste de contrôle pour la production
- Fan-out asynchrone ; publier ne l'attend jamais
- Les timelines ne stockent que des identifiants, avec longueur plafonnée et TTL pour les utilisateurs inactifs
- Seuil de célébrité configuré et surveillé (retard de fan-out selon la taille de l'auteur)
- Abonnés inactifs ignorés pendant le fan-out ; la reconstruction à la demande fonctionne
- L'hydratation filtre le contenu supprimé, privé et bloqué
- Pagination par curseur
- Classement isolé du chemin d'écriture, avec repli chronologique si le classeur tombe
- Tableaux de bord : p99 du fil, retard de la file de fan-out, taux de succès du cache de timelines, taille des lots d'hydratation
Ce qui reste
Le fil, c'est l'endroit où l'inégalité de votre graphe social devient un problème d'ingénierie. La plupart des gens ont quelques centaines d'abonnés. Quelques-uns en ont des dizaines de millions. Une seule conception ne peut pas servir les deux, alors on en construit deux et on les recoud au dernier moment possible.
Quelque part dans la file de fan-out, en ce moment, une publication de quelqu'un qui a dix abonnés attend derrière une pop star. L'hybride existe pour que cette publication arrive, elle aussi, à l'heure.
Sources
- High Scalability : The Architecture Twitter Uses to Deal with 150M Active Users, 300K QPS (conférence de Raffi Krikorian)
- Bronson et al., « TAO: Facebook's Distributed Data Store for the Social Graph » (USENIX ATC 2013)
- Facebook Engineering : Serving Facebook Multifeed
- Documentation Redis : listes (LPUSH, LTRIM)
- Dans la même série : Concevoir un générateur d'identifiants uniques, Concevoir un système de chat, Passer de zéro à des millions d'utilisateurs