TL;DR
- Le problème : Un limiteur de débit doit décider d'accepter ou de refuser chaque requête, de manière cohérente sur toute une flotte de passerelles, en ajoutant bien moins d'une milliseconde de latence, sans devenir lui-même la panne qu'il devait empêcher.
- La conception : Appliquer la limite dans la passerelle d'API. Construire la clé par tenant, utilisateur, IP et route. Exécuter un token bucket sous forme d'un script Lua atomique unique sur un cluster Redis partitionné, mettre en cache localement les clés chaudes, et décider par endpoint si une défaillance du limiteur échoue en mode ouvert ou fermé. Renvoyer
429avecRetry-Afteret des en-têtes de limite lisibles par machine.- Le résultat : Un aller-retour Redis par requête, des limites équitables entre de nombreux nœuds de passerelle, un comportement maîtrisé quand Redis ralentit, et des limites que les clients peuvent comprendre.
Toute API publique finit par apprendre la même leçon : la boucle de réessais d'un client est la panne d'un autre. Un limiteur de débit est l'assurance la moins chère contre cela et, comme la plupart des assurances, il ne compte que le pire jour de l'année.
Cet article en conçoit un comme on le ferait pour une vraie plateforme d'API. Il assume ses choix d'algorithme, reste précis sur l'implémentation Redis et honnête sur ce qui casse.
À quoi sert vraiment un limiteur de débit
Quand on dit « rate limiting », on désigne quatre choses différentes. L'article bien connu de Stripe sur ses limiteurs les distingue nettement, et la distinction tient toujours :
| Type de limiteur | Question à laquelle il répond | Règle typique |
|---|---|---|
| Limiteur de débit de requêtes | Ce client envoie-t-il trop de requêtes par unité de temps ? | 100 requêtes par seconde par clé d'API |
| Limiteur de requêtes concurrentes | Ce client a-t-il trop de requêtes en cours ? | 20 recherches coûteuses simultanées par utilisateur |
| Délestage de la flotte | Le système entier approche-t-il de sa capacité ? | Réserver 20 % de la capacité au trafic critique |
| Délestage par utilisation des workers | Ce groupe de workers est-il saturé ? | Abandonner les tâches peu prioritaires quand le groupe est occupé à 90 % |
Cet article se concentre sur le premier, celui auquel pensent les recruteurs et la plupart des équipes produit. Les trois autres méritent d'être nommés, car un limiteur de débit seul ne vous protégera pas d'un client unique qui lance quelques requêtes très coûteuses.
Exigences et budget
- Décider en ajoutant moins de 1 ms de latence p99 dans la passerelle.
- Appliquer les limites globalement sur de nombreux nœuds de passerelle, pas nœud par nœud.
- Gérer des règles par tenant, utilisateur, clé d'API, IP et route, avec différents niveaux (gratuit, pro, entreprise).
- Tolérer les rafales légitimes (une page qui déclenche 15 appels d'API au chargement) sans laisser passer l'abus soutenu.
- Se dégrader de façon prévisible quand le magasin d'état du limiteur lui-même est lent ou indisponible.
- Indiquer aux clients quand réessayer.
À 200 000 requêtes par seconde sur la flotte, un aller-retour vers le magasin d'état par requête représente 200 000 opérations par seconde. Une seule partition Redis gère sans difficulté de l'ordre de 100 000 opérations simples par seconde : prévoyez donc un cluster partitionné avec de la marge, plus un cache local pour les clés les plus chaudes.
Choisir l'algorithme
| Algorithme | Fonctionnement | Comportement en rafale | Mémoire par clé | Précision | Où on le trouve |
|---|---|---|---|---|---|
| Fenêtre fixe | Compte les requêtes par fenêtre calendaire (par exemple par minute) | Autorise le double de la limite à la frontière de fenêtre | Un compteur | Faible aux bords | Quotas simples, plafonds journaliers |
| Journal glissant | Stocke chaque horodatage et compte ceux de la dernière fenêtre | Pas de rafale à la frontière | Une entrée par requête | Exacte | Endpoints à faible volume et forte valeur |
| Compteur à fenêtre glissante | Mélange pondéré de la fenêtre fixe courante et de la précédente | Lisse les bords | Deux compteurs | Approchée, très proche en pratique | Cloudflare a décrit cette approche pour sa limitation en périphérie |
| Token bucket | Seau de capacity jetons rechargé à rate ; chaque requête consomme des jetons |
Autorise des rafales jusqu'à la capacité, puis un débit constant | Deux nombres | Exacte pour son modèle | Passerelles d'API, API des fournisseurs cloud |
| Leaky bucket | Les requêtes sont mises en file et s'écoulent à débit fixe | Lisse la sortie, ajoute de la latence | File | Exacte | Mise en forme du trafic |
| GCRA | Suit un unique « temps d'arrivée théorique » | Identique au token bucket | Un horodatage | Exacte | Héritage télécom ; bibliothèques comme redis-cell |
Mon choix par défaut est le token bucket. Il exprime les deux nombres qui intéressent vraiment les équipes produit (débit soutenu et taille de rafale), coûte deux champs par clé et s'explique facilement aux clients : « 100 par seconde, avec des rafales jusqu'à 200 ».
Le problème de frontière de la fenêtre fixe mérite d'être énoncé en entretien : avec une limite de 100 par minute, un client peut envoyer 100 requêtes à 12:00:59 et 100 de plus à 12:01:00, soit 200 requêtes en deux secondes.
Où vit le limiteur
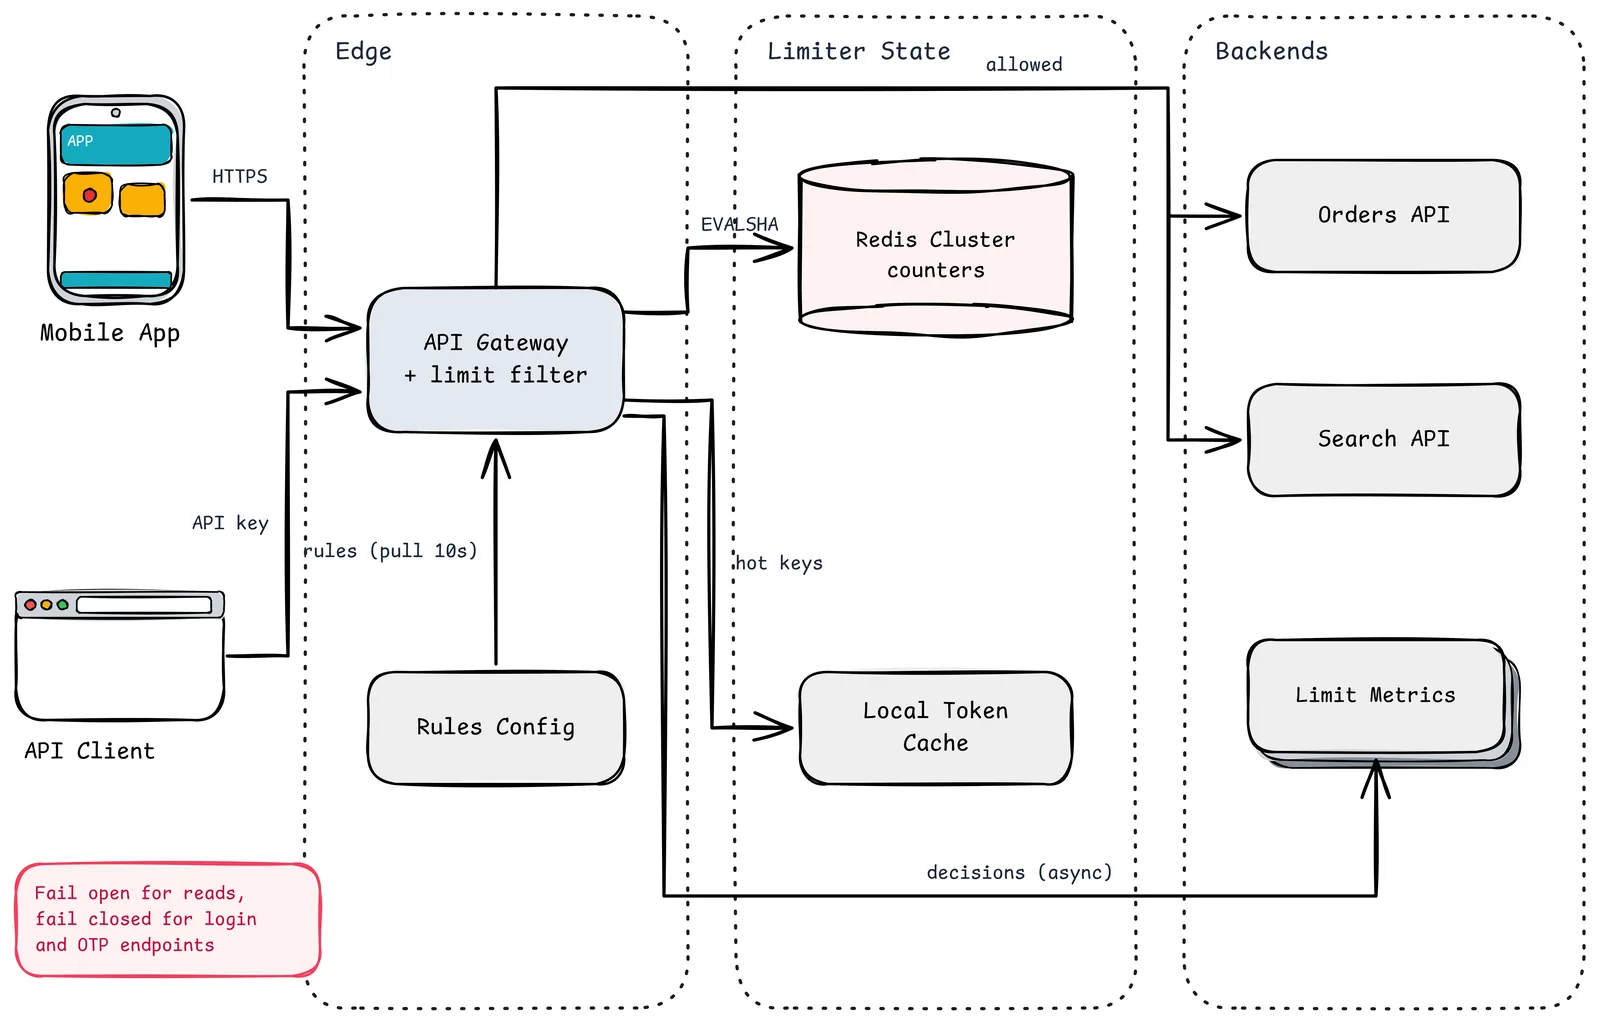
- Mobile App / API Client. Des appelants non fiables. Certains sont bogués, quelques-uns hostiles, la plupart corrects.
- API Gateway + filtre de limitation. Le point d'application. Elle analyse déjà l'authentification et le routage, donc elle dispose de l'identité et de la route nécessaires pour construire la clé. Appliquer la limite ici protège tous les backends avec une seule implémentation (le service de rate limit global d'Envoy et la plupart des passerelles managées suivent ce schéma).
- Rules Config. Un petit service ou dépôt de configuration qui définit les limites par niveau, tenant et route. Les passerelles récupèrent les règles toutes les quelques secondes et les gardent en mémoire : une panne de configuration ne bloque jamais le trafic.
- Redis Cluster (compteurs). L'état partagé. Chaque décision est un
EVALSHAd'un script Lua préchargé, ce qui rend la lecture, la recharge et la décrémentation atomiques. - Local Token Cache. Pour une poignée de clés extrêmement chaudes (un gros tenant qui martèle une route), les passerelles peuvent louer à Redis un petit lot de jetons et les consommer localement, en échangeant un peu de précision contre beaucoup moins d'allers-retours.
- Orders API / Search API. Les backends ne voient que le trafic autorisé. Les routes coûteuses (recherche) ont des limites plus strictes que les routes bon marché (lecture des commandes).
- Limit Metrics. Chaque décision est émise de façon asynchrone, pour voir qui est limité, ajuster les règles et repérer les faux positifs. Ce flux ne doit jamais se trouver sur le chemin de la requête.
La note rouge du schéma représente la décision de politique la plus importante de ce système ; elle est traitée plus bas.
Le chemin de décision d'une requête
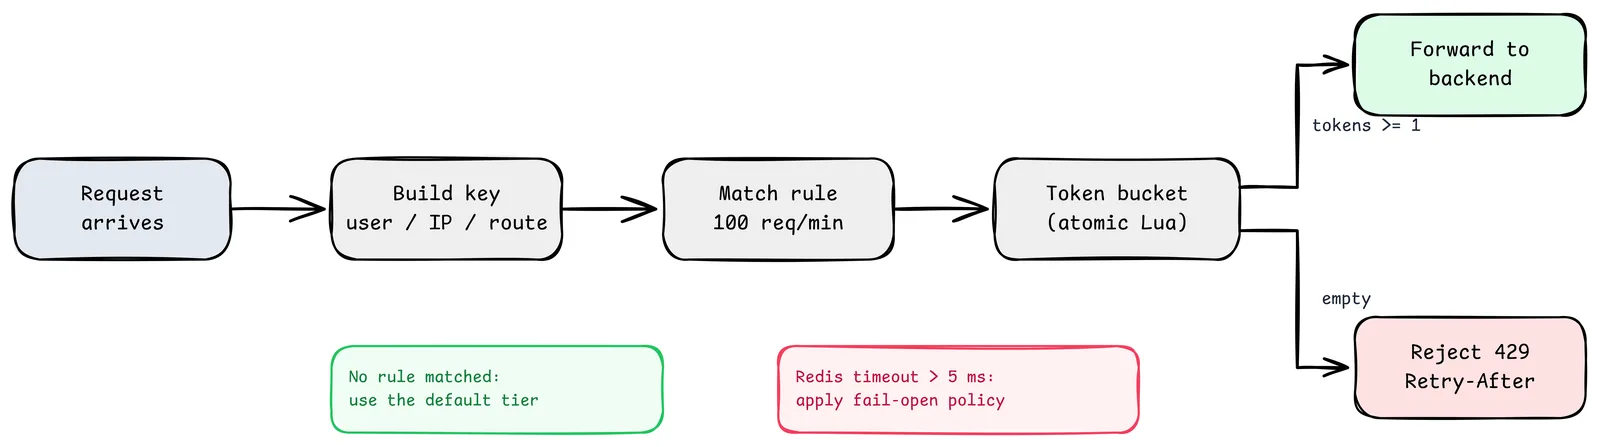
- Construire la clé. Par exemple
rl:{tenant:acme}:route:search. Les accolades forment un hash tag Redis Cluster, qui place toutes les clés d'un tenant dans le même slot si vous avez un jour besoin d'opérations multi-clés. - Trouver la règle. La plus spécifique l'emporte : exception du tenant pour la route, puis niveau du tenant, puis niveau par défaut. Une requête sans règle correspondante reçoit quand même la règle par défaut, jamais « illimité ».
- Exécuter le seau de façon atomique. Lire, recharger, consommer et écrire doivent former une seule opération. Deux passerelles qui lisent puis écrivent en parallèle verront chacune un jeton et le consommeront toutes les deux.
- Accepter ou rejeter. Les requêtes acceptées continuent avec des en-têtes décrivant le budget restant. Les requêtes rejetées reçoivent
429 Too Many Requestset unRetry-After.
Voici le seau complet sous forme de script Lua Redis. Il utilise l'heure du serveur Redis plutôt que l'horloge de la passerelle, ce qui élimine le décalage d'horloge entre nœuds.
-- KEYS[1]: bucket key   ARGV[1]: capacity   ARGV[2]: refill tokens/sec   ARGV[3]: cost
local cap, rate, cost = tonumber(ARGV[1]), tonumber(ARGV[2]), tonumber(ARGV[3])
local t = redis.call('TIME')  -- Redis 5+ replicates script effects, so TIME is safe here
local now = tonumber(t[1]) * 1000 + math.floor(tonumber(t[2]) / 1000)

local b = redis.call('HMGET', KEYS[1], 'tokens', 'ts')
local tokens = tonumber(b[1]) or cap
local ts = tonumber(b[2]) or now

tokens = math.min(cap, tokens + (now - ts) / 1000 * rate)
local allowed = 0
if tokens >= cost then
  tokens = tokens - cost
  allowed = 1
end

redis.call('HSET', KEYS[1], 'tokens', tokens, 'ts', now)
redis.call('PEXPIRE', KEYS[1], math.ceil(cap / rate * 1000) + 1000)

local retry_ms = 0
if allowed == 0 then retry_ms = math.ceil((cost - tokens) / rate * 1000) end
return { allowed, math.floor(tokens), retry_ms }
Le PEXPIRE compte plus qu'il n'y paraît : les seaux inactifs expirent dès qu'ils auraient été entièrement rechargés, donc la mémoire suit le nombre de clients actifs, pas celui de tous les clients ayant jamais existé.
Dire aux clients ce qui s'est passé
Un limiteur qui rejette sans explication génère des tickets de support et aggrave les réessais côté client.
- Statut :
429 Too Many Requests(défini dans la RFC 6585). N'utilisez pas503pour des limites par client ; cela leur dit que tout le service est en panne. Retry-After: le nombre de secondes avant qu'un réessai ait des chances d'aboutir (RFC 9110). Le script Lua ci-dessus renvoie exactement ce nombre.- En-têtes de budget : l'API de GitHub renvoie
x-ratelimit-limit,x-ratelimit-remainingetx-ratelimit-resetà chaque réponse, et le groupe de travail HTTPAPI de l'IETF normalise les champsRateLimitetRateLimit-Policy. Choisissez une convention et documentez-la. - Consignes aux clients : publiez qu'ils doivent réessayer avec un délai exponentiel et du jitter. Sans jitter, tous les clients limités réessaient au même instant et vous obtenez une ruée synchronisée.
Échec ouvert ou fermé ?
Quand Redis est lent ou injoignable, le limiteur doit deviner. Il n'existe pas de bonne réponse universelle, c'est pourquoi le choix doit se configurer par route, et non globalement.
| Type de route | Politique | Pourquoi |
|---|---|---|
| Lectures, navigation du catalogue, la plupart des API | Échec ouvert | Une panne du limiteur ne doit pas devenir une panne totale. Les backends ont leur propre délestage |
| Connexion, réinitialisation de mot de passe, vérification OTP | Échec fermé | Ces limites existent pour bloquer le bourrage d'identifiants et la force brute. Échouer en mode ouvert retire la protection précisément quand un attaquant pourrait être à l'origine de l'instabilité |
| Écritures coûteuses, paiements | Échec fermé, ou repli sur une limite locale prudente | Ici, la surcharge coûte cher et se répare mal |
Fixez un délai d'expiration court sur l'appel Redis (quelques millisecondes). Un limiteur qui attend Redis pendant 2 secondes a déjà échoué, simplement plus lentement.
Les problèmes qui surgissent à grande échelle
Les clés chaudes. Un tenant énorme peut concentrer une grande part du trafic sur une seule clé Redis, donc sur une seule partition. Solutions : découper la clé (rl:{acme}:search:0..7, chacune avec un huitième du débit) ou louer des jetons par lots aux passerelles via le cache local. Les deux échangent un peu de précision contre du débit.
Le multi-région. Une limite globale entre régions exige soit un magasin global (latence), soit un budget partagé (chaque région reçoit une part, rééquilibrée périodiquement). La plupart des systèmes choisissent des budgets par région et acceptent qu'un client qui sollicite deux régions obtienne un peu plus que la limite nominale.
Le décalage d'horloge. Utiliser l'horloge des passerelles dans le calcul du seau fait diverger deux nœuds sur le temps écoulé. Utiliser TIME de Redis, comme ci-dessus, l'évite. Si votre magasin n'a pas d'horloge serveur, utilisez un temps monotone sur une autorité unique.
Les réessais amplifient la charge. Clients, SDK et service meshes réessaient tous. Si chaque couche réessaie trois fois, une requête utilisateur peut devenir des dizaines. Comptez les réessais sur le même budget, et assurez-vous que les réessais internes respectent aussi Retry-After.
Les limites font partie du produit. Elles appartiennent à votre tarification et à votre contrat. Les modifier en silence casse des intégrations. Versionnez-les et annoncez-les comme une API.
Une réponse calibrée pour l'entretien
- Clarifiez ce qui est limité (par utilisateur, par IP, par clé) et si les limites sont strictes ou souples.
- Placez le limiteur dans la passerelle, avec l'état partagé dans Redis.
- Choisissez le token bucket, en vous appuyant sur le problème de frontière de la fenêtre fixe.
- Rendez la vérification atomique avec un script Lua.
- Renvoyez
429avecRetry-After. - Discutez de l'échec ouvert ou fermé par endpoint et du problème des clés chaudes.
Cela couvre ce que la plupart des recruteurs veulent entendre. Le reste est de la profondeur à proposer si le temps le permet.
Liste de contrôle pour la production
- Règles définies par niveau, tenant et route, avec un niveau par défaut pour tout le reste
- Vérification et consommation atomiques (Lua ou opération équivalente côté serveur)
- Heure du serveur pour le calcul du seau
- Les clés de seau expirent quand elles sont inactives
- Délai d'expiration court sur le magasin d'état, avec une politique d'échec ouvert ou fermé par route
-
429,Retry-Afteret en-têtes de budget documentés pour les clients - Atténuation des clés chaudes (clés découpées ou location locale de jetons)
- Décisions envoyées aux métriques ; tableaux de bord du taux de limitation par tenant et par route
- Limites de concurrence séparées pour les endpoints coûteux
- Test de charge incluant un Redis lent, pas seulement un Redis en panne
Ce qui reste
Le limiteur de débit est le seul composant dont le rôle est de dire non à vos propres clients. S'il est un peu mal réglé, ceux que vous limitez sont vos meilleurs clients, ceux dont les intégrations ont grandi plus vite que vos règles.
Alors journalisez chaque rejet, et lisez le journal. Quelque part là-dedans se trouve un client que vous auriez dû appeler au lieu de le limiter.
Sources
- Stripe : Scaling your API with rate limiters
- Cloudflare : How we built rate limiting capable of scaling to millions of domains
- Envoy proxy : global rate limiting
- RFC 6585 : Additional HTTP Status Codes (429)
- Projet IETF : RateLimit header fields for HTTP
- GitHub REST API : rate limits
- Redis : scripting with Lua
- Dans la même série : Concevoir un raccourcisseur d'URL, Motifs de cache avec Redis