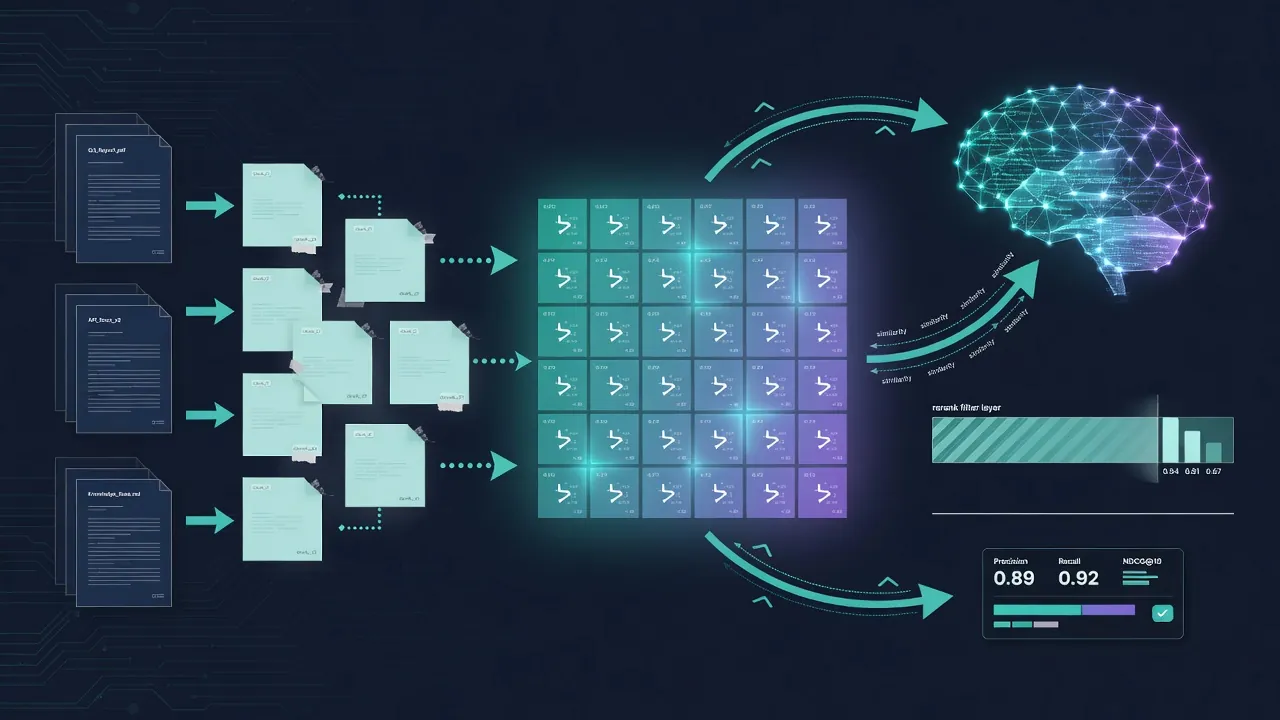
रिट्रीवल-ऑगमेंटेड जनरेशन (आरएजी) स्लाइड पर आसान लगता है: दस्तावेज़ एम्बेड करो, वेक्टर स्टोर करो, टॉप-के निकालो, प्रॉम्प्ट में डालो, जवाब बनाओ। प्रोडक्शन में यह पाइपलाइन हर चरण पर गुणवत्ता गँवाती है। यह पोस्ट एक ठोस, व्यावहारिक आरएजी स्टैक का वॉकथ्रू है: वे फ़ैसले जो सच में नतीजा बदलते हैं, और वे मामले जहाँ आरएजी गलत औज़ार है।
ज्ञान यहाँ २०२६ की शुरुआत तक के फ्रेम में है। टूल के नाम बदलते रहते हैं; फेल होने के तरीके ज़्यादातर नहीं।
आप असल में क्या बना रहे हैं
एक उपयोगी मानसिक मॉडल पाँच चरणों का है:
१. स्रोत कॉर्पस को इन्जेस्ट और चंक करना, ताकि मॉडल उन्हें इस्तेमाल कर सके। २. उन इकाइयों को एम्बेड करना (और अक्सर कीवर्ड इंडेक्स भी रखना)। ३. क्वेरी के लिए उम्मीदवार रिट्रीव करना (डेंस, स्पार्स, या हाइब्रिड)। ४. उन उम्मीदवारों को मज़बूत, धीमे मॉडल से रीरैंक करना। ५. जनरेट करना, फिर ग्राउंड ट्रुथ के मुकाबले मूल्यांकन करना ताकि लूप सुधरे।
मूल्यांकन छोड़ दिया तो आप महज़ अनुमान से ट्यूनिंग कर रहे हैं। रीरैंकिंग और हाइब्रिड सर्च छोड़ दिया तो एम्बेडिंग मॉडल को उन समस्याओं का श्रेय मिलेगा जिन्हें वह ठीक नहीं कर सकता।
Documents -> Chunker -> Embedder -> Vector store (+ BM25)
                              ^
User query ------------------+--> Hybrid retrieve -> Rerank -> Prompt + LLM -> Answer
                                                              |
                                                         Eval harness (offline)
चरण १: चंकिंग (जहाँ शुरुआत में ही गुणवत्ता गिरती है)
एम्बेडिंग दस्तावेज़ों को "समझ" नहीं लेती। वे उसी इकाई पर समानता स्कोर करती हैं जो आपने स्टोर की। गलत चंक बाउंड्री से रिट्रीवल खराब होता है, मॉडल कोई भी हो।
व्यावहारिक डिफ़ॉल्ट
| रणनीति | सामान्य आकार | कब काम करती है | आम विफलता |
|---|---|---|---|
| ओवरलैप के साथ निश्चित टोकन | २५६-५१२ टोकन, १०-२०% ओवरलैप | समान गद्य, नीतियाँ, विकी | टेबल, कोड, प्रक्रिया बीच में कट जाती है |
| संरचना-आधारित (हेडिंग, सेक्शन) | सेक्शन लंबाई सीमित | मार्कडाउन, डॉक्स साइट, हैंडबुक | बहुत बड़े सेक्शन पर फिर काटना पड़ता है |
| सिमेंटिक / रिकर्सिव स्प्लिटर | परिवर्तनीय | मिश्रित कॉर्पस | डिबग मुश्किल; स्प्लिटर बदलने पर ड्रिफ्ट |
| पेरेंट-चाइल्ड (छोटा रिट्रीव, बड़ा कॉन्टेक्स्ट) | चाइल्ड ~१२८-२५६, पेरेंट ~१k+ | लंबे मैनुअल | इंडेक्स जटिलता और स्टोरेज बढ़ता है |
व्यवहार में टिकने वाले नियम:
- स्रोत में हेडिंग हों तो शुद्ध टोकन विंडो से संरचना बेहतर है।
- जहाँ हो सके एक विचार प्रति चंक रखें। प्रक्रिया और एपीआई उदाहरण बीच में न काटें।
- समृद्ध मेटाडेटा रखें: स्रोत पथ, शीर्षक, सेक्शन, उत्पाद संस्करण, भाषा, अंतिम अपडेट, एक्सेस एसीएल।
- ओवरलैप निरंतरता में मदद करता है, पर ५०% ओवरलैप ज़्यादातर स्टोरेज जलाता है और डेडअप उलझाता है।
- टेबल के लिए गद्य सारांश चंक और जहाँ सही नंबर चाहिए वहाँ संरचित टेबल भी रखें।
उदाहरण स्केच (पायथन-जैसा, लाइब्रेरी-अज्ञेय):
def chunk_markdown(md: str, max_tokens: int = 400, overlap: int = 40):
    sections = split_on_headings(md)  # # / ## बाउंड्री रखें
    chunks = []
    for section in sections:
        if token_len(section) <= max_tokens:
            chunks.append(section)
        else:
            chunks.extend(sliding_window(section, max_tokens, overlap))
    return chunks
अगर रिट्रीवल कमज़ोर है, एम्बेडिंग मॉडल बदलने से पहले फिर चंक करें। यह सुधार सस्ता है और अक्सर सही है।
चरण २: एम्बेडिंग
आपका एम्बेडिंग मॉडल सर्च की ज्यामिति तय करता है। २०२५-२०२६ में ओपन मल्टीलिंगुअल मॉडल और मज़बूत कमर्शियल एपीआई दोनों चलते हैं; चुनाव लेटेंसी, लागत, भाषा कवरेज, और डेटा वीपीसी से बाहर जा सकता है या नहीं, पर निर्भर करता है।
चयन चेकलिस्ट
- डायमेंशन और लागत: ऊँचे डायमेंशन स्केल पर मुफ़्त नहीं (स्टोरेज + एएनएन मेमोरी)।
- अधिकतम इनपुट लंबाई: चंक ५१२ टोकन हों और एम्बेडर २५६ का हो तो चुपचाप ट्रंकेट हो जाता है।
- डोमेन: कानूनी, मेडिकल, कोड कॉर्पस में अक्सर डोमेन-ट्यूनड एम्बेडिंग चाहिए।
- वर्शन पिन: प्रोडक्शन में कभी "latest" न लगाएँ। पूरा कॉर्पस फिर एम्बेड करना माइग्रेशन है।
- क्वेरी और डॉक्यूमेंट के लिए वही मॉडल, जब तक आप जान-बूझकर असिमेट्रिक पेयर न इस्तेमाल करें।
इंडेक्स सुझाव:
- अधिकांश ऐप-स्केल कॉर्पस के लिए HNSW या प्रबंधित समकक्ष।
- कॉसाइन सिमिलैरिटी पर वेक्टर नॉर्मलाइज़ करें (कई क्लाइंट यह खुद करते हैं)।
- वेक्टर के साथ कच्चा टेक्स्ट रखें। प्रॉम्प्ट, उद्धरण और री-इंडेक्स के लिए चाहिए।
# स्यूडोकोड: embed और upsert
vectors = embed_model.encode(chunk_texts, normalize=True)
store.upsert([
    {"id": ids[i], "vector": vectors[i], "text": chunk_texts[i], "meta": metas[i]}
    for i in range(len(ids))
])
चरण ३: रिट्रीवल (केवल डेंस काफी नहीं)
शुद्ध वेक्टर सर्च सटीक पहचान पर फेल होता है: एरर कोड, एसकेयू, फ़ंक्शन नाम, इनवॉइस नंबर, पॉलिसी आईडी। शुद्ध कीवर्ड सर्च पैराफ़्रेज़ पर फेल होता है। गंभीर ऐप्स के लिए हाइब्रिड रिट्रीवल डिफ़ॉल्ट होना चाहिए।
एक ठोस हाइब्रिड पैटर्न
१. डेंस सर्च (टॉप ३०-५०)। २. BM25 / स्पार्स सर्च (टॉप ३०-५०)। ३. Reciprocal Rank Fusion (RRF) या वेटेड स्कोर फ़्यूज़न से मिलाएँ। ४. लगभग एक जैसे चंक हटाएँ (एक स्रोत + ज़्यादा टेक्स्ट ओवरलैप)। ५. फ़्यूज़्ड शॉर्टलिस्ट रीरैंकर को दें।
def rrf(rank_lists, k=60):
    scores = {}
    for ranks in rank_lists:
        for rank, doc_id in enumerate(ranks, start=1):
            scores[doc_id] = scores.get(doc_id, 0.0) + 1.0 / (k + rank)
    return sorted(scores, key=scores.get, reverse=True)
क्वेरी-साइड सुधार जो मायने रखते हैं
- क्वेरी रीराइट: संक्षिप्त रूप खोलें, सेशन कॉन्टेक्स्ट से उत्पाद नाम जोड़ें।
- मल्टी-क्वेरी: २-४ पैराफ़्रेज़ बनाएँ, प्रत्येक पर रिट्रीव करें, फिर फ़्यूज़ करें।
- पहले फ़िल्टर: एसीएल, टेनेंट, भाषा, वर्शन फ़िल्टर एएनएन से पहले या उसके अंदर लगाएँ, जनरेशन के बाद नहीं।
- HyDE (काल्पनिक दस्तावेज़ एम्बेडिंग) विरल कॉर्पस में मदद कर सकता है; नापें, मान लें नहीं।
अगर उपयोगकर्ता मल्टी-हॉप पूछते हैं ("२०२४ के बदलाव के बाद प्लान ए और बी की कीमत तुलना"), एक शॉट टॉप-के अक्सर फेल होता है। मल्टी-स्टेप रिट्रीवल या ग्राफ़/संरचित लेयर चाहिए। यह प्रॉम्प्ट ट्वीक नहीं, प्रोडक्ट निर्णय है।
चरण ४: रीरैंकिंग
बाय-एनकोडर (क्वेरी और डॉक अलग एम्बेड) तेज़ और लगभग सही होते हैं। क्रॉस-एनकोडर रीरैंकर क्वेरी और दस्तावेज़ साथ पढ़ता है और शॉर्टलिस्ट का क्रम अक्सर काफी बेहतर करता है।
सामान्य पैटर्न:
- सस्ते में ३०-५० उम्मीदवार रिट्रीव करें।
- प्रॉम्प्ट के लिए टॉप ५-१० पर रीरैंक करें।
- लेटेंसी बजट रखें: रीरैंकर महँगे हैं; दोहराव ट्रैफ़िक पर (क्वेरी हैश, डॉक आईडी) कैश करें।
pairs = [(query, doc["text"]) for doc in candidates]
scores = reranker.predict(pairs)
top = [doc for _, doc in sorted(zip(scores, candidates), reverse=True)[:8]]
रीरैंकिंग सबसे ज़्यादा कब मदद करती है: मिलती-जुलती नीतियाँ, लगभग डुप्लिकेट मैनुअल, "लगभग सही सेक्शन" का शोर। कब नहीं: खाली या गलत कॉर्पस, बुरी चंकिंग, या ऐसी बातें जिन्हें उद्धरण नहीं बल्कि गणना चाहिए।
चरण ५: जनरेशन प्रॉम्प्ट (सादा और सख्त)
जनरेटर सीमित होना चाहिए:
- केवल दिए गए कॉन्टेक्स्ट से जवाब।
- चंक आईडी या स्रोत पथ उद्धृत करें।
- कॉन्टेक्स्ट अधूरा हो तो मुझे नहीं पता कहें।
- नंबर और कानूनी भाषा के लिए एक्सट्रैक्टिव उद्धरण प्राथमिकता दें।
स्केच:
आप सपोर्ट असिस्टेंट हैं। केवल CONTEXT ब्लॉक इस्तेमाल करें।
अगर जवाब CONTEXT में नहीं है, कहें कि आपको नहीं पता।
स्रोत [n] से उद्धृत करें जो ब्लॉक नंबर से मेल खाते हों।

QUESTION: {question}

CONTEXT:
[1] {chunk_1}
[2] {chunk_2}
...
तथ्यात्मक सपोर्ट बॉट के लिए तापमान कम रखें। २० लंबे चंक न ठूँसें; लागत, लेटेंसी और lost-in-the-middle बढ़ते हैं। रीरैंक के बाद ४-८ केंद्रित चंक २० औसत चंक से बेहतर हैं।
चरण ६: मूल्यांकन (इसके बिना आप अनुमान लगा रहे हैं)
ऑफ़लाइन इवल से आप चंक आकार, मॉडल और प्रॉम्प्ट की तुलना बिना यूज़र पर रिग्रेशन भेजे कर सकते हैं।
छोटा गोल्डन सेट बनाएँ
टिकट, सर्च लॉग या विशेषज्ञों से ५०-२०० असली सवाल लें। हर आइटम में रखें:
- सवाल
- अपेक्षित जवाब (या मुख्य तथ्य)
- संबंधित डॉक / चंक आईडी (लेबल)
- वैकल्पिक: हार्ड नेगेटिव
पाइपलाइन चरणों से जुड़े मेट्रिक्स
| चरण | मेट्रिक | क्या बताता है |
|---|---|---|
| रिट्रीवल | Recall@k, MRR, nDCG | सही चंक शॉर्टलिस्ट में आया या नहीं? |
| रीरैंक | रीरैंक के बाद nDCG / MRR | क्रम सुधरा या नहीं? |
| जनरेशन | Faithfulness / groundedness | मॉडल ने तथ्य गढ़े या नहीं? |
| जनरेशन | आंसर रेलेवंस | सवाल पर बात हुई या नहीं? |
| एंड-टू-एंड | Exact match / F1 / रूब्रिक वाला LLM-as-judge | कुल गुणवत्ता |
व्यावहारिक लूप:
१. पहले रिकॉल ठीक करें (चंकिंग, हाइब्रिड, फ़िल्टर)। २. फिर प्रॉम्प्ट पर प्रिसिज़न (रीरैंक, कम लेकिन बेहतर चंक)। ३. फिर जनरेशन कसें (प्रॉम्प्ट, उद्धरण, इनकार व्यवहार)। ४. चंकर, एम्बेडर वर्शन या सिस्टम प्रॉम्प्ट के हर बदलाव पर सूट फिर चलाएँ।
ऑनलाइन संकेत भी ज़रूरी हैं: थम्स डाउन, मानव को एस्केलेशन, उद्धरण क्लिक, "मददगार नहीं" टैग। ऑफ़लाइन गोल्डन सेट पुराने पड़ते हैं; तिमाही रीफ़्रेश करें।
न्यूनतम रेफ़रेंस आर्किटेक्चर
मध्यम आकार के आंतरिक नॉलेज बॉट (दसियों हज़ार पेज) के लिए:
| घटक | व्यावहारिक चुनाव |
|---|---|
| इन्जेस्ट | शेड्यूल्ड क्रॉलर + डॉक अपडेट पर वेबहुक |
| चंक | संरचना-आधारित मार्कडाउन/एचटीएमएल, ३००-५०० टोकन, मेटाडेटा समृद्ध |
| एम्बेड | एक पिन किया मल्टीलिंगुअल मॉडल; वर्शन बदलने पर बैच री-एम्बेड |
| स्टोर | Postgres + pgvector या प्रबंधित वेक्टर डीबी; BM25 उसी सिस्टम या OpenSearch में |
| रिट्रीव | हाइब्रिड + मेटाडेटा फ़िल्टर + RRF |
| रीरैंक | टॉप ४० पर क्रॉस-एनकोडर या एपीआई रीरैंकर |
| एलएलएम | जिस पर लेटेंसी/लागत का भरोसा हो; कम तापमान |
| इवल | सीआई में गोल्डन सेट; recall@10 रिग्रेशन पर डिप्लॉय रोकें |
| ऑब्ज़र्वेबिलिटी | क्वेरी, रिट्रीव्ड आईडी, स्कोर, अंतिम उद्धरण, लेटेंसी ब्रेकडाउन लॉग करें |
पाँच एजेंट फ़्रेमवर्क की ज़रूरत नहीं। अच्छे चंकिंग और इवल वाला सादा पाइपलाइन, गंदे इंडेक्स पर चतुर एजेंट ग्राफ़ से जीतता है।
जब आरएजी फेल होता है (हितधारकों से ईमानदार रहें)
आरएजी सामान्य बुद्धिमत्ता की परत नहीं है। यह अनुमानित तरीकों से फेल होता है:
१. जवाब कॉर्पस में है ही नहीं
कोई रिट्रीवल ट्रिक गायब नीति नहीं गढ़ सकता। कवरेज मापें। अगर सपोर्ट उत्पाद एक्स पूछे और डॉक्स केवल वाई कवर करें, सही व्यवहार इनकार है, आत्मविश्वास भरा अनुमान नहीं।
२. सवाल को कई तथ्यों पर तर्क चाहिए
मल्टी-हॉप, समय तुलना, और "जो कुछ जानते हैं सब सारांश" सिंगल-शॉट आरएजी को खींचते हैं। मल्टी-स्टेप रिट्रीवल, संरचित डेटा, या मानव वर्कफ़्लो चाहिए।
३. सटीकता और अंकगणित
इनवॉइस कुल, खुराक गणना, एसएलए गणित टूल या डेटाबेस में हैं, "उम्मीद है सही पैराग्राफ" में नहीं। जहाँ नंबर मायने रखें, आरएजी के साथ कैलकुलेटर और एसक्यूएल जोड़ें।
४. टकराने वाले या पुराने स्रोत
इंडेक्स में नीति के दो वर्शन जवाब पलटते रहते हैं। वर्शन फ़िल्टर, सुपरसेशन नियम, और ताज़गी मेटाडेटा प्रोडक्ट फ़ीचर हैं, वैकल्पिक सजावट नहीं।
५. एक्सेस कंट्रोल की गलतियाँ
उपयोगकर्ता को न दिखने वाला डॉक रिट्रीव करना सुरक्षा बग है। एसीएल रिट्रीवल समय पर लागू करें। एलएलएम पर भरोसा न करें कि वह प्रॉम्प्ट में पड़े प्रतिबंधित टेक्स्ट का "ज़िक्र नहीं करेगा"।
६. मूल्यांकन का दिखावा
चुने हुए सवालों पर लीडरबोर्ड डेमो प्रोडक्शन दर्द छिपाते हैं। असली क्वेरी सैंपल पर recall@k न दिखा सकें तो आप नहीं जानते सिस्टम काम करता है या नहीं।
७. जब फ़ाइन-ट्यूनिंग या सादा सर्च बेहतर हो
- स्थिर शैली/टोन काम: फ़ाइन-ट्यूनिंग या अच्छा प्रॉम्प्टिंग रिट्रीवल से जीत सकता है।
- ज्ञात आइटम लुकअप ("टिकट #१८४२ खोलो"): कीवर्ड और संरचित सर्च जीतते हैं।
- बहुत गतिशील व्यक्तिगत डेटा: सिस्टम ऑफ़ रिकॉर्ड से क्वेरी करें; रोज़ वेक्टर में फ्रीज़ न करें जब तक ज़रूरत न हो।
अगर इस हफ़्ते शुरू कर रहे हैं तो छोटा बिल्ड क्रम
१. काम तय करें: सपोर्ट एफएक्यू, आंतरिक विकी क्यूए, कोड डॉक्स। कॉर्पस सीमित करें। २. ५० असली सवाल इकट्ठा करें और संबंधित डॉक्स लेबल करें। ३. सादा हाइब्रिड रिट्रीव + सरल प्रॉम्प्ट उद्धरण और इनकार के साथ शिप करें। ४. उस सेट पर recall@10 और faithfulness मापें। ५. रिट्रीवल रिकॉल ठीक होने के बाद ही रीरैंकिंग जोड़ें। ६. डॉक बदलाव पर इन्जेस्ट और री-इंडेक्स स्वचालित करें। ७. यूआई चमकाने से पहले इवल सीआई में डालें।
ज़्यादातर टीमें उल्टा करती हैं: पहले यूआई और एजेंट डेमो, आखिर में रिट्रीवल गुणवत्ता। उपयोगकर्ता वह क्रम तुरंत महसूस करते हैं।
समापन
व्यावहारिक आरएजी पाइपलाइन ज़्यादातर सूचना पुनर्प्राप्ति है, अंत में एक एलएलएम के साथ। चंक इस तरह काटें कि इकाइयाँ पूछने के तरीके से मेल खाएँ। पिन किए मॉडल से एम्बेड करें। हाइब्रिड रिट्रीव करें। शॉर्टलिस्ट रीरैंक करें। सख्त ग्राउंडिंग नियमों से जनरेट करें। हर बदलाव का मूल्यांकन करें।
जब कॉर्पस अधूरा हो, सवाल मल्टी-हॉप हो, या काम शुद्ध गणना हो, साफ़ कहें और सही घटक बनाएँ। आरएजी अपनी लेन में शक्तिशाली है। उस लेन के बाहर यह धाराप्रवाह गलत होने का तरीका बन जाता है।