संक्षेप (टीएल;डीआर)
- समस्या: लाखों स्वतंत्र वेबसाइटों से हर महीने एक अरब पेज डाउनलोड करना, किसी पर भार डाले बिना, एक ही चीज दो बार लाए बिना, अनंत यूआरएल जालों में फंसे बिना, और बदलने वाले पेजों पर दोबारा जाते हुए।
- डिजाइन: फ्रंटियर, डाउनलोड, स्टोर, पार्स, छानना, दोहराव हटाना और फिर फ्रंटियर का एक चक्र। फ्रंटियर में आगे प्राथमिकता कतारें और पीछे हर होस्ट की एक कतार होती है, जिन्हें "अगला अनुमत डाउनलोड समय" वाला एक हीप नियंत्रित करता है, इसलिए शिष्टता बनावट से ही लागू होती है। देखे गए यूआरएल की जांच कुंजी-मान स्टोर पर टिके ब्लूम फिल्टर से होती है; लगभग दोहराई गई सामग्री सिमहैश से पकड़ी जाती है।
- नतीजा: एक मामूली बेड़े पर लगातार लगभग ४०० पेज प्रति सेकंड, हर होस्ट से कुछ सेकंड में ज्यादा से ज्यादा एक बार संपर्क, और क्रॉल की मेहनत उन पेजों पर जो नए, अहम या बदलने वाले हैं।
क्रॉलर इस श्रृंखला का सबसे सरल प्रोग्राम लगता है: पेज लाओ, उसके लिंक ढूंढो, उन्हें लाओ। यह चक्र लिखने में दस मिनट लगते हैं। असली वेब पर इसे एक हफ्ता चलाना बाकी सब सिखा देता है: ऐसे सर्वर जो बदतमीजी पर धीमे पड़ जाते हैं, "अगले महीने" के अंतहीन लिंक वाले कैलेंडर, दस लाख पेज जो अलग सत्र आईडी के साथ एक ही पेज हैं, और साइट मालिक जो आपको ईमेल करते हैं।
यह लेख उस तरह का सामान्य क्रॉलर डिजाइन करता है जो किसी सर्च इंडेक्स या कॉमन क्रॉल जैसे बड़े शोध संग्रह को भरता है।
जरूरतें और संख्याएं
कार्यात्मक: शुरुआती यूआरएल से शुरू करना, एचटीएमएल पेज खोजना और डाउनलोड करना, कच्ची सामग्री रखना, लिंक निकालना, रोबोट्स.टीएक्सटी मानना, समय के साथ पेजों पर लौटना।
गैर-कार्यात्मक: शिष्टता (किसी साइट पर कभी अतिभार नहीं), टूटे एचटीएमएल और शत्रुतापूर्ण यूआरएल स्थानों के खिलाफ मजबूती, अरबों पेज तक बढ़ना, नए सामग्री प्रकारों के लिए बढ़ाया जा सकना।
| मान्यता | मान | नतीजा |
|---|---|---|
| हर महीने पेज | एक अरब | औसतन लगभग ३८५ पेज प्रति सेकंड |
| औसत एचटीएमएल पेज | लगभग १०० केबी | हर महीने लगभग १०० टीबी कच्चा, दबाने पर कुछ दसियों टीबी |
| औसत डाउनलोड समय | लगभग ५०० मिलीसेकंड | लगभग २०० एक साथ डाउनलोड रफ्तार बनाए रखते हैं; गुंजाइश के लिए हजारों की योजना |
| हर पेज के लिंक | लगभग ५० | दोहराव हटाने से पहले हर सेकंड लगभग २०,००० नए उम्मीदवार यूआरएल |
| एक साल में देखे गए यूआरएल | दसियों अरब | देखे गए यूआरएल का समुच्चय सीधे एक मशीन की मेमोरी में नहीं समाता |
दिलचस्प संख्याएं बैंडविड्थ नहीं हैं। वे हैं हर सेकंड के २०,००० उम्मीदवार यूआरएल जिन्हें "क्या मैंने इसे देखा है?" का जवाब चाहिए, और लाखों होस्ट जिनमें से हर एक को अपनी दर सीमा चाहिए।
पाइपलाइन
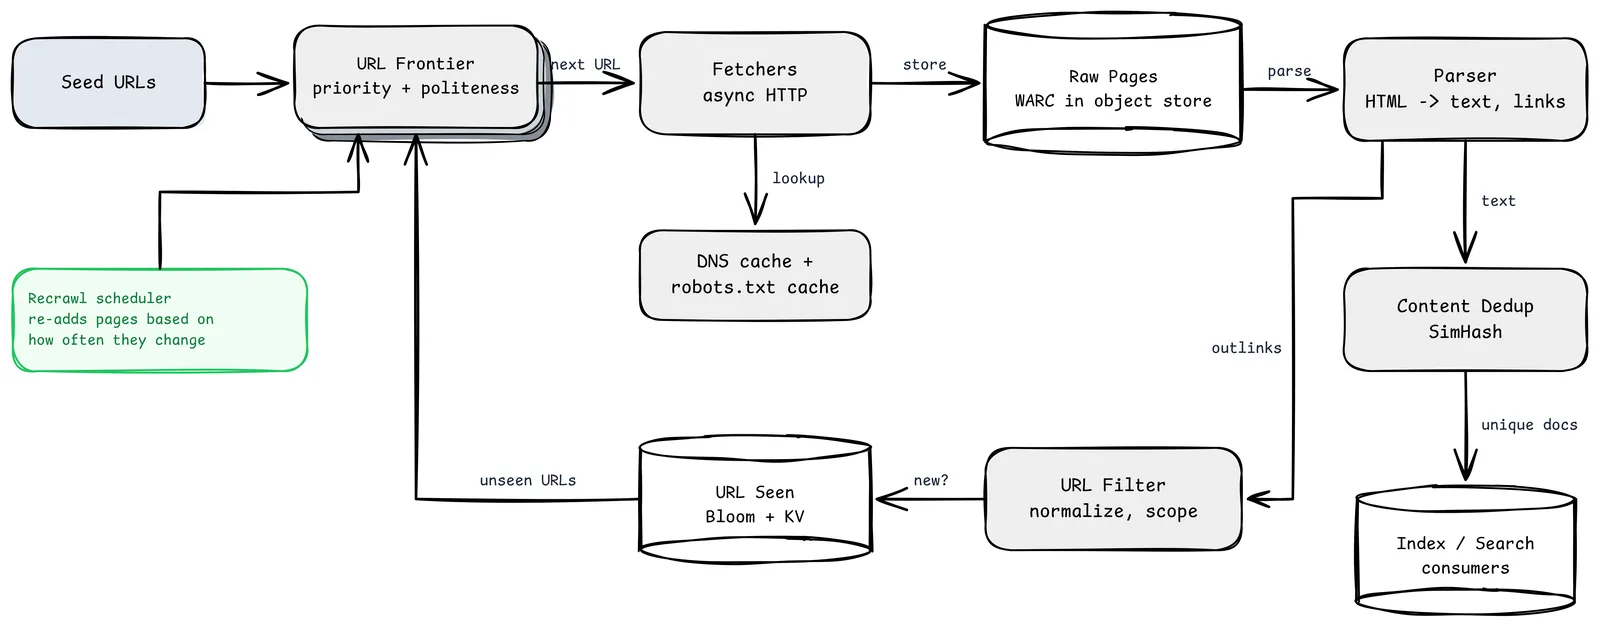
- शुरुआती यूआरएल। जानी-मानी, अच्छी गुणवत्ता वाली साइटों का शुरुआती समूह। उनकी गुणवत्ता पूरे क्रॉल की शक्ल तय करती है।
- यूआरएल फ्रंटियर। काम की सूची। यह तय करता है कि आगे क्या लाना है (प्राथमिकता) और हर होस्ट से कब संपर्क किया जा सकता है (शिष्टता)। यह डिजाइन का दिल है, और नीचे इसका अलग चित्र है।
- डाउनलोडर (असिंक्रोनस एचटीटीपी)। बिना रुकने वाले आईओ से गिनी-चुनी मशीनों पर हजारों एक साथ कनेक्शन। हर अनुरोध पर समय सीमा, आकार सीमा और रीडायरेक्ट सीमा। साफ यूजर एजेंट और संपर्क यूआरएल के साथ अपनी पहचान दें।
- डीएनएस कैश और रोबोट्स.टीएक्सटी कैश। सैकड़ों डाउनलोड प्रति सेकंड पर डीएनएस खोज आसानी से अड़चन बन सकती है, इसलिए उसे जमकर कैश करें। हर होस्ट का
robots.txtएक बार लाएं, लगभग एक दिन कैश रखें, और डाउनलोड से पहले हर यूआरएल उससे जांचें। आरएफसी ९३०९ (२०२२) ने आखिरकार रोबोट बहिष्कार प्रोटोकॉल को मानक बनाया। - कच्चे पेज (ऑब्जेक्ट स्टोर में वार्क)। जो डाउनलोड किया, हेडर समेत ठीक वही वार्क फाइलों में रखें (वह संग्रह प्रारूप जो कॉमन क्रॉल और इंटरनेट आर्काइव इस्तेमाल करते हैं)। पार्स बाद में दोबारा हो सकता है; डाउनलोड नहीं।
- पार्सर। एचटीएमएल को टेक्स्ट और लिंक में बदलता है, सापेक्ष यूआरएल हल करता है, और टूटे मार्कअप में भी टिका रहता है।
- सामग्री का दोहराव हटाना (सिमहैश)। कई यूआरएल एक जैसी या लगभग एक जैसी सामग्री देते हैं (मिरर, छपाई वाले रूप, ट्रैकिंग पैरामीटर)। ६४ बिट का सिमहैश फिंगरप्रिंट हैमिंग दूरी मिलाकर लगभग दोहराव पकड़ने देता है; गूगल ने २००७ के अपने क्रॉलर शोध पत्र में ठीक यही बताया।
- यूआरएल फिल्टर। यूआरएल को मानक रूप देता है (होस्ट छोटे अक्षरों में, डिफॉल्ट पोर्ट और फ्रैगमेंट हटाना, ट्रैकिंग पैरामीटर क्रमबद्ध या हटाना), दायरे के नियम लगाता है और जाने-माने जाल रोकता है।
- देखे गए यूआरएल (ब्लूम और कुंजी-मान)। ब्लूम फिल्टर मेमोरी में बताता है "पक्का नहीं देखा"; "शायद" वाले मामलों की पुष्टि मानक यूआरएल के हैश वाली कुंजी से एक स्थायी कुंजी-मान स्टोर में होती है।
- इंडेक्स / सर्च उपभोक्ता। अनोखे दस्तावेज क्रॉल का इस्तेमाल करने वाले तक जाते हैं।
- दोबारा क्रॉल योजनाकार। जाने-पहचाने यूआरएल को इस हिसाब से फ्रंटियर में लौटाता है कि वे कितनी बार बदलते हैं।
फ्रंटियर: आगे प्राथमिकता, पीछे शिष्टता
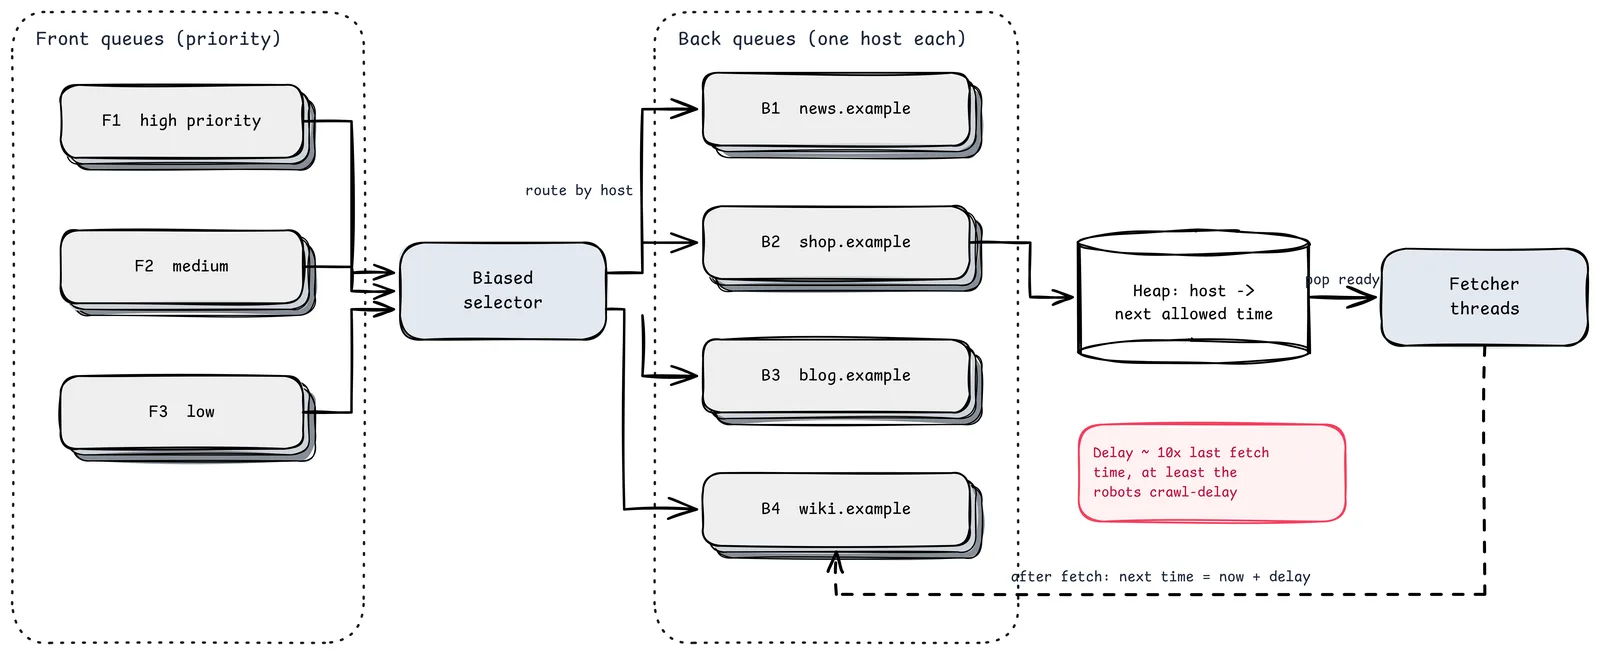
यह दो चरणों वाला डिजाइन मर्केटर क्रॉलर (हेडन और नाजोर्क, १९९९) से आया है और आज भी मानक जवाब है:
१. आगे की कतारें यूआरएल को प्राथमिकता के हिसाब से रखती हैं। प्राथमिकता पेजरैंक जैसे महत्व, ताजगी की जरूरत या बस डोमेन की गुणवत्ता से आ सकती है।
२. एक झुका हुआ चयनकर्ता आगे की कतारों से उठाता है, ऊंची प्राथमिकता को तरजीह देते हुए पर नीची को पूरी तरह भूखा रखे बिना।
३. यूआरएल पीछे की कतारों में भेजे जाते हैं, हर कतार में ठीक एक होस्ट। news.example के सारे यूआरएल एक ही लाइन में इंतजार करते हैं।
४. एक हीप हर पीछे की कतार की एक प्रविष्टि रखता है: वह सबसे जल्दी समय जब उस होस्ट से फिर संपर्क हो सकता है।
५. डाउनलोड धागे उस होस्ट को निकालते हैं जिसका समय आ गया है, उसकी कतार से एक यूआरएल लाते हैं, फिर उसे नए समय के साथ वापस रखते हैं: अभी और एक देरी, आमतौर पर पिछले डाउनलोड में लगे समय का कोई गुणक (मान लीजिए १० गुना), और साइट जितनी क्रॉल देरी मांगे उससे कभी कम नहीं।
लाल नोट एक पंक्ति में पूरी शिष्टता नीति है। धीमे सर्वर को अपने आप ज्यादा सांस मिलती है, क्योंकि उसके डाउनलोड में ज्यादा समय लगता है और इसलिए उसकी देरी बढ़ती है।
यह ढांचा समझ आ जाए तो फ्रंटियर को कई मशीनों में बांटना सीधा है: होस्ट से बांटें (होस्ट नाम का हैश), ताकि हर होस्ट की पीछे की कतार और शिष्टता स्थिति ठीक एक मशीन पर रहे।
जाल और दूसरे शत्रुतापूर्ण इलाके
| जाल | उदाहरण | बचाव |
|---|---|---|
| अनंत यूआरएल स्थान | "अगले महीने" के अंतहीन लिंक वाला कैलेंडर | अधिकतम यूआरएल गहराई और लंबाई; हर होस्ट का पेज बजट |
| सत्र आईडी और ट्रैकिंग पैरामीटर | ?sid=abc123 हर यूआरएल को अनोखा बनाता है |
मानकीकरण के नियम; हर होस्ट के पैरामीटर सीखना |
| नकली ४०४ | "नहीं मिला" पेज स्थिति २०० के साथ | सामग्री का दोहराव हटाना दोहराया गया ढांचा पकड़ता है |
| बहुत बड़े या बाइनरी जवाब | एचटीएमएल जैसे दिखते यूआरएल पर २ जीबी की फाइल | सामग्री प्रकार की जांच, आकार सीमा, जल्दी रुकने वाली धारा |
| टपकते हुए धीमे सर्वर | हर सेकंड एक बाइट देने वाले जवाब | सिर्फ कनेक्शन नहीं, कुल समय की सीमा |
| स्पैम और लिंक फार्म | अपने आप बने लाखों पेज | प्राथमिकता में गुणवत्ता संकेत; हर डोमेन का बजट |
हर होस्ट का पेज बजट अकेला सबसे असरदार बचाव है। कोई साइट अपने हिस्से से ज्यादा नहीं पाती, चाहे कितने भी लिंक बनाए।
दोबारा क्रॉल: ताजगी एक बजट है
पेज बहुत अलग दरों पर बदलते हैं। समाचार साइट का मुखपृष्ठ हर कुछ मिनट में बदलता है; संग्रह में रखा शोध पत्र कभी नहीं। सब कुछ तय चक्र पर लाना ज्यादातर बजट बर्बाद करता है।
- हर यूआरएल के बदलाव का इतिहास रखें (पिछली बार से सिमहैश बदला?)।
- बदलाव दर का अनुमान लगाकर अगली यात्रा उसी अनुपात में तय करें, एक न्यूनतम और अधिकतम अंतराल के भीतर।
- शर्त वाले अनुरोध (
If-Modified-Since,If-None-Match) इस्तेमाल करें ताकि न बदला पेज पूरे डाउनलोड के बजाय एक304का खर्च करे। - अहम पेजों को छोटे अंतराल दें; लंबी पूंछ को पुराना होने दें।
- जहां साइटें साइटमैप दें, उनका इस्तेमाल करें, क्योंकि उनमें अक्सर आखिरी बदलाव की तारीख होती है।
अच्छा नागरिक बनना
robots.txtमानें, अपने यूजर एजेंट के लिए रोक के नियम और कोई भी क्रॉल देरी समेत।- यूजर एजेंट में क्रॉलर की पहचान दें, एक यूआरएल के साथ जो बताए कि यह क्या है और इससे बाहर कैसे निकलें।
- वे आईपी सीमाएं प्रकाशित करें जिनसे आप क्रॉल करते हैं, ताकि साइट संचालक आपकी पुष्टि कर सकें।
429और503पर पीछे हटें, औरRetry-Afterमानें।- संपर्क पता दें और उसे सच में पढ़ें।
क्रॉलरों के लिए वेब की सहनशीलता एक साझी संपदा है। हर बदतमीज क्रॉलर साइट संचालकों को सभी को और कड़ाई से रोकने पर मजबूर करता है।
उत्पादन जांच सूची
- फ्रंटियर अगले अनुमत समय वाले हीप के साथ हर पीछे की कतार में एक होस्ट लागू करता है
- हर यूआरएल से पहले रोबोट्स.टीएक्सटी लाया, कैश किया और जांचा; आरएफसी ९३०९ के अर्थ
- डीएनएस कैश; कनेक्शन, पहले बाइट और कुल समय पर हर अनुरोध की सीमा
- यूआरएल मानकीकरण और दायरे के नियम संस्करण वाले और परखे हुए
- ब्लूम फिल्टर और स्थायी स्टोर से देखे गए यूआरएल की जांच
- सिमहैश या ऐसे तरीके से लगभग दोहराव की पहचान
- हर होस्ट और हर डोमेन का पेज बजट; गहराई और यूआरएल लंबाई की सीमा
- पार्स से पहले कच्चे जवाब वार्क के रूप में सहेजे
- देखी गई बदलाव दर से दोबारा क्रॉल की योजना; शर्त वाले अनुरोध
- डैशबोर्ड: पेज प्रति सेकंड, वर्ग के हिसाब से त्रुटि दर, रुके हुए होस्ट, फ्रंटियर का आकार, दोहराव दर
जो बचा रह गया
क्रॉलर एक साथ लाखों घरों में मेहमान है। इंजीनियरिंग रफ्तार के बारे में है, लेकिन साख तमीज के बारे में: दरवाजा खटखटाओ, इंतजार करो, बहुत जल्दी-जल्दी मत लौटो, कहा जाए तो चले जाओ।
कहीं किसी सस्ते सर्वर पर एक छोटा ब्लॉग है जहां आपका क्रॉलर हर कुछ दिन में जाता है। उसे कभी आपका नाम पता नहीं चलेगा। उसे यह भी कभी महसूस नहीं होना चाहिए कि आप वहां थे।
स्रोत
- हेडन और नाजोर्क, मर्केटर: एक बढ़ने लायक, विस्तार योग्य वेब क्रॉलर (१९९९)
- मांकु, जैन और दास सरमा, वेब क्रॉलिंग के लिए लगभग दोहराव की पहचान (डब्ल्यूडब्ल्यूडब्ल्यू २००७)
- आरएफसी ९३०९: रोबोट बहिष्कार प्रोटोकॉल
- कॉमन क्रॉल: परिचय और वार्क डेटा
- आईएसओ २८५००: वार्क फाइल प्रारूप (लाइब्रेरी ऑफ कांग्रेस का विवरण)
- इसी श्रृंखला में: सर्च ऑटोकंप्लीट डिजाइन करें, मोटा अनुमान लगाना, डीएनएस कैसे काम करता है