संक्षेप (टीएल;डीआर)
- समस्या: एक डेटाबेस का ऑटो-इंक्रीमेंट अद्वितीय और क्रमबद्ध होता है, लेकिन हर लेखन रास्ते पर एक ही मशीन बिठा देता है। जैसे ही आप डेटा बांटते हैं, या डेटाबेस में डालने से पहले आईडी बनाते हैं, आपको ऐसी आईडी चाहिए जो किसी से पूछे बिना कई मशीनों में अद्वितीय हों।
- डिजाइन: ज्यादातर सिस्टमों के लिए ६४ बिट की स्नोफ्लेक शैली की आईडी: अपने चुने युग से मिलीसेकंड के ४१ बिट, समन्वय सेवा से किराए पर ली गई वर्कर आईडी के १० बिट, और प्रति मिलीसेकंड क्रम के १२ बिट। जहां १२८ बिट चल सकते हैं, वहां यूयूआईडी वी७ बिना किसी वर्कर समन्वय के वही समय क्रम देता है।
- नतीजा: हर जनरेटर पर प्रति मिलीसेकंड ४,०९६ तक आईडी, लगभग ६९ साल की सीमा, समय से लगभग क्रमबद्ध आईडी जो बी-ट्री में डालना सस्ता रखती हैं, और इकलौती असली विफलता के लिए साफ नीति: घड़ी का पीछे जाना।
आईडी तब तक पाइपलाइन जैसी लगती हैं जब तक वे गलत न हो जाएं। दोहराई गई आईडी चुपचाप डेटा खराब करती हैं। बेतरतीब आईडी सूचकांक फुलाती हैं। क्रमिक आईडी आपके कारोबार की मात्रा हर उस व्यक्ति को बता देती हैं जो एक हफ्ते के अंतर पर दो बार साइन अप करे। और एक डेटाबेस पर टिकी आईडी उस डेटाबेस को पूरी कंपनी की क्षमता की छत बना देती हैं।
यह लेख विकल्पों को उसी क्रम में देखता है जिसमें ज्यादातर कंपनियां उन्हें खोजती हैं, फिर वह डिजाइन बनाता है जिस पर ज्यादातर आखिर में पहुंचती हैं।
जरूरतें
१. हर जनरेटर में हमेशा के लिए अद्वितीय। कोई अपवाद नहीं, दोबारा शुरू होने और घड़ी की गड़बड़ी के बाद भी। २. बनने के समय से लगभग क्रमबद्ध, ताकि "सबसे नया पहले" वाली खोज और समय के हिसाब से बंटा स्टोरेज बिना अलग समय सूचकांक के काम करे। ३. हो सके तो ६४ बिट में समाए, क्योंकि ६४ बिट के पूर्णांक रखने, सूचीबद्ध करने, तुलना करने और हर भाषा तथा डेटाबेस में भेजने में सस्ते हैं। ४. गर्म रास्ते पर कोई समन्वय नहीं। आईडी बनाने के लिए नेटवर्क कॉल नहीं होनी चाहिए। ५. ऊंची क्षमता: हर सेवा पर प्रति सेकंड दसियों हजार आईडी, झटकों के साथ।
हर सिस्टम को पांचों नहीं चाहिए। नीचे की तुलना बताती है कि हर विकल्प में आप क्या छोड़ते हैं।
विकल्प
| तरीका | आकार | क्रमबद्ध | समन्वय | कमजोरी |
|---|---|---|---|---|
| डेटाबेस ऑटो-इंक्रीमेंट | ६४ बिट | हां | हर डालना एक डेटाबेस से गुजरता है | लेखन की इकलौती अड़चन; बंटवारे में टूटता है; मात्रा उजागर करता है |
| बहु-मास्टर ऑटो-इंक्रीमेंट (कदम = एन) | ६४ बिट | सिर्फ हर सर्वर में | तय सर्वर संख्या | सर्वर जोड़ने पर पूरी योजना दोबारा गिननी पड़ती है |
| यूयूआईडी वी४ | १२८ बिट | नहीं | कोई नहीं | बेतरतीब डालना बी-ट्री सूचकांक तोड़ता है; बड़ी कुंजियां |
| यूयूआईडी वी७ (आरएफसी ९५६२) | १२८ बिट | हां (मिलीसेकंड) | कोई नहीं | १२८ बिट; पूर्णांक कुंजी से अब भी बड़ा |
| टिकट सर्वर (फ्लिकर) | ६४ बिट | हां | हर आईडी या हर बैच पर नेटवर्क कॉल | टिकट सर्वर अहम बुनियादी ढांचा बन जाते हैं |
| स्नोफ्लेक (ट्विटर) | ६४ बिट | हां (मिलीसेकंड) | सिर्फ शुरू होते समय वर्कर आईडी तय करना | घड़ियों के ठीक बर्ताव पर निर्भर |
यूयूआईडी वी४ में १२२ बेतरतीब बिट होते हैं। टकराव व्यावहारिक चिंता नहीं है। सूचकांक की निकटता है: हर डालना प्राथमिक कुंजी के बी-ट्री के किसी बेतरतीब पेज पर गिरता है, जिससे पेज टूटते हैं और सूचकांक का कहीं ज्यादा हिस्सा मेमोरी में गर्म रखना पड़ता है। बड़ी तालिकाओं पर यह लेखन क्षमता और कैश दक्षता पर मापने लायक बोझ है।
यूयूआईडी वी७, जिसे २०२४ में आरएफसी ९५६२ में मानक बनाया गया, ऊंचे बिटों में ४८ बिट का यूनिक्स मिलीसेकंड समय और उसके बाद बेतरतीब बिट रखता है। आपको बिना किसी समन्वय के समय क्रम और अच्छी सूचकांक निकटता मिलती है। अगर आपके डेटाबेस में अपना यूयूआईडी प्रकार है और १६ बाइट की कुंजियां चल सकती हैं, तो २०२५ में यूयूआईडी वी७ सबसे सरल अच्छा जवाब है।
टिकट सर्वर वह है जो फ्लिकर ने २०१० में बताया: एक छोटी माईएसक्यूएल तालिका जहां REPLACE INTO Tickets64 (stub) VALUES ('a'); SELECT LAST_INSERT_ID(); अगली संख्या देता है। auto_increment_increment = 2 और एक तथा दो के अंतर वाले दो सर्वर अतिरिक्त सुरक्षा देते हैं (विषम और सम आईडी)। यह अच्छा चलता है और समझना आसान है, लेकिन बैच न दें तो हर आईडी के लिए एक चक्कर लगता है।
स्नोफ्लेक, जिसे ट्विटर ने २०१० में खुला स्रोत बनाया, एक साथ क्रम, ६४ बिट और प्रति आईडी बिना समन्वय, तीनों देता है। इसीलिए इसके रूप डिस्कॉर्ड में, इंस्टाग्राम की बंटी आईडी योजना में और सोनी के सोनीफ्लेक में दिखते हैं।
स्नोफ्लेक का ढांचा
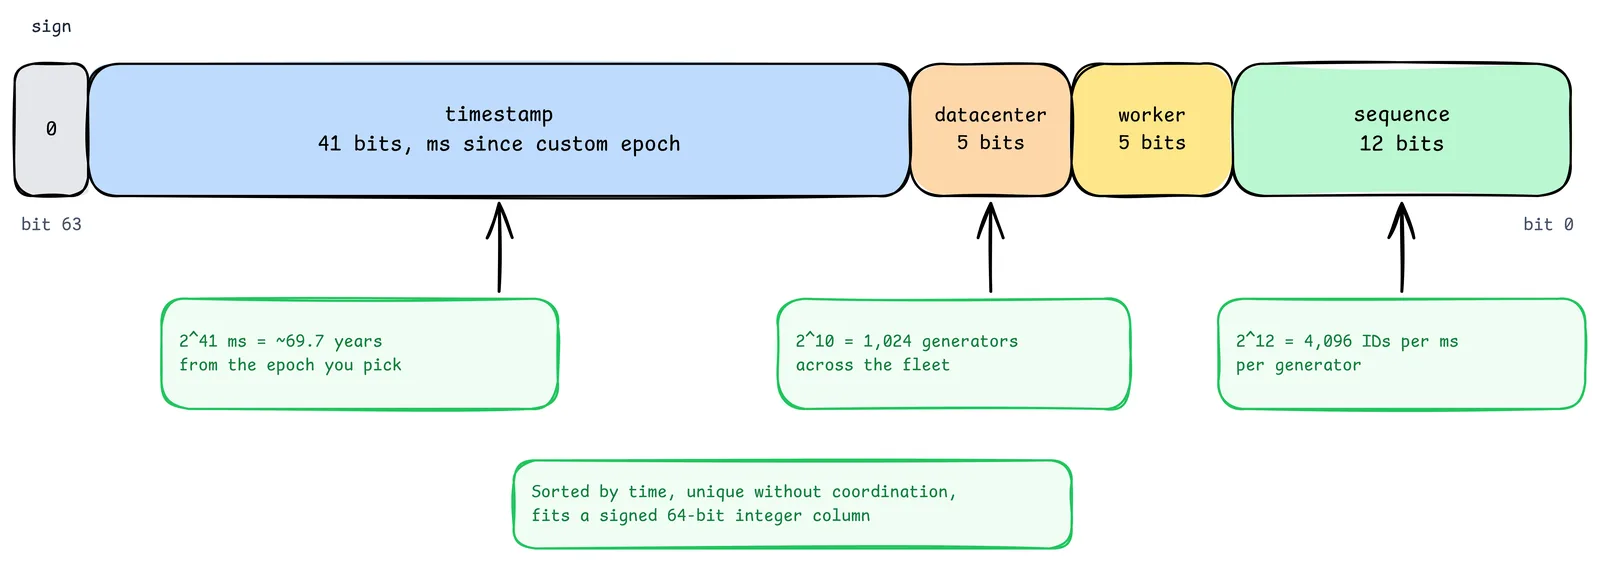
- चिह्न बिट (शून्य)। शून्य रखा जाता है ताकि उन भाषाओं और डेटाबेस में भी आईडी धनात्मक ६४ बिट पूर्णांक रहे जिनमें बिना चिह्न वाला प्रकार नहीं होता।
- समय, ४१ बिट। आपके चुने युग से मिलीसेकंड। २^४१ मिलीसेकंड लगभग ६९.७ साल हैं। ट्विटर का युग नवंबर २०१० में है; डिस्कॉर्ड का २०१५ का पहला मिलीसेकंड। हाल का युग चुनें ताकि सीमा बर्बाद न हो।
- डेटा सेंटर और वर्कर, १० बिट। जनरेटर की पहचान। इसे ५ और ५ में बांटना परंपरा है, जरूरत नहीं। अहम यह है कि दो जीवित जनरेटर कभी एक ही मान साझा न करें।
- क्रम, १२ बिट। हर मिलीसेकंड शून्य से शुरू होने वाला काउंटर। हर जनरेटर पर प्रति मिलीसेकंड ४,०९६ आईडी यानी लगभग ४० लाख प्रति सेकंड।
क्योंकि समय ऊंचे बिटों में है, आईडी को संख्या की तरह क्रमबद्ध करने पर वे बनने के समय से क्रमबद्ध हो जाती हैं (मिलीसेकंड तक, और अलग जनरेटरों के बीच सिर्फ उतनी सटीकता से जितनी उनकी घड़ियां मेल खाती हैं)।
इंस्टाग्राम का २०१२ का रूप ढांचे को ४१ बिट समय, १३ बिट तार्किक हिस्से की आईडी और १० बिट क्रम में बदलता है, और यह पोस्टग्रेस के भीतर ही बनता है। सिद्धांत वही है: पहले समय, फिर "कौन", फिर "इस मिलीसेकंड में कितनी।"
एक चलता हुआ जनरेटर
यह एक पूरा, धागों के लिए सुरक्षित जनरेटर है। इसमें ५ और ५ के बंटवारे के बजाय सपाट १० बिट की वर्कर आईडी है, और यह उन दो किनारे वाले मामलों को संभालता है जो मायने रखते हैं: एक मिलीसेकंड में क्रम खत्म हो जाना, और घड़ी का पीछे जाना।
import threading
import time

EPOCH_MS = 1_704_067_200_000          # 2024-01-01T00:00:00Z, your own epoch
WORKER_BITS, SEQ_BITS = 10, 12
MAX_WORKER, MAX_SEQ = (1 << WORKER_BITS) - 1, (1 << SEQ_BITS) - 1
MAX_BACKWARD_MS = 5

class Snowflake:
    def __init__(self, worker_id: int):
        if not 0 <= worker_id <= MAX_WORKER:
            raise ValueError("worker_id out of range")
        self.worker_id, self.last_ms, self.seq = worker_id, -1, 0
        self.lock = threading.Lock()

    def next_id(self) -> int:
        with self.lock:
            now = time.time_ns() // 1_000_000
            if now < self.last_ms:                      # clock moved backward
                if self.last_ms - now > MAX_BACKWARD_MS:
                    raise RuntimeError("clock moved backward, refusing to mint IDs")
                now = self._wait_until(self.last_ms)
            if now == self.last_ms:
                self.seq = (self.seq + 1) & MAX_SEQ
                if self.seq == 0:                       # 4,096 IDs used this ms
                    now = self._wait_until(self.last_ms + 1)
            else:
                self.seq = 0
            self.last_ms = now
            return ((now - EPOCH_MS) << (WORKER_BITS + SEQ_BITS)) | (self.worker_id << SEQ_BITS) | self.seq

    @staticmethod
    def _wait_until(target_ms: int) -> int:
        while (now := time.time_ns() // 1_000_000) < target_ms:
            time.sleep(0.0001)
        return now
मैंने इसे एक जनरेटर पर ३ लाख आईडी के लिए चलाया: सब अद्वितीय, सख्ती से बढ़ती हुई, और हर एक सही समय और वर्कर आईडी में वापस खुली। खोलना बस खिसकाना और छानना है: timestamp = (id >> 22) + EPOCH_MS, worker = (id >> 12) & 1023, sequence = id & 4095।
जनरेटर कहां रहता है
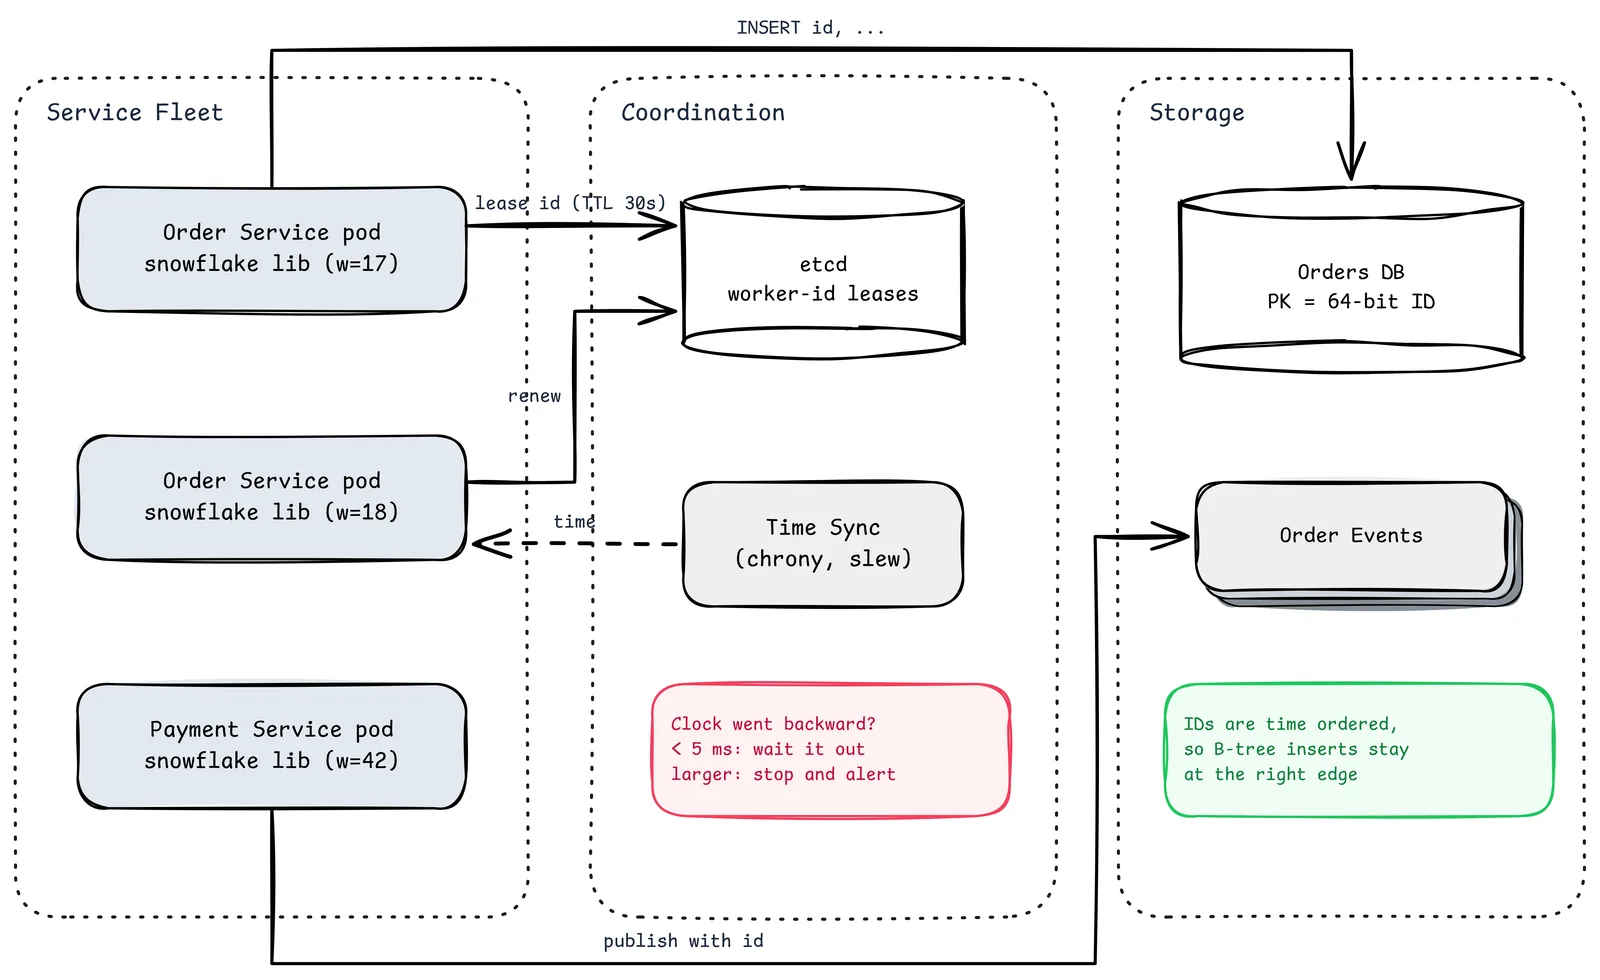
- लाइब्रेरी वाले सेवा पॉड। जनरेटर हर सेवा के भीतर एक लाइब्रेरी है, नेटवर्क सेवा नहीं। आईडी बनाना ताले के भीतर एक फलन कॉल है: न कोई चक्कर, न अनुरोध के रास्ते पर कोई निर्भरता।
- ईटीसीडी (वर्कर आईडी किराया)। शुरू होते समय हर पॉड टीटीएल (मान लीजिए ३० सेकंड) के साथ एक खाली वर्कर आईडी किराए पर लेता है और जीवित रहने तक उसे नवीनीकृत करता है। पॉड मर जाए तो किराया खत्म होता है और आईडी दोबारा इस्तेमाल हो सकती है, लेकिन टीटीएल के बाद ही, इसलिए दो जीवित पॉड कभी एक आईडी साझा नहीं करते। जूकीपर के अस्थायी नोड या किराए वाली डेटाबेस तालिका भी ऐसे ही काम करती है। तय बेड़े में स्थिर कॉन्फिग भी चलता है, लेकिन ऑटोस्केलिंग ठीक उसी को तोड़ती है।
- समय मिलान (क्रोनी, धीमा सुधार)। घड़ी का अनुशासन ही जनरेटर की असली निर्भरता है। एनटीपी या क्रोनी को इस तरह सेट करें कि वह घड़ी को धीरे-धीरे तेज या धीमा करके सुधारे, कूदाकर नहीं, ताकि सुधार कभी समय को पीछे न ले जाए।
- ऑर्डर डेटाबेस। प्राथमिक कुंजी ६४ बिट की आईडी है। क्योंकि आईडी समय से क्रमबद्ध हैं, नई पंक्तियां बी-ट्री के दाएं किनारे पर पहुंचती हैं, जो हर रिलेशनल इंजन के लिए सस्ता मामला है।
- ऑर्डर घटनाएं। वही आईडी घटनाओं, लॉग और ट्रेस में जाती है, जिससे किसी पंक्ति को उसके आसपास हुई हर चीज से जोड़ना आसान हो जाता है।
लाल नोट इकलौती डरावनी विफलता की नीति है, जिसकी बात आगे है।
असली समस्या घड़ियां हैं
स्नोफ्लेक की अद्वितीयता एक मान्यता पर टिकी है: कोई जनरेटर कभी (timestamp, sequence) की जोड़ी दोबारा इस्तेमाल नहीं करता। पीछे कूदने वाली घड़ी यह मान्यता तोड़ देती है।
घड़ियां पीछे क्यों कूदती हैं: लंबे भटकाव के बाद एनटीपी का झटके से सुधार, किसी वर्चुअल मशीन का अलग घड़ी वाले होस्ट पर जाना, हाथ से बदलाव, या लीप सेकंड का ऐसा क्रियान्वयन जो एक सेकंड दोहरा दे।
बचाव, पसंद के क्रम में:
१. बड़ी छलांग रोकें। क्रोनी या एनटीपीडी को धीमे सुधार के लिए सेट करके चलाएं। लीप सेकंड को फैलाने वाला समय इस्तेमाल करें (गूगल और एडब्ल्यूएस ऐसा समय देते हैं), ताकि कोई सेकंड कभी न दोहराया जाए। २. छोटी छलांग सोख लें। अगर घड़ी पिछले इस्तेमाल हुए समय से कुछ मिलीसेकंड पीछे है, तो उसके आगे आने तक रुकें, जैसा ऊपर का कोड करता है। ३. बड़ी छलांग ठुकराएं। अगर घड़ी बहुत पीछे है, तो आईडी बनाना बंद करें और चेतावनी दें। जोर से विफल होना चुपचाप दोहराव बनाने से कहीं बेहतर है। ४. दोबारा शुरू होने पर बचें। शुरू होते समय तब तक रुकें जब तक घड़ी पिछली प्रक्रिया के इस्तेमाल किए आखिरी समय से आगे न निकल जाए (या उसे सहेज लें), खासकर अगर दोबारा शुरू होना किसी दूसरे होस्ट पर हो सकता है।
यह भी याद रखें कि जनरेटरों के बीच समय क्रम उतना ही अच्छा है जितनी उनकी घड़ियां मेल खाती हैं। दो अलग मशीनों पर एक मिलीसेकंड के अंतर से बनी आईडी किसी भी क्रम में लग सकती हैं। "लगभग क्रमबद्ध" ही ईमानदार वादा है।
सुरक्षा और उत्पाद से जुड़ी बातें
- आईडी जानकारी उजागर करती हैं। स्नोफ्लेक आईडी बताती है कि कोई चीज कब बनी, और कभी-कभी किस डेटा सेंटर में। क्रमिक डेटाबेस आईडी मात्रा बताती हैं (एक हफ्ते के अंतर पर दो ऑर्डर बनाइए और घटाइए)। सार्वजनिक पहचानकर्ताओं के लिए अलग अपारदर्शी आईडी या अंदरूनी आईडी को कूटबद्ध करने पर विचार करें।
- आईडी को कभी गुप्त न मानें। अनुमान न लगा सकना अधिकृत होना नहीं है। आईडी से होने वाली हर खोज पर अनुमति की जांच लागू रहती है।
- जावास्क्रिप्ट की सटीकता। जावास्क्रिप्ट में संख्याएं डबल होती हैं, जो सिर्फ २^५३ तक सुरक्षित हैं। जेसन संख्या के रूप में भेजी गई ६४ बिट स्नोफ्लेक आईडी ब्राउजर में चुपचाप गोल हो जाएगी। जेसन में आईडी को स्ट्रिंग के रूप में भेजें। डिस्कॉर्ड का एपीआई ठीक यही करता है।
मैं कैसे चुनूंगा
| स्थिति | चुनाव |
|---|---|
| एक डेटाबेस, मध्यम लेखन दर, अंदरूनी आईडी | डेटाबेस ऑटो-इंक्रीमेंट ठीक है। जरूरत से ज्यादा इंजीनियरिंग न करें |
| डालने से पहले आईडी चाहिए, १६ बाइट रख सकते हैं, समन्वय के लिए संचालन बजट नहीं | यूयूआईडी वी७ |
| ६४ बिट पूर्णांक चाहिए, कई सेवाएं, ऊंची क्षमता | किराए की वर्कर आईडी के साथ स्नोफ्लेक |
| सख्ती से लगातार संख्याएं चाहिए (बिल संख्या, कानूनी क्रम) | टिकट सर्वर या डेटाबेस क्रम, अड़चन स्वीकार करते हुए |
उत्पादन जांच सूची
- हाल का युग चुना और दस्तावेज में लिखा; ६९ साल की सीमा दर्ज
- वर्कर आईडी समन्वय सेवा से टीटीएल के साथ किराए पर, ऑटोस्केल बेड़े में कभी हाथ से नहीं
- घड़ी मिलान धीमे सुधार पर; लीप सेकंड फैलाव चालू
- पीछे जाती घड़ी की नीति लागू: छोटे अंतर पर रुको, बड़े अंतर पर विफल होकर चेतावनी दो
- क्रम खत्म होने पर शून्य पर लौटने के बजाय अगले मिलीसेकंड का इंतजार
- जेसन एपीआई में आईडी स्ट्रिंग के रूप में
- सार्वजनिक आईडी की जानकारी रिसाव के लिए समीक्षा
- मेट्रिक्स: प्रति सेकंड बनी आईडी, क्रम खत्म होने पर इंतजार, घड़ी अंतर की त्रुटियां, किराया नवीनीकरण की विफलताएं
जो बचा रह गया
स्नोफ्लेक आईडी एक छोटी सी आत्मकथा है: कब पैदा हुई, कहां, और उस मिलीसेकंड में उसके कितने भाई-बहन थे।
यह एक चुपचाप लगाया गया दांव भी है कि उस मशीन की घड़ी आगे चलती रहेगी। ज्यादातर समय वह चलती है। पूरा डिजाइन उन गिने-चुने मौकों के बारे में है जब वह नहीं चलती, और यह पक्का करने के बारे में कि जनरेटर आपके डेटाबेस से पहले इसे पकड़ ले।
स्रोत
- ट्विटर इंजीनियरिंग: स्नोफ्लेक की घोषणा (२०१०)
- फ्लिकर: टिकट सर्वर, सस्ते में वितरित अद्वितीय प्राथमिक कुंजियां
- इंस्टाग्राम इंजीनियरिंग: इंस्टाग्राम पर बंटवारा और आईडी
- आरएफसी ९५६२: सार्वभौमिक रूप से अद्वितीय पहचानकर्ता (यूयूआईडी वी७)
- डिस्कॉर्ड डेवलपर दस्तावेज: स्नोफ्लेक
- गूगल सार्वजनिक एनटीपी: लीप सेकंड फैलाव
- इसी श्रृंखला में: यूआरएल शॉर्टनर डिजाइन करें, कुंजी-मान स्टोर डिजाइन करें