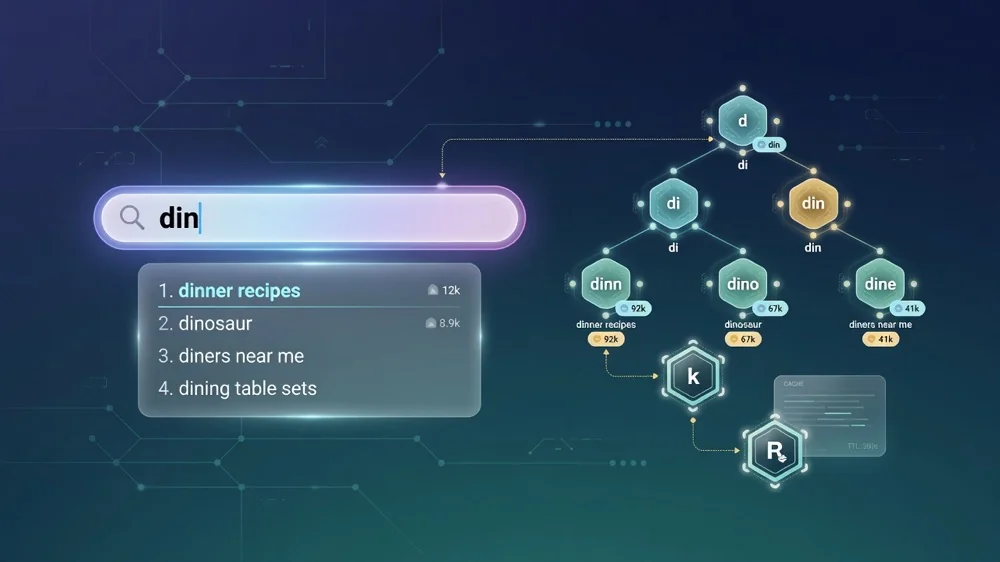
संक्षेप (टीएल;डीआर)
- समस्या: उपयोगकर्ता ने जो भी उपसर्ग लिखा है, उसके दस सबसे अच्छे पूरे रूप हर कीस्ट्रोक पर लौटाना, इतनी तेजी से कि सुझाव तुरंत लगें (शुरू से अंत तक १०० मिलीसेकंड से काफी कम), हर सेकंड दसियों हजार अनुरोधों के लिए, और कभी कुछ आपत्तिजनक सुझाए बिना।
- डिजाइन: सिस्टम को दो रास्तों में बांटें। क्वेरी रास्ता मेमोरी में एक शुद्ध खोज है, ऐसे ट्राई में जिसके हर नोड पर उसके टॉप-के पूरे रूप पहले से रखे हैं, और आगे सीडीएन तथा ग्राहक के कैश हैं। डेटा रास्ता सर्च लॉग को ऑफलाइन समय के साथ घटते भार के साथ जोड़ता है, छानता है, ट्राई की नई प्रतियां बनाता है और सर्वरों तक भेजता है।
- नतीजा: एक खोज
len(prefix)कदमों की एक यात्रा है और घंटों पहले गिनी गई सूची लौटाती है। सारा महंगा काम, रैंकिंग, छानना और दोहराव हटाना, ऑफलाइन होता है जहां वह धीमा और सावधान हो सकता है।
ऑटोकंप्लीट उन गिनी-चुनी सुविधाओं में से है जहां देरी ही उत्पाद है। अगर आपके "डिन" लिखने के ३०० मिलीसेकंड बाद सर्च बॉक्स "डिनर रेसिपी" सुझाए, तो वह टूटा हुआ लगता है, भले सुझाव अच्छे हों। डिजाइन इसी एक शर्त से निकलता है: उपयोगकर्ता के लिखते समय कुछ भी महंगा नहीं होना चाहिए।
जरूरतें और संख्याएं
कार्यात्मक: किसी उपसर्ग के लिए लोकप्रियता से क्रमबद्ध १० तक सुझाव लौटाना (वैकल्पिक रूप से व्यक्तिगत और स्थानीय); सर्च का व्यवहार बदलने पर सुझाव बदलना; रोकी गई सामग्री कभी न सुझाना।
गैर-कार्यात्मक: सर्वर पर पी९९ लगभग ५० मिलीसेकंड से कम ताकि पूरा अनुभव १०० मिलीसेकंड से कम रहे; अत्यधिक उपलब्ध (ऑटोकंप्लीट विफल हो तो सर्च फिर भी चले); नतीजे घंटों पुराने हो सकते हैं।
| मान्यता | मान | नतीजा |
|---|---|---|
| रोज सर्च करने वाले | १ करोड़ | |
| हर उपयोगकर्ता की रोज सर्च | १० | रोज १० करोड़ सर्च |
| डिबाउंस के बाद हर सर्च के अनुरोध | लगभग ६ | रोज लगभग ६० करोड़ अनुरोध, औसतन लगभग ७ हजार प्रति सेकंड, शिखर पर लगभग २० हजार |
| रखी गई अलग क्वेरी | लगभग १० करोड़ | एक-दो बार ही दिखी लंबी पूंछ हटाने के बाद |
| हर नोड पर सुझाव | १० | मेमोरी नोड गुणा के से बढ़ती है, इसीलिए के छोटा रहता है |
हर सर्च के अनुरोधों वाली संख्या वह जगह है जहां ग्राहक का डिजाइन मायने रखता है। डिबाउंस के बिना १५ अक्षरों की क्वेरी यानी १५ अनुरोध।
दो रास्ते
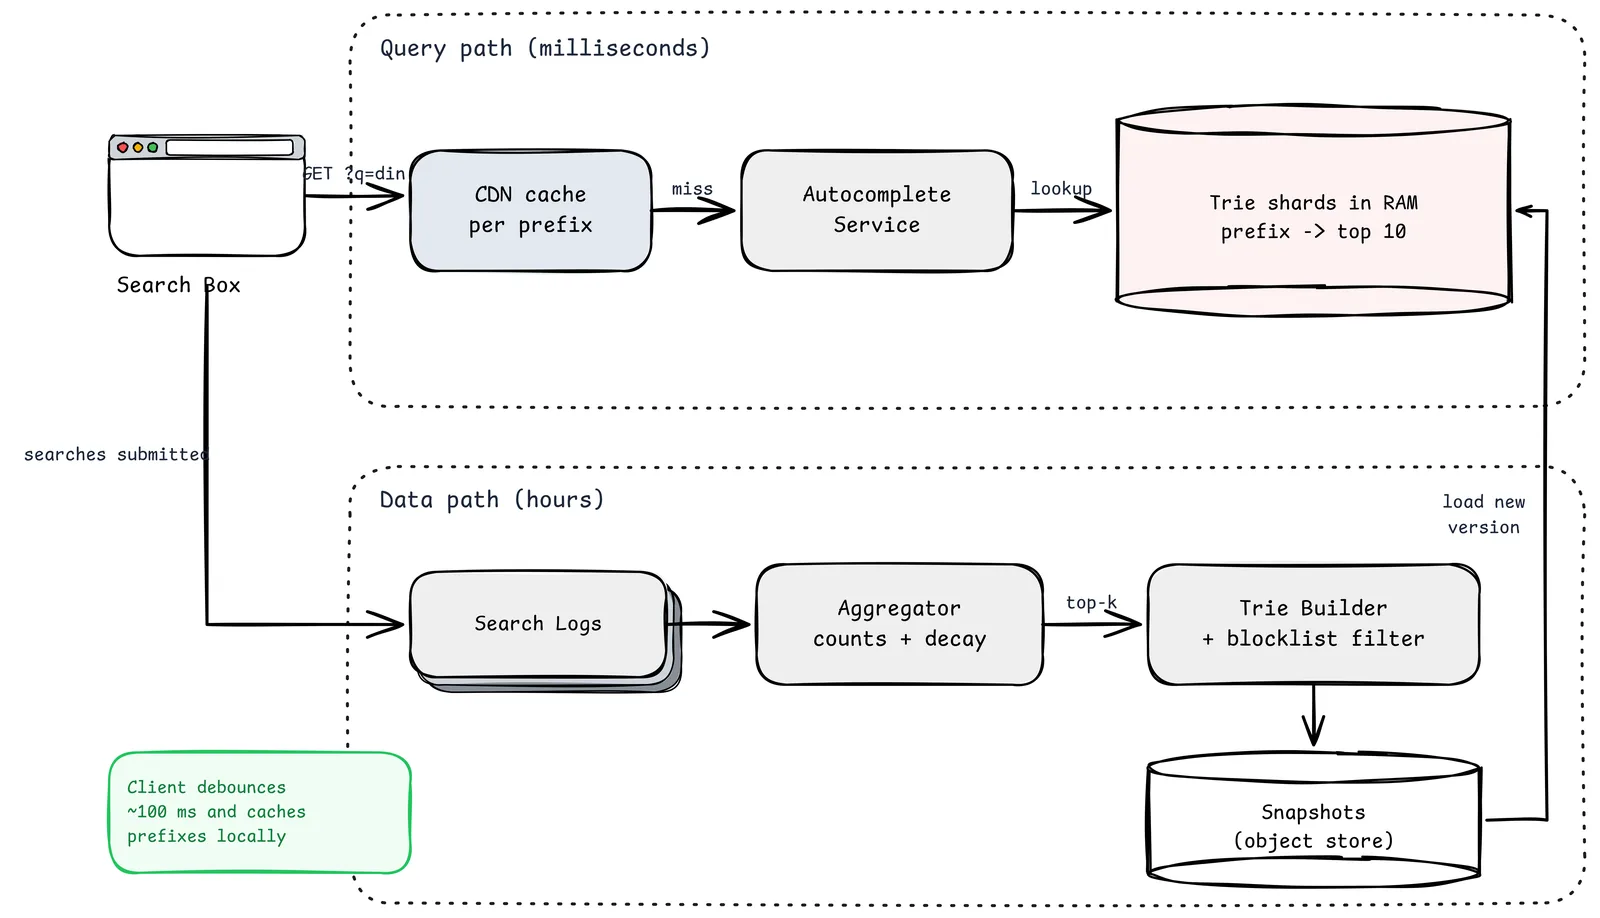
क्वेरी रास्ता (मिलीसेकंड)
- सर्च बॉक्स। कीस्ट्रोक पर डिबाउंस लगाता है (लगभग १०० मिलीसेकंड), हर उपसर्ग के जवाब स्थानीय रूप से कैश करता है, और नया उपसर्ग लिखे जाने पर चल रहे अनुरोध रद्द करता है।
- हर उपसर्ग का सीडीएन कैश। छोटे उपसर्ग (
a,th,how) करोड़ों उपयोगकर्ता मांगते हैं। किनारे पर कुछ मिनट के लिए जवाब कैश करना आपके सर्वरों तक पहुंचने से पहले ही ट्रैफिक का बड़ा हिस्सा सोख लेता है। व्यक्तिगत नतीजे ऐसे कैश नहीं हो सकते, और यही एक वजह है कि व्यक्तिगत बनाना आमतौर पर ऊपर की एक पतली दोबारा रैंकिंग परत होता है। - ऑटोकंप्लीट सेवा। बिना स्थिति के अनुरोध संभालना: उपसर्ग को मानक रूप देना (छोटे अक्षर, किनारे की जगह हटाना, यूनिकोड मानकीकरण), सही ट्राई हिस्से तक भेजना, रखी हुई सूची लौटाना।
- रैम में ट्राई के हिस्से। पूरा इंडेक्स मेमोरी में रहता है। हर नोड अपना पहले से गिना टॉप १० रखता है।
डेटा रास्ता (घंटे)
- सर्च लॉग। हर भेजी गई सर्च (हर कीस्ट्रोक नहीं) समय, भाषा और इस जानकारी के साथ दर्ज होती है कि उपयोगकर्ता ने किसी नतीजे पर क्लिक किया या नहीं।
- एकत्रक (गिनती और घटता भार)। एक बैच या धारा वाला काम हर क्वेरी का अंक निकालता है, हाल की सर्च को ज्यादा भार देकर, ताकि पिछले हफ्ते की ताजा खबर फीकी पड़े और किसी नए उत्पाद का नाम ऊपर आए।
- ट्राई निर्माता और रोक सूची फिल्टर। रोके गए शब्द, निजी डेटा और स्पैम हटाता है, फिर हर नोड की टॉप-के सूची के साथ ट्राई बनाता है।
- प्रतियां (ऑब्जेक्ट स्टोर)। संस्करण वाली ट्राई फाइलें। सर्वर नया संस्करण पृष्ठभूमि में लोड करके एक झटके में बदलते हैं; खराब निर्माण को पिछले संस्करण की ओर इशारा करके पलटा जा सकता है।
यह बंटवारा ही पूरा डिजाइन है। क्वेरी रास्ता कभी कुछ गणना नहीं करता; डेटा रास्ता कभी कुछ परोसता नहीं।
हर नोड पर टॉप-के वाला ट्राई
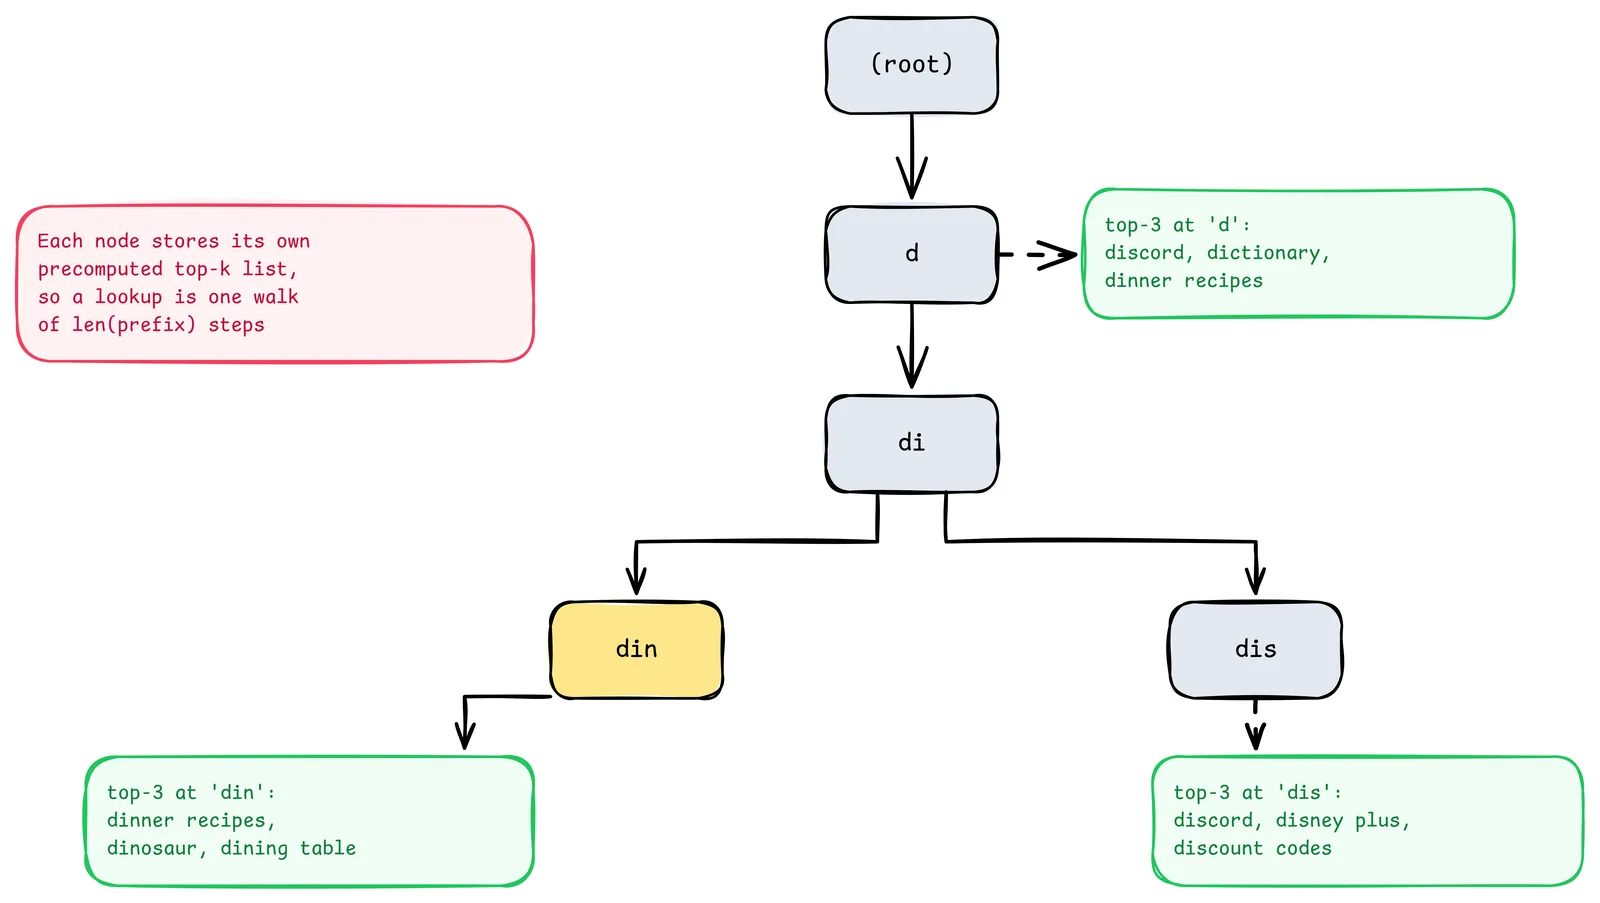
सादा ट्राई किसी उपसर्ग वाले सारे शब्द उपसर्ग वाले नोड तक जाकर और उसके नीचे का सब कुछ खंगालकर ढूंढता है। उपसर्ग d के लिए वह उप-पेड़ बहुत बड़ा है। इलाज है जवाब नोड पर ही रख देना: बनाते समय हर क्वेरी का अंक उसके रास्ते के हर नोड की टॉप-के सूची में डालें। तब खोज len(prefix) कदम चलकर एक सूची लौटाना भर है।
import heapq

class Node:
    __slots__ = ("children", "top")
    def __init__(self):
        self.children, self.top = {}, []

def build(counts: dict[str, int], k: int = 10) -> Node:
    root = Node()
    for query, score in counts.items():
        node = root
        for ch in query:
            node = node.children.setdefault(ch, Node())
            heapq.heappush(node.top, (score, query))
            if len(node.top) > k:
                heapq.heappop(node.top)          # keep only the k best
    for node in _walk(root):                      # freeze: best first
        node.top = [q for _, q in sorted(node.top, reverse=True)]
    return root

def _walk(node):
    yield node
    for child in node.children.values():
        yield from _walk(child)

def suggest(root: Node, prefix: str) -> list[str]:
    node = root
    for ch in prefix.lower():
        node = node.children.get(ch)
        if node is None:
            return []
    return node.top
अंकों discord: 2000, dictionary: 1200, dinner recipes: 900, disney plus: 850, discount codes: 800, dinosaur: 700, dining table: 650 और के = ३ के साथ suggest("din") लौटाता है ["dinner recipes", "dinosaur", "dining table"], ठीक चित्र की तरह। मैंने इसे चलाकर जांचा।
मेमोरी का सौदा। हर नोड पर के सुझाव रखना मेमोरी कई गुना कर देता है, इसलिए उत्पादन सिस्टम शब्दों के बजाय क्वेरी आईडी रखते हैं, यह सीमित करते हैं कि किस गहराई तक सूचियां रखी जाएं (गहरे उपसर्ग कम आते हैं और उप-पेड़ खंगालने पर लौट सकते हैं), और ढांचे को दबाते हैं। ल्यूसीन और इलास्टिकसर्च का कंप्लीशन सजेस्टर ठीक इसी वजह से सीमित अवस्था ट्रांसड्यूसर इस्तेमाल करता है: वे साझा उपसर्ग और प्रत्यय बांटते हैं और बड़ी शब्दावलियां मेमोरी में समा देते हैं।
रैंकिंग और ताजगी
| संकेत | असर |
|---|---|
| समय के साथ घटते भार वाली क्वेरी आवृत्ति | मूल लोकप्रियता जो नए रुझानों को फिर भी ऊपर आने देती है |
| नतीजों पर क्लिक | जो क्वेरी कहीं नहीं ले जातीं, वे नीचे जाती हैं |
| भाषा और क्षेत्र | football का मतलब अलग देशों में अलग है |
| निजी इतिहास | वैश्विक सूची की हल्की दोबारा रैंकिंग, सेवा में, ट्राई में नहीं |
| रुझान पहचान | एक छोटा धारा वाला रास्ता जो पूरे निर्माणों के बीच उभरती क्वेरी जोड़ता है |
हर कुछ घंटों में पूरा निर्माण ज्यादातर ताजगी जरूरतें पूरी करता है। ताजा घटनाओं के लिए एक धारा वाला काम छोटा "रुझान" ट्राई बना सकता है जिसे सेवा मुख्य नतीजे में मिलाती है, ताकि अचानक आया उछाल घंटों नहीं, मिनटों में दिखे।
क्वेरी रास्ते को बढ़ाना
- बांटने से पहले प्रतियां बनाएं। एक भाषा का छना हुआ ट्राई अक्सर दसियों गीगाबाइट रैम में समा जाता है। पूरा ट्राई हर सर्वर पर दोहराना बांटने से आसान है और हर सर्वर को पूरा जवाब देता है।
- न समाए तो उपसर्ग से बांटें। पहले एक या दो अक्षरों पर बांटें, झुकाव वाले अक्षरों के लिए बारीक कटाव के साथ (
sसे शुरू होने वाली क्वेरीxसे कहीं ज्यादा हैं)। सेवा मानक उपसर्ग से रास्ता तय करती है। - किनारे पर जमकर कैश करें। छोटे उपसर्ग सबसे गर्म और सबसे कम व्यक्तिगत हैं; उन्हें मिनटों वाले सीडीएन टीटीएल दें।
- विफलता पर कुछ न लौटाएं। ऑटोकंप्लीट बंद हो तो तुरंत खाली सूची लौटाएं। सर्च बॉक्स फिर भी चलता है; उपयोगकर्ता बस थोड़ा ज्यादा लिखते हैं।
सुरक्षा वैकल्पिक नहीं है
ऑटोकंप्लीट उपयोगकर्ताओं के मुंह में शब्द डालता है। हर बड़ी सर्च कंपनी किसी ऐसे सुझाव से शर्मिंदा हो चुकी है जिसने किसी व्यक्ति के नाम को आरोप से या किसी समूह के नाम को गाली से पूरा किया।
- नफरत, हिंसा, यौन सामग्री और खुद को नुकसान पहुंचाने वाली सामग्री की रोक सूचियां रखें, निर्माता में लागू और आपातकालीन जोड़ों के लिए परोसते समय दोबारा जांची हुई।
- जोड़ने से पहले लॉग से फोन नंबर और ईमेल पते जैसा निजी डेटा हटाएं।
- लोगों के बारे में क्वेरी पर खास सावधानी रखें; कई उत्पाद संवेदनशील संदर्भों में नाम वाले व्यक्तियों के बारे में पूरे रूप नहीं सुझाते।
- किसी क्वेरी के सुझाए जाने से पहले कम से कम कुछ अलग उपयोगकर्ताओं की शर्त रखें, ताकि एक व्यक्ति या बॉट सुझाव न घुसा सके।
- हर सुझाव के लिए आपातकालीन बंद बटन रखें जो अगले निर्माण पर नहीं, मिनटों में असर करे।
उत्पादन जांच सूची
- ग्राहक की ओर डिबाउंस, हर उपसर्ग का स्थानीय कैश और अनुरोध रद्द करना
- निर्माता और सेवा में एक जैसा उपसर्ग मानकीकरण
- हर नोड पर टॉप-के; हर निर्माण में मेमोरी मापी गई
- निर्माण संस्करण वाले, जांचे गए (आकार, नमूना क्वेरी, रोक सूची जांच) और एक झटके में बदले जाने वाले
- एक कदम में पिछली प्रति पर लौटना
- छोटे, गैर-व्यक्तिगत उपसर्गों के लिए सीडीएन कैश
- न्यूनतम अलग उपयोगकर्ता सीमा और रोक सूचियां, और आपातकालीन हटाने का रास्ता
- खाली सूची के साथ तेज विफलता; सर्च ऑटोकंप्लीट पर निर्भर न हो
- डैशबोर्ड: पी९९ देरी, कैश हिट दरें (ग्राहक, सीडीएन, सेवा), सुझावों पर क्लिक, निर्माण की उम्र
जो बचा रह गया
सबसे अच्छा ऑटोकंप्लीट वह है जिसके बारे में उपयोगकर्ता कभी सोचते ही नहीं। वे तीन अक्षर लिखते हैं, जो चाहिए था वह पहले से वहां है, और वे एंटर दबा देते हैं।
उस पल के पीछे घंटों पहले चली एक पाइपलाइन है, आधी रात को किसी की अपडेट की हुई रोक सूची है, और बिना आवाज लोड हुई एक प्रति है। उपयोगकर्ता ने दस शब्द देखे। सिस्टम ने उन करोड़ों लोगों को याद रखा जिन्होंने पहले वही सवाल पूछा था।