संक्षेप (टीएल;डीआर)
- समस्या: बड़े सिस्टमों का हर आर्किटेक्चर चित्र आखिरी अवस्था दिखाता है। टीमें पहले ही दिन वह आखिरी अवस्था नकल करके जटिलता में डूब जाती हैं, या किसी लॉन्च में डेटाबेस गिरने तक पैमाने को नजरअंदाज करती हैं।
- डिजाइन: आठ कदमों में बढ़ें (डेटाबेस अलग करें, लोड बैलेंसर जोड़ें, पढ़ने वाली प्रतिकृतियां और कैश जोड़ें, स्थिर फाइलें सीडीएन पर ले जाएं और ऐप सर्वरों को बिना स्थिति का बनाएं, धीमा काम कतारों में भेजें, क्षेत्र जोड़ें, मुख्य डेटाबेस बांटें), और हर कदम तभी उठाएं जब कोई माप बताए कि पिछला डिजाइन चुक गया है।
- नतीजा: ऐसा सिस्टम जो अपने ट्रैफिक की जरूरत से कभी ज्यादा जटिल नहीं होता, और डैशबोर्ड लाल होने पर अगली चाल तैयार रहती है। कई बहुत बड़े उत्पाद सालों तक हैरान करने लायक कम मशीनों पर चले, क्योंकि उन्होंने ये कदम देर से और अच्छी तरह उठाए।
इंटरनेट की सबसे व्यस्त साइटों में से एक, स्टैक ओवरफ्लो, सालों तक लगभग नौ वेब सर्वर और कुछ एसक्यूएल सर्वर मशीनों पर चली। इंस्टाग्राम एक छोटी टीम और जैंगो, पोस्टग्रेस, रेडिस और मेमकैश्ड वाले काफी पारंपरिक ढांचे के साथ करोड़ों उपयोगकर्ताओं तक पहुंचा। सबक यह नहीं कि पैमाना बढ़ाना आसान है। सबक यह है कि पैमाना बढ़ाने का ज्यादातर हिस्सा सही समय पर, मापकर, अगली स्पष्ट चीज करना है, न कि बहुत जल्दी कोई प्रभावशाली चीज।
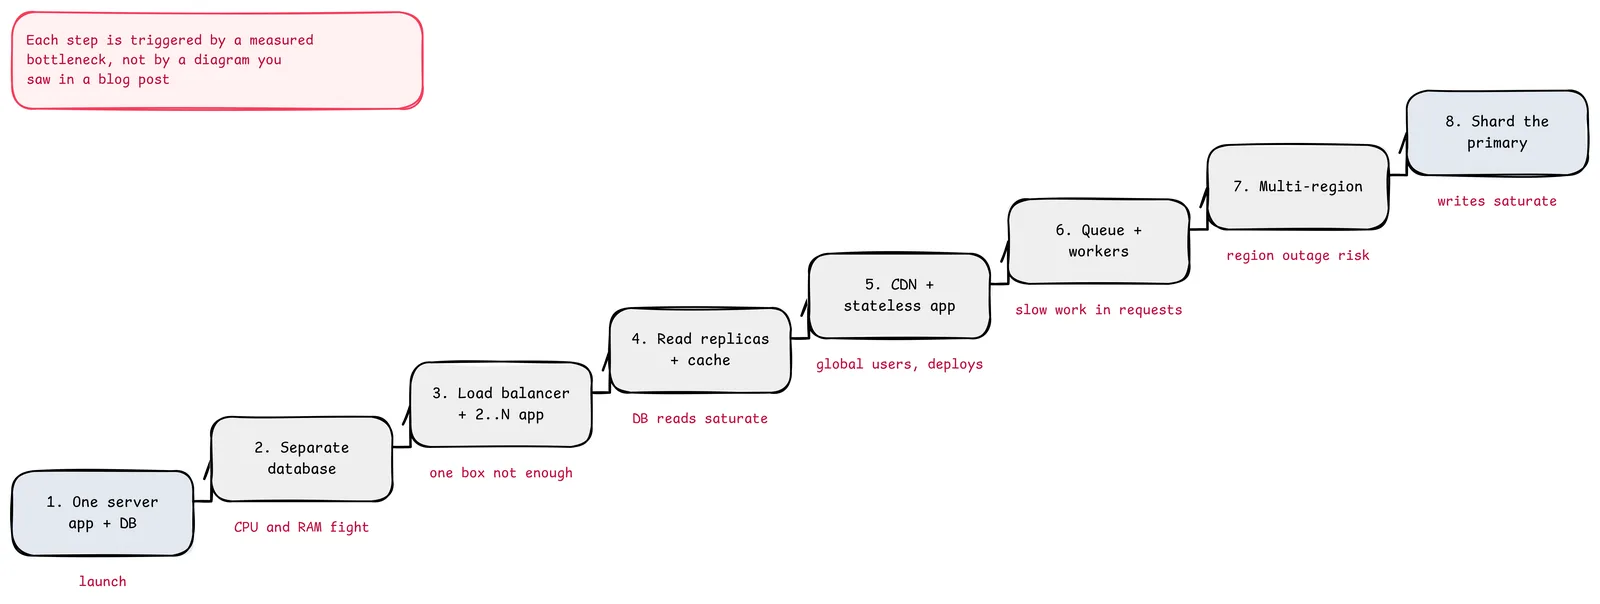
लाल नोट पूरे लेख का नियम है। नीचे का हर कदम बताता है कि वह किससे शुरू होता है, क्या देता है और कौन सी नई समस्या लाता है।
कदम १: एक सर्वर
ऐप, डेटाबेस और फाइलें एक ही मशीन पर। नए उत्पाद के लिए यही सही आर्किटेक्चर है: तैनात करने को एक चीज, बैकअप के लिए एक चीज, हिस्सों के बीच कोई नेटवर्क नहीं।
आगे कब बढ़ें: ऐप और डेटाबेस सीपीयू और मेमोरी के लिए लड़ने लगें, या एक को दूसरे के बिना दोबारा शुरू करना पड़े।
कदम २: डेटाबेस अलग करें
डेटाबेस को उसकी अपनी मशीन (या प्रबंधित सेवा) पर रखें। अब दोनों का आकार अलग-अलग तय हो सकता है, और डेटाबेस होस्ट सिर्फ क्वेरी परोसता है।
नई समस्या: नेटवर्क का चक्कर। जो क्वेरी स्थानीय मशीन पर सस्ती थीं, अब हर एक एक चक्कर लेती है, इसलिए एक के बाद एक ढेर सारी क्वेरी वाला ढर्रा अचानक मायने रखने लगता है।
आगे कब बढ़ें: शिखर पर ऐप सर्वर का सीपीयू भर जाए, या उस एक मशीन के दोबारा शुरू होने की रुकावट बर्दाश्त न हो।
कदम ३: लोड बैलेंसर और कई ऐप सर्वर
दो या ज्यादा ऐप सर्वर लोड बैलेंसर के पीछे रखें। वेब परत बढ़ाना अब मशीनें जोड़ना है।
नई समस्या: स्थिति। अगर किसी उपयोगकर्ता का सत्र एक सर्वर की मेमोरी में है, तो अगला अनुरोध कहीं और पहुंच सकता है। या तो चिपकने वाले सत्र इस्तेमाल करें (सरल, पर नाजुक), या बेहतर, सत्र पूरी तरह ऐप सर्वरों से बाहर निकालें (कदम ५)।
आगे कब बढ़ें: सीमा अब ऐप परत नहीं, डेटाबेस है। आमतौर पर पठन।
कदम ४: पढ़ने वाली प्रतिकृतियां और कैश
ज्यादातर उत्पाद लिखने से कहीं ज्यादा पढ़ते हैं। दो औजार पठन पर हमला करते हैं:
- पढ़ने वाली प्रतिकृतियां मुख्य डेटाबेस का डेटा असिंक्रोनस रूप से कॉपी करती हैं और पठन क्वेरी परोसती हैं।
- कैश (रेडिस या मेमकैश्ड) गर्म नतीजे मेमोरी में कैश-असाइड तरीके से रखता है: कैश से पढ़ो, चूके तो डेटाबेस से पढ़कर टीटीएल के साथ कैश भरो।
नई समस्याएं:
- प्रतिकृति की देरी। उपयोगकर्ता अपनी प्रोफाइल बदलता है, पेज ताजा करता है और पुराना मान देखता है क्योंकि पठन किसी प्रतिकृति पर गया। लिखने के बाद थोड़ी देर उस उपयोगकर्ता के पठन मुख्य डेटाबेस पर भेजें (अपना लिखा पढ़ो), या अहम डेटा मुख्य से पढ़ें।
- कैश अमान्य करना और भगदड़। लिखते समय कैश कुंजियां मिटाएं या बदलें, सुरक्षा जाल के रूप में टीटीएल रखें, और एक ही कुंजी की एक साथ चूकों को समेटें।
आगे कब बढ़ें: दूर के उपयोगकर्ताओं को पेज धीमे दिखें, या तैनाती तकलीफदेह हो क्योंकि सर्वर स्थिति रखते हैं।
कदम ५: सीडीएन और बिना स्थिति वाले ऐप सर्वर
- सीडीएन। चित्र, स्क्रिप्ट, स्टाइल और वीडियो उपयोगकर्ताओं के पास के किनारे वाले ठिकानों से परोसें। मूल सर्वर सिर्फ बदलते जवाब देता है।
- बिना स्थिति वाले सर्वर। सत्र साझा स्टोर (रेडिस या हस्ताक्षरित टोकन) में जाते हैं, अपलोड ऑब्जेक्ट स्टोरेज में जाते हैं, और ऐप सर्वर की डिस्क पर कुछ भी अहम नहीं रहता। कोई भी सर्वर कोई भी अनुरोध संभाल सकता है, इसलिए ऑटोस्केलिंग और तैनाती रोज का काम बन जाते हैं।
नई समस्या: स्थिर फाइलों के कैश हेडर और अमान्यकरण। फाइल नामों में छाप जोड़ें (app.3f9c1.js) ताकि कभी साफ करने की जरूरत न पड़े।
आगे कब बढ़ें: अनुरोध धीमे हों क्योंकि वे धीमा काम भीतर ही करते हैं (ईमेल भेजना, चित्र छोटे करना, तीसरे पक्ष को बुलाना)।
कदम ६: कतारें और वर्कर
धीमा या विफल होने वाला काम अनुरोध के रास्ते से बाहर निकालें। अनुरोध एक संदेश लिखकर लौट जाता है; वर्कर उसे संभालते हैं।
नई समस्याएं: दोबारा कोशिश और दोहराव से सुरक्षा (एक संदेश दो बार पहुंच सकता है), क्रम (अगर हो तो सिर्फ एक हिस्से के भीतर), और दिखना (पीछे छूटा काम तब तक नहीं दिखता जब तक उसका ग्राफ न बने)। मृत संदेश कतार और कतार की गहराई पर चेतावनी जरूरी हैं।
आगे कब बढ़ें: एक क्षेत्र का बंद होना कारोबार के लिए विनाशकारी हो, या दूर के उपयोगकर्ताओं को बदलते अनुरोधों पर अस्वीकार्य देरी हो।
कदम ७: कई क्षेत्र
ढांचे को दो या ज्यादा क्षेत्रों में चलाएं, जियोडीएनएस या एनीकास्ट से हर उपयोगकर्ता को सबसे पास के स्वस्थ क्षेत्र तक भेजते हुए।
| मॉडल | कैसे काम करता है | कीमत |
|---|---|---|
| सक्रिय-निष्क्रिय | एक क्षेत्र ट्रैफिक संभालता है; दूसरा दोहराए डेटा के साथ गर्म तैयारी में | हस्तांतरण में मिनट लगते हैं और अभ्यास जरूरी; हाल के लेखन खो सकते हैं |
| सक्रिय-सक्रिय, बंटा हुआ | हर उपयोगकर्ता के डेटा का एक घर वाला क्षेत्र; दोनों क्षेत्र ट्रैफिक संभालते हैं | रूटिंग और डेटा रखने का तर्क; साझा डेटा के लिए क्षेत्रों के बीच अनुरोध |
| सक्रिय-सक्रिय, वैश्विक डेटा | हर क्षेत्र साझा डेटा पर लेखन स्वीकार करता है | टकराव हल करना, या ज्यादा लेखन देरी वाला वैश्विक रूप से संगत डेटाबेस |
नई समस्या: डेटा। बिना स्थिति वाली परतें आसानी से दोहराई जाती हैं; डेटाबेस नहीं। मॉडल यह पूछकर चुनें कि किसी क्षेत्र के गिरने से एक सेकंड पहले हुए लेखन का क्या होगा।
आगे कब बढ़ें: खरीदी जा सकने वाली सबसे बड़ी मशीन पर भी मुख्य डेटाबेस लेखन भार न सह पाए।
कदम ८: मुख्य डेटाबेस बांटें
बांटने से पहले सस्ते विकल्प खत्म करें: बड़ी मशीन, क्वेरी और सूचकांक सुधारना, ज्यादा लेखन वाली सुविधाओं को क्षेत्र के हिसाब से अलग डेटाबेस में ले जाना (संघीकरण), और ठंडा डेटा संग्रह में भेजना। बंटवारा आखिरी कदम है, और इसकी वजह है।
जब बांटें, तो पंक्तियों को एक बंटवारा कुंजी के हिसाब से कई डेटाबेस में बांटें:
- कुंजी मुख्य पहुंच के ढर्रे से चुनें। कई किरायेदारों वाला सॉफ्टवेयर किरायेदार से बांटता है; सोशल ऐप अक्सर उपयोगकर्ता से। जिन क्वेरी में कुंजी होती है, वे एक ही हिस्से तक जाती हैं।
- गर्म हिस्सों से बचें। समय की सीमाओं या क्रमिक आईडी के बजाय कुंजी का हैश इस्तेमाल करें।
- पहले दिन से दोबारा बांटने की योजना बनाएं। कम भौतिक डेटाबेस पर कई तार्किक हिस्से रखें, ताकि बढ़ने का मतलब तार्किक हिस्से खिसकाना हो, हर पंक्ति का हैश दोबारा निकालना नहीं (देखें कंसिस्टेंट हैशिंग)।
नई समस्याएं: हिस्सों के पार क्वेरी और लेनदेन ऐप का कोड बन जाते हैं, हिस्सों के पार अद्वितीयता के लिए वैश्विक आईडी योजना चाहिए (अद्वितीय आईडी जनरेटर), और संचालन का काम हिस्सों की संख्या से गुणा हो जाता है।
मंजिल, संदर्भ के लिए
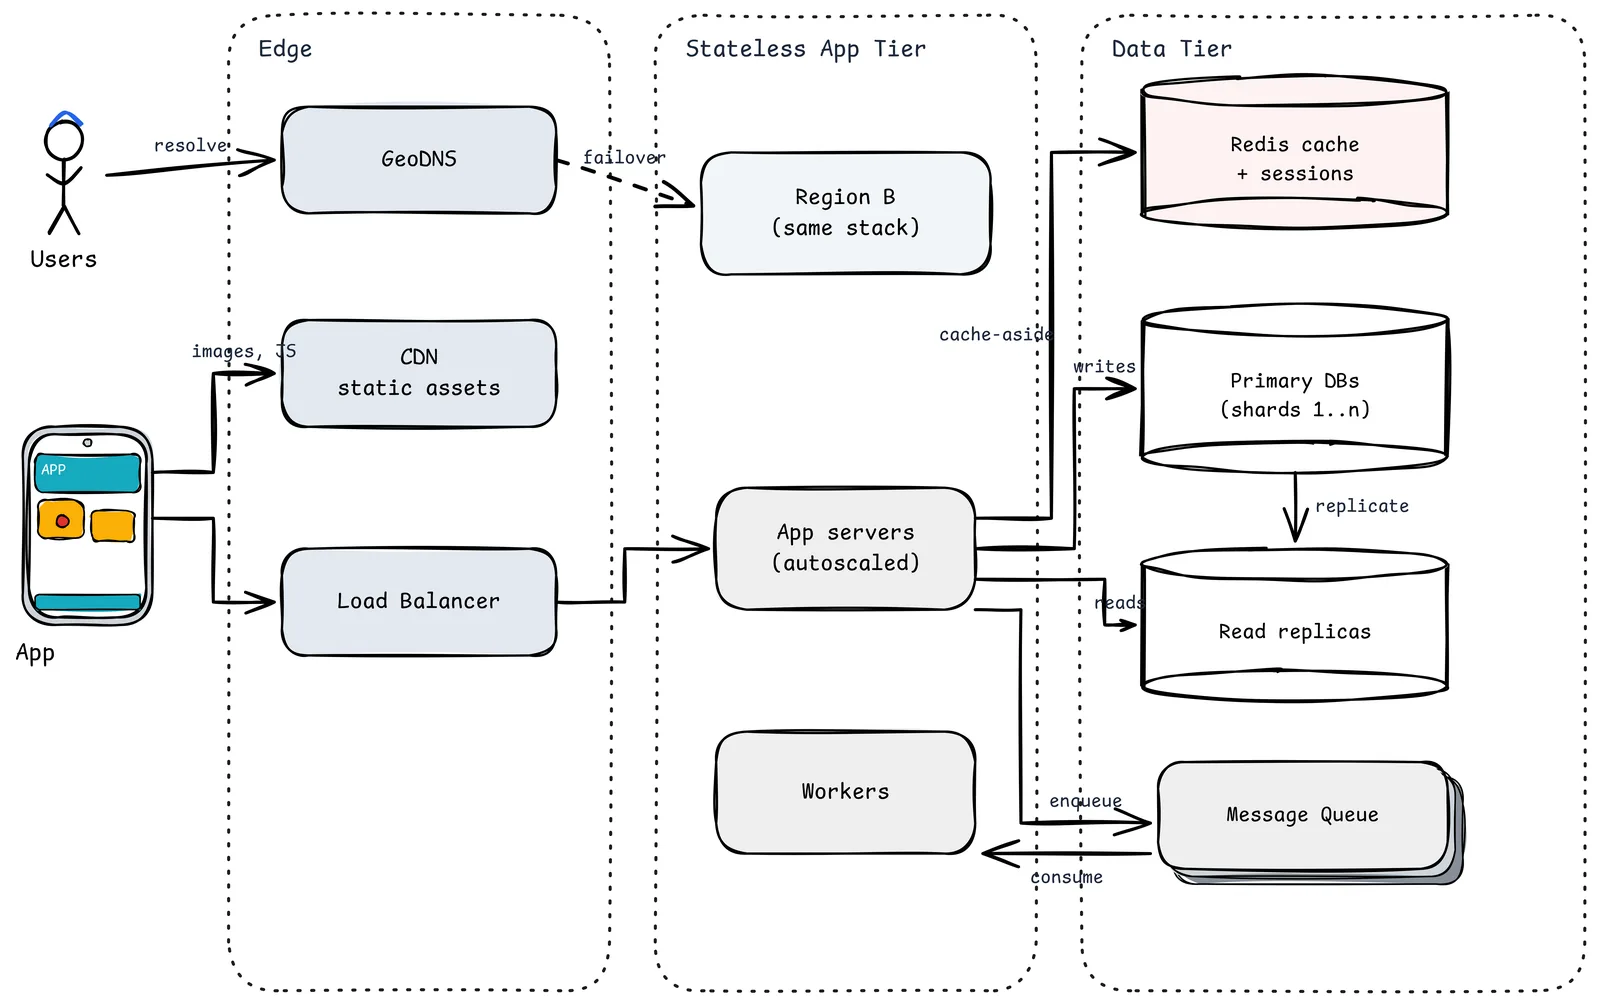
- जियोडीएनएस उपयोगकर्ताओं को सबसे पास के स्वस्थ क्षेत्र तक भेजता है और क्षेत्र बी पर हस्तांतरण करता है।
- सीडीएन किनारे से स्थिर फाइलें परोसता है।
- लोड बैलेंसर अनुरोधों को ऑटोस्केल होने वाले, बिना स्थिति के ऐप सर्वरों में बांटता है।
- रेडिस कैश प्रविष्टियां और सत्र रखता है।
- मुख्य डेटाबेस (हिस्से १ से एन) लेखन लेते हैं; पढ़ने वाली प्रतिकृतियां पठन ट्रैफिक लेती हैं।
- संदेश कतार और वर्कर वह सब संभालते हैं जिसका जवाब से पहले पूरा होना जरूरी नहीं।
कई बड़े उत्पाद यहीं पहुंचते हैं। शुरुआत के लिए यह बहुत बुरी जगह है।
आगे बढ़ने का समय जानने के लिए क्या मापें
| संकेत | सुझाव |
|---|---|
| शिखर पर ऐप का सीपीयू ऊंचा, डेटाबेस ठीक | ऐप सर्वर जोड़ें (कदम ३) |
| डेटाबेस का सीपीयू या आईओ ऊंचा, ज्यादातर पठन | प्रतिकृतियां और कैश (कदम ४) |
| आपके क्षेत्र से दूर के उपयोगकर्ताओं का पी९९ ऊंचा | सीडीएन (कदम ५), फिर क्षेत्र (कदम ७) |
| देरी पर बाहरी कॉल हावी | कतारें और वर्कर (कदम ६) |
| सुधार के बाद भी मुख्य का लेखन या स्टोरेज सीमा के पास | संघीकरण, फिर बंटवारा (कदम ८) |
जो बचा रह गया
सबसे महंगा आर्किटेक्चर वह है जो आपने उस ट्रैफिक के लिए बनाया जो आपके पास है ही नहीं। दूसरा सबसे महंगा वह है जो ट्रैफिक आने वाले दिन गिर जाता है।
दोनों के बीच का रास्ता उबाऊ है: कुछ डैशबोर्ड, अगले तीन कदमों की लिखी हुई सूची, और कोई कदम तभी उठाने का अनुशासन जब कोई ग्राफ कहे। प्रभावशाली चित्र जरूरत पड़ने पर भी वहीं मिलेगा।
स्रोत
- निक क्रेवर: स्टैक ओवरफ्लो का आर्किटेक्चर (२०१६ संस्करण)
- इंस्टाग्राम इंजीनियरिंग: इंस्टाग्राम को क्या चलाता है
- एडब्ल्यूएस वेल-आर्किटेक्टेड फ्रेमवर्क: विश्वसनीयता स्तंभ (कई क्षेत्रों के तरीके)
- मार्टिन फाउलर: सीक्यूआरएस और पठन मॉडल
- इसी श्रृंखला में: मोटा अनुमान लगाना, कंसिस्टेंट हैशिंग डिजाइन करें, रेडिस कैशिंग के तरीके