संक्षेप (टीएल;डीआर)
- समस्या: डिजाइन की चर्चाएं विशेषणों ("बहुत ट्रैफिक", "बड़ी फाइलें") में अटक जाती हैं क्योंकि किसी ने उन्हें संख्याओं में नहीं बदला। संख्याओं के बिना आप नहीं बता सकते कि एक डेटाबेस चाहिए या सौ, या चित्र अपने सर्वरों से परोसे जा सकते हैं या नहीं।
- तरीका: कुछ स्थिरांक याद रखें (एक दिन लगभग १०^५ सेकंड है, दो की घातें, मोटी देरियां), फिर पांच नुस्खे चलाएं: प्रति सेकंड क्वेरी, स्टोरेज, बैंडविड्थ, कैश का आकार और सर्वरों की संख्या। बेझिझक गोल करें, हर मान्यता बताएं, और जैसे ही संख्याएं कोई फैसला साफ कर दें, रुक जाएं।
- नतीजा: पांच मिनट में आप जान जाते हैं कि सिस्टम का कौन सा हिस्सा कठिन है। नीचे के उदाहरण में गणित दिखा देता है कि कोई भी डिब्बा बनाने से बहुत पहले चित्रों को सीडीएन और ऑब्जेक्ट स्टोरेज से जाना होगा।
अनुमान लगाना सही होने के बारे में नहीं है। यह कुछ गुना के दायरे में, जल्दी से सही होने के बारे में है, ताकि डिजाइन की बातचीत उस हिस्से पर टिक सके जो मायने रखता है।
जिस सिस्टम को हर सेकंड ५० लेखन चाहिए और जिसे ५०,००० चाहिए, वे दो अलग सिस्टम हैं। ५० जीबी का डेटा रैम में समा जाता है; ५० टीबी नहीं। इन्हें अलग पहचानने के लिए सटीकता नहीं चाहिए। परिमाण का क्रम चाहिए, और उसे लिख लेने का अनुशासन।
याद रखने लायक स्थिरांक
समय
| मात्रा | लगभग मान |
|---|---|
| एक दिन में सेकंड | ८६,४००, इसे १०^५ मानें |
| एक महीने में सेकंड | लगभग २६ लाख, इसे २.५ गुणा १०^६ मानें |
| एक साल में सेकंड | लगभग ३.१५ करोड़, इसे ३ गुणा १०^७ मानें |
आकार
| दो की घात | लगभग | इकाई |
|---|---|---|
| २^१० | एक हजार | केबी |
| २^२० | दस लाख | एमबी |
| २^३० | एक अरब | जीबी |
| २^४० | एक लाख करोड़ | टीबी |
| २^५० | दस करोड़ करोड़ | पीबी |
देरी (परिमाण के क्रम)
| काम | मोटा समय |
|---|---|
| मुख्य मेमोरी तक पहुंच | लगभग १०० नैनोसेकंड |
| मेमोरी से १ एमबी क्रम से पढ़ना | कुछ माइक्रोसेकंड |
| एसएसडी से बेतरतीब पठन | दसियों माइक्रोसेकंड |
| एक डेटा सेंटर के भीतर आना-जाना | लगभग ०.५ मिलीसेकंड |
| एसएसडी से १ एमबी क्रम से पढ़ना | दसियों माइक्रोसेकंड से लगभग १ मिलीसेकंड |
| घूमने वाली डिस्क पर खोज | लगभग ५ से १० मिलीसेकंड |
| महासागर के पार आना-जाना | लगभग १०० से १५० मिलीसेकंड |
ये जेफ डीन और पीटर नॉर्विग की लोकप्रिय बनाई "हर प्रोग्रामर को जानने लायक देरी की संख्याएं" वाली क्लासिक सूची से हैं, जिसे बाद में आधुनिक हार्डवेयर के लिए अपडेट किया गया। सटीक मान बदलते रहते हैं; अनुपात मायने रखते हैं। मेमोरी नेटवर्क के एक चक्कर से हजार गुना तेज है, और वह चक्कर महासागर पार करने से सौ गुना तेज।
उपलब्धता
| उपलब्धता | साल में बंद रहने का समय | महीने में बंद रहने का समय |
|---|---|---|
| ९९% | लगभग ३.६५ दिन | लगभग ७.३ घंटे |
| ९९.९% | लगभग ८.८ घंटे | लगभग ४४ मिनट |
| ९९.९९% | लगभग ५३ मिनट | लगभग ४.४ मिनट |
| ९९.९९९% | लगभग ५.३ मिनट | लगभग २६ सेकंड |
हर अतिरिक्त नौ लगभग दस गुना ज्यादा इंजीनियरिंग मांगता है। चार नौ का मतलब है कि ज्यादातर घटनाओं में कोई इंसान बीच में नहीं हो सकता; ठीक होना अपने आप होना चाहिए।
पांच नुस्खे
१. प्रति सेकंड क्वेरी। रोज की घटनाएं भाग १०^५। फिर शिखर गुणक से गुणा करें (एक जैसे वैश्विक ट्रैफिक के लिए २ गुना, उछाल वाले उपभोक्ता उत्पादों के लिए ५ से १० गुना)। २. स्टोरेज। रोज की वस्तुएं गुणा हर वस्तु का आकार गुणा रखने की अवधि गुणा प्रतिकृति या एन्कोडिंग का अतिरिक्त खर्च। ३. बैंडविड्थ। प्रति सेकंड क्वेरी गुणा जवाब का आकार, पठन और लेखन अलग-अलग। ४. कैश। मानें कि २०% वस्तुओं को ८०% पठन मिलते हैं; एक दिन के काम के समूह के गर्म २०% के लिए कैश का आकार रखें। ५. सर्वर। शिखर क्वेरी भाग एक सर्वर की क्षमता, और ऊपर से गुंजाइश (शिखर पर ५०-७०% इस्तेमाल का लक्ष्य)।
पूरा हल किया उदाहरण: फोटो साझा करने वाला ऐप
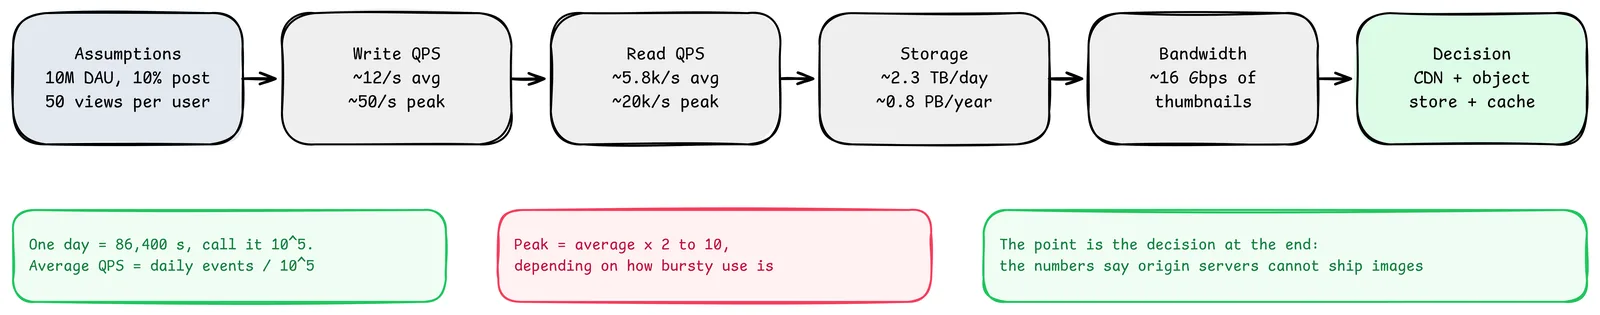
मान्यताएं (इन्हें बोलकर बताएं; इंटरव्यू लेने वाला या आपकी टीम इन्हें बदल सकती है):
- रोज के १ करोड़ सक्रिय उपयोगकर्ता।
- उनमें से १०% रोज एक फोटो पोस्ट करते हैं।
- हर उपयोगकर्ता रोज ५० फोटो देखता है।
- हर अपलोड २ एमबी के मूल और थंबनेल के रूप में रखा जाता है, कुल लगभग २.३ एमबी।
- हर व्यू लगभग १०० केबी का थंबनेल लोड करता है।
लेखन क्वेरी: रोज १० लाख अपलोड भाग १०^५ ≈ औसतन हर सेकंड १० से १२। ४ गुना शिखर के साथ लगभग हर सेकंड ५०। लेखन समस्या नहीं है।
पठन क्वेरी: १ करोड़ गुणा ५० = रोज ५० करोड़ व्यू भाग १०^५ ≈ हर सेकंड ५,८००, शिखर पर लगभग हर सेकंड २०,०००। पठन लेखन के ४०० से ५०० गुना हैं।
स्टोरेज: १० लाख गुणा २.३ एमबी ≈ रोज २.३ टीबी, प्रतिकृति से पहले लगभग साल में ०.८ पीबी। ३ गुना प्रतिकृति के साथ साल में लगभग २.५ पीबी; मिटाव कोड (लगभग १.५ गुना अतिरिक्त) के साथ लगभग १.२ पीबी। हर फोटो के १ केबी के हिसाब से मेटाडेटा रोज सिर्फ लगभग १ जीबी है: चित्रों के आगे कुछ भी नहीं।
बैंडविड्थ: हर सेकंड २०,००० थंबनेल गुणा १०० केबी ≈ २ जीबी प्रति सेकंड ≈ शिखर पर १६ गीगाबिट प्रति सेकंड, सिर्फ थंबनेल के लिए।
संख्याएं क्या तय करती हैं:
- चित्र ऑब्जेक्ट स्टोरेज में जाते हैं, डेटाबेस में नहीं। पेटाबाइट के ब्लॉब पंक्तियों में नहीं रहते।
- चित्र सीडीएन से परोसे जाते हैं। मूल सर्वरों से सोलह गीगाबिट प्रति सेकंड महंगा और दूर के उपयोगकर्ताओं के लिए धीमा होगा; सीडीएन ज्यादातर किनारे से परोसता है।
- मेटाडेटा डेटाबेस मामूली है। पढ़ने वाली प्रतिकृतियों और कैश के साथ एक मुख्य डेटाबेस हर सेकंड २०,००० पठन आराम से संभालता है, खासकर तब जब चित्रों का ट्रैफिक सीडीएन सोख लेता है।
- लेखन कम हैं, इसलिए सरल, संगत लेखन रास्ता काफी है। लेखन बढ़ाने के किसी अनोखे तरीके की जरूरत नहीं।
आखिरी सूची ही पूरी कवायद का मतलब है। चित्र का हरा डिब्बा नतीजा है; उससे पहले का सब यह है कि आपने उसे कहने का हक कैसे कमाया।
दिखावे के बिना सर्वरों की संख्या
एक सर्वर कितने अनुरोध संभाल सकता है? यह हर अनुरोध के काम पर बहुत निर्भर है, इसलिए दायरे इस्तेमाल करें और यह बताएं:
| हिस्सा | हर नोड की मोटी क्षमता (सरल काम) |
|---|---|
| बिना स्थिति वाला ऐप सर्वर, सरल जेसन एपीआई | हर सेकंड लगभग १,००० से १०,००० अनुरोध |
| रेडिस या मेमकैश्ड | हर सेकंड लगभग १ लाख से ज्यादा सरल काम |
| रिलेशनल डेटाबेस, सूचकांक वाले बिंदु पठन | हर सेकंड हजारों से दसियों हजार, काम पर बहुत निर्भर |
| सीडीएन का किनारा | आपकी नजर से लगभग असीमित |
शिखर पर हर सेकंड २०,००० अनुरोध और स्वस्थ इस्तेमाल पर हर ऐप सर्वर के २,००० के साथ आपको लगभग १० ऐप सर्वर चाहिए, और गुंजाइश तथा तैनाती के लिए कुछ और। उत्पादन में इनमें से किसी संख्या पर भरोसा करने से पहले अपनी सेवा को भार परीक्षण से मापें।
वे गलतियां जो अनुमान को बेकार बनाती हैं
- झूठी सटीकता। "११.५७४ क्वेरी प्रति सेकंड" बताता है कि आप असली बात चूक गए। कहें "लगभग १०"।
- शिखर भूलना। औसत उस घंटे को छिपा देते हैं जब हर कोई ऐप खोलता है।
- प्रतिकृति और अतिरिक्त खर्च भूलना। तीन प्रतिकृतियां स्टोरेज तिगुना करती हैं। सूचकांक, लॉग और बैकअप और जोड़ते हैं।
- बिट और बाइट मिलाना। नेटवर्क लिंक बिट प्रति सेकंड में बताए जाते हैं; स्टोरेज बाइट में। ८ से भाग दें।
- सब कुछ अनुमान लगाना। संख्याओं के फैसला कर देने पर रुकें। चित्र सीडीएन पर जाएंगे, यह जानने के लिए कैश हिट दर नहीं चाहिए।
- मान्यताएं न बताना। बिना मान्यताओं वाला अनुमान जांचा या सुधारा नहीं जा सकता।
अभ्यास कैसे करें
रोज इस्तेमाल होने वाला कोई ऐप चुनें और पांच मिनट में उसकी लेखन क्वेरी, पठन क्वेरी और सालाना स्टोरेज का अनुमान लगाएं। फिर सार्वजनिक संख्याएं खोजें (इंजीनियरिंग ब्लॉग, नतीजों की घोषणाएं, वार्ताएं) और देखें कि आप कितने दूर थे। ऐसे दस अभ्यासों के बाद परिमाण के क्रम की आपकी समझ भरोसेमंद हो जाती है, और इंटरव्यू तथा डिजाइन समीक्षाएं यही कौशल परखती हैं।
जो बचा रह गया
मेरा अब तक का सबसे अच्छा अनुमान तीन गुना गलत था, और इससे कोई फर्क नहीं पड़ा, क्योंकि वह उस इकलौती बात पर सही था जिस पर उसे सही होना था: डेटाबेस समस्या नहीं बनने वाला था, चित्रों की बैंडविड्थ बनने वाली थी।
अनुमान बस इतना ही है। एक नैपकिन, दस की कुछ घातें, और किसी के डिब्बा बनाने से पहले यह कहने की हिम्मत कि "यह हिस्सा आसान है, वह नहीं।"
स्रोत
- जेफ डीन, बड़े वितरित सिस्टम बनाने से डिजाइन, सबक और सलाह (देरी की संख्याएं)
- कॉलिन स्कॉट: हर प्रोग्रामर को जानने लायक देरी की संख्याएं (साल के हिसाब से अपडेट)
- गूगल एसआरई पुस्तक: जोखिम अपनाना (उपलब्धता और त्रुटि बजट)
- बैकब्लेज: मिटाव कोड और स्टोरेज का अतिरिक्त खर्च
- इसी श्रृंखला में: शून्य से लाखों उपयोगकर्ताओं तक, सिस्टम डिजाइन इंटरव्यू का व्यावहारिक ढांचा, यूआरएल शॉर्टनर डिजाइन करें