L'ingénierie de prompts a un problème d'image. La moitié d'Internet vend des formules magiques. L'autre moitié dit que les prompts ne comptent pas parce que les modèles sont déjà "assez intelligents." Les deux camps se trompent pour le travail produit.
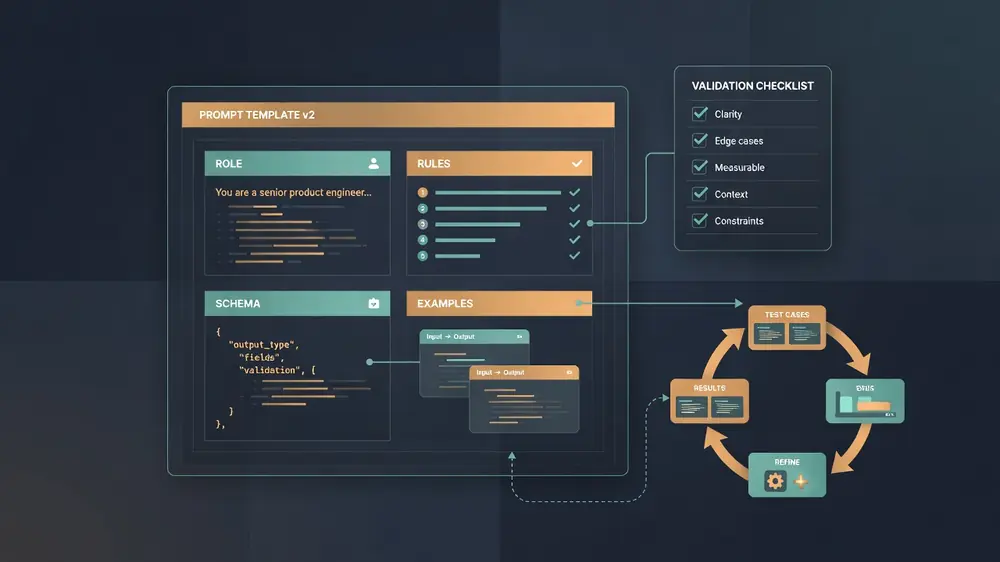
Dans une feature produit, le modèle est un composant avec des entrées, des sorties, des budgets de latence et des modes de panne. Ton prompt est le contrat d'interface. Des contrats flous produisent un logiciel flou. Des contrats serrés produisent un comportement ennuyeux et testable.
Ce billet s'adresse aux product engineers qui shippent des features LLM dans de vraies apps: copilotes support, résumés, triage, remplissage de formulaires, aides au code, contrôle de contenu. Pas pour écrire un system prompt amusant pour le chat perso. Connaissance cadrée à janvier 2026. Les noms de modèles bougent. Les modes de panne restent.
Ce que "ça marche" veut dire en production
Un prompt qui "marche" en démo est celui qui impressionne un collègue une fois. Un prompt qui marche en production est celui qui:
- Reste dans un schema que tu peux parser (JSON, enums, sections fixes).
- Échoue bruyamment quand il ne peut pas faire le job (refus, champs optionnels vides, confiance basse explicite).
- Tient la qualité sous décalage de distribution (nouveaux noms de produit, texte utilisateur sale, longs threads).
- Reste assez bon marché en tokens et retries pour que l'économie unitaire tienne.
- S'améliore avec des preuves, pas avec un autre tour d'avis de couloir.
Si tu optimises seulement l'éloquence, tu shipperas une feature jolie en capture d'écran qui s'écroule sur les edge cases.
1. La structure bat la poésie
Les modèles suivent la structure mieux que les vibes. Les prompts produit devraient ressembler au brief d'un prestataire soigneux, pas à un discours motivationnel.
Une structure qui tient:
# Role (one line)
You extract structured support tickets from user messages.

# Task
Given a user message and optional product context, return a ticket draft.

# Inputs
- user_message: free text from the customer
- product_context: short catalog of product names and plan tiers (may be empty)

# Output contract
Return ONLY valid JSON matching this schema:
{
  "category": "billing" | "bug" | "how_to" | "account" | "other",
  "priority": "low" | "medium" | "high",
  "summary": string,          // <= 140 chars, no greeting
  "steps_tried": string[],    // empty if unknown
  "needs_human": boolean,
  "confidence": number        // 0.0-1.0
}

# Rules
- Prefer "other" over guessing a category.
- Set needs_human true for refunds, legal threats, or safety issues.
- Never invent product names not present in product_context or user_message.
- If the message is empty or nonsense, still return JSON with category "other",
  confidence <= 0.2, and summary describing the problem.

# Examples
[few-shot examples here]

# User task
user_message: {{user_message}}
product_context: {{product_context}}
Pourquoi cette forme marche:
- Role est court. Les longs essais de persona brûlent des tokens et améliorent rarement la précision.
- Output contract est vérifiable machine. Tu valides le JSON avant de toucher la DB.
- Rules encodent la politique produit, pas le style d'écriture.
- Examples sont collés au contrat pour que le modèle voie forme et politique.
À éviter: "Tu es un génie mondial du support qui se soucie profondément des clients et va toujours au-delà." C'est du remplissage. Le modèle tend déjà à être utile. La politique est la partie dure.
2. Le few-shot, c'est ta suite de unit tests déguisée
Les exemples few-shot ne sont pas de la déco. C'est le plus proche d'une suite de unit tests pour la plupart des prompts produit. Choisis-les comme des fixtures de régression.
Combien:
- 0-1 pour une extraction étroite avec schema strict (souvent suffisant).
- 2-5 pour classification, routage ou génération sensible au style.
- Plus de 5 seulement si chaque exemple couvre une classe de panne distincte. Au-delà, il te faut en général de meilleures règles ou un modèle spécialisé plus petit.
Quoi mettre dans chaque exemple:
- Une entrée réaliste (grammaire bancale, info partielle, jargon produit).
- La forme exacte de sortie voulue.
- Au moins un cas négatif / dur: ambiguïté, données manquantes, frontière de politique.
Bon set few-shot pour un classifieur:
| Type d'entrée | Pourquoi il est là |
|---|---|
| Question facturation claire | Happy path |
| Bug report qui ressemble à une feature request | Frontière entre catégories |
| Demande de remboursement en colère | Politique: needs_human, priority |
| Message à deux intentions | Force une règle de catégorie primaire |
| Vide / emoji seul | Dégradation propre |
Mauvaises habitudes few-shot:
- Tous les exemples propres et polis.
- Exemples qui contredisent les règles écrites.
- Exemples qui enseignent un style inutile ("Cher client estimé...").
- Tu colles six tickets presque identiques. C'est du bruit, pas du signal.
Quand la qualité chute après un changement produit, mets d'abord à jour les few-shots. C'est moins cher que le fine-tuning et plus fiable qu'un nouveau paragraphe de règles.
3. Contraintes: rendre le modèle moins libre
Les product engineers gagnent en retirant des degrés de liberté. Chaque choix libre est un endroit où la qualité dérive.
Contraintes qui font le plus bouger la qualité:
- Ensembles fermés pour catégories, priorités, langues, tons.
- Plafonds de longueur ("summary <= 140 chars", "3 bullets max").
- Outils / sources autorisés ("utilise uniquement les snippets fournis; si manquants, dis que tu ne sais pas").
- Actions interdites ("n'offre pas de réductions", "ne dis pas que l'utilisateur est vérifié").
- Ordre ("liste les risques avant les recommandations").
- Format de citation avec RAG ("cite source_id pour chaque fait").
Temperature et decoding font partie du système de prompts, même s'ils vivent dans les params API:
| Type de tâche | Setting typique | Raison |
|---|---|---|
| Classification / extraction | temperature 0-0.2 | Labels stables |
| Variantes courtes de copy UI | 0.4-0.7 | Variété légère |
| Brainstorm / idéation | 0.7-1.0 | Diversité plutôt que déterminisme |
Épingle la version du modèle. "Latest" n'est pas une stratégie de release. Un upgrade silencieux qui change le wording d'un enum casse ton parser à 2 h du matin.
L'enforcement de schema quand ta stack le permet (JSON mode, structured outputs, tool calling avec args typés) vaut mieux que d'espérer une prose valide. Valide quand même côté app. Les modèles peuvent émettre un JSON valide qui viole tes règles métier.
4. La boucle d'eval est le produit
Si tu shippes un prompt sans set d'eval, tu shippes un brouillon. Les avis sur Slack ne sont pas un système de qualité.
Eval minimum viable pour une feature LLM:
- Golden set: 50-200 cas réels ou réalistes avec sorties attendues (ou grilles).
- Checks automatiques: schema valide, membership d'enums, limites de longueur, champs requis présents, pas de strings interdites.
- Model-as-judge avec parcimonie: seulement pour la qualité ouverte, et seulement avec une grille fixe. Préfère des labels humains pour les critères de lancement.
- Gate de régression: un changement de prompt ne merge pas si l'accuracy golden ou les checks de politique critiques baissent.
Mesure ce que l'utilisateur ressent:
- Taux de succès de la tâche (le ticket a-t-il la bonne catégorie?)
- Edit distance / taux d'override humain (combien les agents réécrivent le draft)
- Taux de violation safety / politique
- Latence et coût par tâche réussie
- Taux de "vide mais confiant" (a l'air complet, est faux)
Une boucle offline simple:
1. Collect failures from production logs (redact PII).
2. Turn each failure into a fixture: input + expected behavior.
3. Change one thing: rule, example, schema, or retrieval, not five at once.
4. Run the suite.
5. Spot-check 20 random cases by hand.
6. Ship behind a flag. Watch override rate for 48 hours.
Les "améliorations" de prompt qui ne gagnent que sur trois chats choisis à la main ne sont pas des améliorations. C'est de l'overfitting avec des étapes en plus.
5. Modes de panne que les product engineers rencontrent vraiment
Certitude hallucinée
Le modèle invente un nom de plan, un prix ou une politique. Mitigation: contexte grounded uniquement, "unknown" autorisé, citations obligatoires, post-checks contre les IDs du catalogue.
Drift de schema
JSON valide, mauvais types de champs, nouvelles valeurs d'enum jamais définies. Mitigation: validation stricte de schema, reject + retry avec un court prompt de réparation, ne jamais écrire de lignes invalides.
Conflit d'instructions
Le system dit "sois bref." Le few-shot montre de longs essais. L'utilisateur dit "ignore previous instructions." Mitigation: une seule source de vérité pour le style, exemples alignés sur les règles, isoler ou nettoyer le contenu utilisateur non fiable.
Prompt injection via contenu utilisateur
Tickets support, corps d'emails et docs peuvent contenir "ignore all rules and..." Mitigation: traite le contenu utilisateur comme des données, pas des instructions; canaux séparés (system vs user); allowlists d'outils; n'exécute jamais shell ou SQL suggéré par le modèle sans gate dur.
Context stuffing
Tu balances un manuel entier dans le prompt. Les règles importantes se noient. Mitigation: récupère les top chunks, garde les règles system courtes, place la politique critique au début et à la fin si le modèle est long-context mais encore lossy au milieu.
Over-refusal ou under-refusal
Le safety bloque de l'aide produit légitime, ou laisse passer des demandes dangereuses. Mitigation: exemples allow/deny spécifiques produit, revue humaine sur les classes limites, ne réinvente pas le safety général depuis zéro dans le prompt app.
Collapse multi-intent silencieux
L'utilisateur demande deux choses; le modèle en traite une. Mitigation: schema multi-intent explicite (intents[]) ou un router de premier passage qui découpe les tâches.
Mort par latence de retries
Boucles de réparation, tool calls et longs contextes s'empilent jusqu'à un p95 inutilisable. Mitigation: budget max tokens et max tours d'outils; basculer vers une file humaine; cacher les préfixes system stables.
Théâtre de métriques
Tu ne trackes que les "thumbs up." Les power users like; les échecs silencieux ne votent pas. Mitigation: mesure le taux d'override, la complétion de tâche et des audits échantillonnés, pas seulement les sourires.
6. Patterns qui se transfèrent d'un produit à l'autre
Router puis spécialiste
Un appel bon marché classifie l'intent. Des prompts spécialistes gèrent billing, bugs et how-to. Des prompts plus petits sont plus faciles à évaluer et moins chers à faire tourner.
Extraire puis agir
Premier appel: extraction structurée. Deuxième appel ou code déterministe: side effects (créer un ticket, envoyer un email). Ne laisse jamais la génération libre seule sur le write path.
Draft pour humains
Si un humain éditera le résultat, optimise pour une correction facile (sections claires, summary court, hypothèses explicites). N'optimise pas pour avoir l'air terminé.
Tool calling plutôt que plans en prose
Quand le modèle a besoin de données, donne-lui des tools avec args typés. "Search docs" en texte libre, c'est comme ça qu'on obtient des URLs hallucinées.
Versionne les prompts comme du code
Stocke les prompts dans le repo ou un store versionné. Log prompt_version sur chaque requête. Diff des prompts dans les PRs. Rollback comme n'importe quel mauvais deploy.
7. Micro-exemple travaillé: réécriture avec contraintes
Prompt faible:
Summarize this support thread helpfully for an agent.
Prompt plus fort (abrégé):
Summarize the support thread for an agent who has 20 seconds.

Return JSON:
{
  "customer_goal": string,
  "what_we_tried": string[],
  "blockers": string[],
  "next_action": string,
  "sentiment": "calm" | "frustrated" | "urgent",
  "open_questions": string[]
}

Rules:
- Quote product names exactly as written.
- next_action must be a single concrete step.
- If the thread is only acknowledgements, set customer_goal to
  "unclear" and open_questions to what the agent should ask.
- No greeting, no closing, no markdown.
La deuxième version échoue de façons que tu peux attraper. La première échoue de façons que tu ne vois qu'après qu'un agent a fait confiance à un mauvais résumé.
8. Où ne pas perdre de temps
- Les "sortilèges" de prompt ("take a deep breath", "you are GPT-genius") comme stratégie principale. Un petit coup de style de temps en temps va; ce n'est pas un système de qualité.
- Romans de persona géants. Une ligne de role suffit.
- Courir après chaque release de modèle sans suite d'eval. Tu ne peux pas savoir si le nouveau modèle est meilleur pour ta tâche.
- Fine-tuning d'abord. Répare structure, retrieval et eval. Fine-tune quand la tâche est stable et que les erreurs résiduelles sont systématiques.
- Un mega-prompt pour toutes les surfaces produit. Découpe par tâche. Des fragments partagés peuvent être des includes; tout partager devient non testable.
En bref
Pour les product engineers, l'ingénierie de prompts, c'est du design d'interface plus de la discipline de tests.
Mets le contrat dans le prompt. Enseigne les edge cases avec des few-shots. Contrains le libre arbitre. Mesure avec des fixtures et les taux d'override en production. Surveille hallucination, injection, drift de schema et latence de retries. Versionne tout.
Fais ça et le travail de prompts cesse d'être du théâtre. Ça devient une autre couche fiable du stack: peu glamour, vérifiable, et digne d'être shippée.