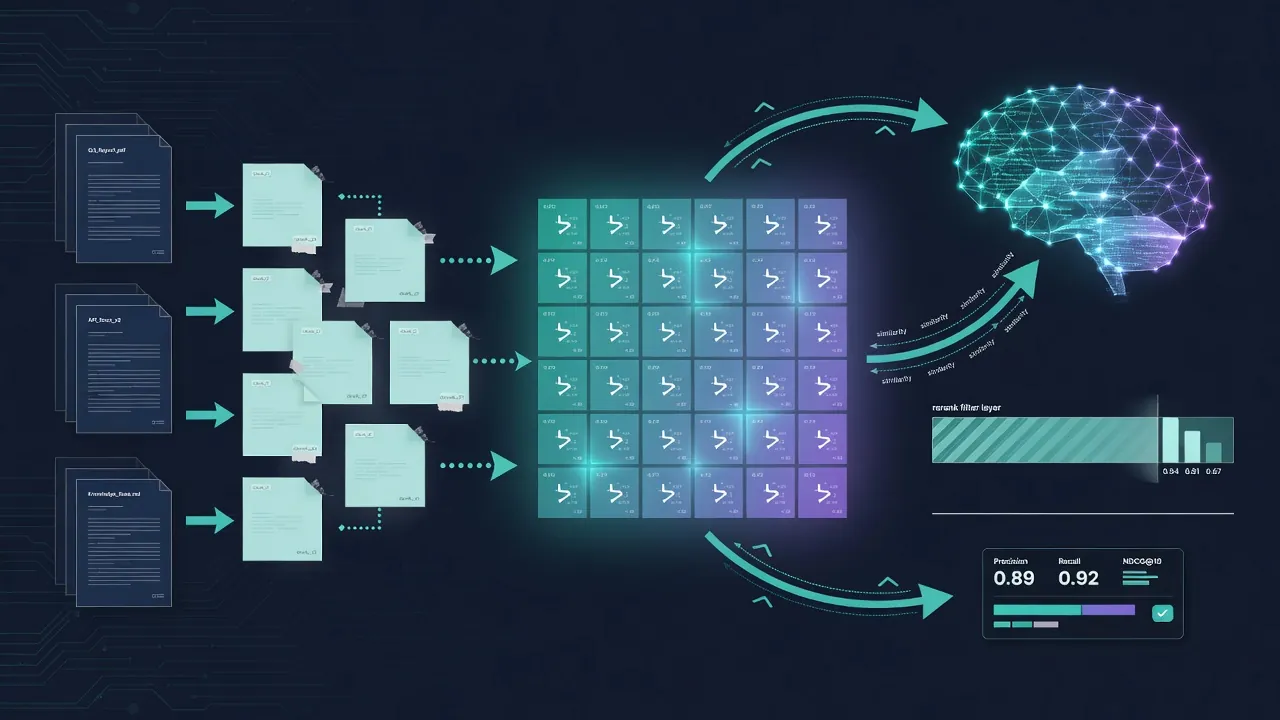
La génération augmentée par récupération (RAG) paraît simple sur une slide : embarquer les docs, stocker des vecteurs, récupérer le top-k, remplir le prompt, générer. En production, ce pipeline fuit de la qualité à chaque étape. Cet article est un parcours concret d'un stack RAG pragmatique, des décisions qui changent vraiment le résultat, et des cas où le RAG est le mauvais outil.
Le contenu est cadré début 2026. Les noms d'outils changent ; les modes de panne, presque pas.
Ce que vous construisez vraiment
Un modèle mental utile a cinq étapes :
- Ingérer et découper (chunk) le corpus en unités exploitables par le modèle.
- Embarquer (embed) ces unités dans un espace vectoriel (et souvent garder aussi un index mots-clés).
- Récupérer des candidats pour une requête (dense, sparse ou hybride).
- Réordonner (rerank) ces candidats avec un modèle plus fort et plus lent.
- Générer, puis évaluer les réponses face à une vérité terrain pour améliorer la boucle.
Sans évaluation, vous réglez au feeling. Sans reranking ni recherche hybride, vous sur-attribuez au modèle d'embeddings des problèmes qu'il ne peut pas corriger.
Documents -> Chunker -> Embedder -> Store vectoriel (+ BM25)
                              ^
Requête utilisateur ----------+--> Retrieve hybride -> Rerank -> Prompt + LLM -> Réponse
                                                              |
                                                         Harness d'eval (offline)
Étape 1 : Chunking (là où la qualité se perd tôt)
Les embeddings ne "comprennent" pas les documents. Ils scorent la similarité sur l'unité stockée. De mauvaises frontières de chunk donnent une mauvaise récupération, quel que soit le modèle.
Defaults pratiques
| Stratégie | Taille typique | Quand ça marche | Échec fréquent |
|---|---|---|---|
| Tokens fixes avec chevauchement | 256-512 tokens, 10-20% overlap | Prose uniforme, politiques, wikis | Coupe tables, code ou procédures au milieu |
| Sensible à la structure (titres, sections) | Section plafonnée | Markdown, sites de docs, manuels | Grosses sections nécessitent encore un second découpage |
| Splitters sémantiques / récursifs | Variable | Corpus mixtes | Plus durs à debugger ; dérive si le splitter change |
| Parent-enfant (retrieve petit, contexte large) | Enfant ~128-256, parent ~1k+ | Manuels longs | Plus de complexité d'index et de stockage |
Règles qui tiennent en pratique :
- Préférez la structure aux fenêtres de tokens pures quand la source a des titres.
- Gardez une idée par chunk quand c'est possible. Procédures et exemples d'API ne doivent pas être coupés au milieu.
- Stockez des métadonnées riches : chemin source, titre, section, version produit, langue, dernière mise à jour, ACL d'accès.
- L'overlap aide la continuité, mais 50% d'overlap brûle surtout du stockage et complique le dedup.
- Pour les tableaux, stockez un chunk résumé en prose et gardez le tableau structuré si les réponses dépendent de chiffres exacts.
Esquisse d'exemple (style Python, indépendant de lib) :
def chunk_markdown(md: str, max_tokens: int = 400, overlap: int = 40):
    sections = split_on_headings(md)  # garder les frontières # / ##
    chunks = []
    for section in sections:
        if token_len(section) <= max_tokens:
            chunks.append(section)
        else:
            chunks.extend(sliding_window(section, max_tokens, overlap))
    return chunks
Si la récupération est faible, re-chunking avant de changer de modèle d'embeddings. Ce correctif est moins cher et plus souvent le bon.
Étape 2 : Embeddings
Votre modèle d'embeddings définit la géométrie de la recherche. En 2025-2026, modèles open multilingues et APIs commerciales solides fonctionnent tous les deux ; le choix porte sur latence, coût, couverture linguistique et sortie possible des données hors VPC.
Checklist de sélection
- Dimension et coût : plus de dims n'est pas gratuit à l'échelle (stockage + mémoire ANN).
- Longueur max d'entrée : si les chunks font 512 tokens, un embedder à 256 tronque en silence.
- Domaine : juridique, médical et code ont souvent besoin d'embeddings affinés au domaine.
- Version épinglée : jamais "latest" en production. Ré-embarquer un corpus entier est une migration.
- Même modèle pour requête et document, sauf paire asymétrique entraînée ainsi.
Astuces d'index :
- Utilisez HNSW ou un équivalent managé pour la plupart des corpus à l'échelle applicative.
- Normalisez les vecteurs si vous utilisez la similarité cosinus (beaucoup de clients le font pour vous).
- Gardez le texte brut à côté du vecteur. Il servira aux prompts, citations et réindexation.
# Pseudocode : embed et upsert
vectors = embed_model.encode(chunk_texts, normalize=True)
store.upsert([
    {"id": ids[i], "vector": vectors[i], "text": chunk_texts[i], "meta": metas[i]}
    for i in range(len(ids))
])
Étape 3 : Retrieval (le dense seul ne suffit pas)
La recherche vectorielle pure échoue sur les identifiants exacts : codes d'erreur, SKU, noms de fonction, numéros de facture, IDs de politique. La recherche pure mots-clés échoue sur la paraphrase. Le retrieval hybride est le défaut pour les apps sérieuses.
Un motif hybride solide
- Recherche dense (top 30-50).
- Recherche BM25 / sparse (top 30-50).
- Fusion avec Reciprocal Rank Fusion (RRF) ou fusion de scores pondérée.
- Dédupliquer les chunks quasi identiques (même source + fort chevauchement de texte).
- Passer la shortlist fusionnée au reranker.
def rrf(rank_lists, k=60):
    scores = {}
    for ranks in rank_lists:
        for rank, doc_id in enumerate(ranks, start=1):
            scores[doc_id] = scores.get(doc_id, 0.0) + 1.0 / (k + rank)
    return sorted(scores, key=scores.get, reverse=True)
Améliorations côté requête qui comptent
- Réécriture de requête : développer les acronymes, ajouter les noms produit du contexte de session.
- Multi-query : générer 2-4 paraphrases, récupérer pour chacune, fusionner.
- Filtres d'abord : appliquer ACL, tenant, langue et version avant ou dans l'ANN, pas après la génération.
- HyDE (embeddings de documents hypothétiques) peut aider sur des corpus clairsemés ; mesurez, ne supposez pas.
Si les utilisateurs posent des questions multi-hop ("compare le prix du plan A et B après le changement 2024"), le top-k en un coup échoue souvent. Il faut un retrieval multi-étapes ou une couche graphe/structurée. C'est une décision produit, pas un tweak de prompt.
Étape 4 : Reranking
Les bi-encodeurs (embarquer requête et doc séparément) sont rapides et approximatifs. Un reranker cross-encoder lit requête et document ensemble et réordonne en général la shortlist bien plus précisément.
Motif typique :
- Récupérer 30-50 candidats à bas coût.
- Reranker vers le top 5-10 pour le prompt.
- Budgéter la latence : les rerankers coûtent plus ; cachez par (hash de requête, id doc) quand le trafic se répète.
pairs = [(query, doc["text"]) for doc in candidates]
scores = reranker.predict(pairs)
top = [doc for _, doc in sorted(zip(scores, candidates), reverse=True)[:8]]
Quand le reranking aide le plus : politiques proches, manuels quasi-doublons, bruit de "presque la bonne section". Quand non : corpus vide ou faux, mauvais chunking, ou questions qui demandent du calcul plutôt que des citations.
Étape 5 : Prompt de génération (ennuyeux et strict)
Le générateur doit être contraint :
- Répondre uniquement à partir du contexte fourni.
- Citer les ids de chunk ou chemins source.
- Dire je ne sais pas quand le contexte est insuffisant.
- Préférer des citations extractives pour les chiffres et le langage juridique.
Esquisse :
Tu es un assistant support. Utilise UNIQUEMENT les blocs CONTEXTE.
Si la réponse n'est pas dans CONTEXTE, dis que tu ne sais pas.
Cite les sources en [n] selon le numéro de bloc.

QUESTION : {question}

CONTEXTE :
[1] {chunk_1}
[2] {chunk_2}
...
Température basse pour les bots support factuels. N'empilez pas 20 longs chunks : vous payez en coût, latence et erreurs lost-in-the-middle. Après rerank, 4-8 chunks ciblés battent 20 médiocres.
Étape 6 : Évaluation (sans ça, vous devinez)
L'eval offline permet de comparer tailles de chunks, modèles et prompts sans livrer de régressions aux utilisateurs.
Construire un petit golden set
Commencez avec 50-200 vraies questions issues de tickets, logs de recherche ou experts. Pour chaque item stockez :
- question
- réponse attendue (ou faits clés)
- ids de docs / chunks pertinents (labels)
- optionnel : hard negatives
Métriques alignées sur les étapes du pipeline
| Étape | Métrique | Ce qu'elle dit |
|---|---|---|
| Retrieval | Recall@k, MRR, nDCG | Le bon chunk est-il entré dans la shortlist ? |
| Rerank | nDCG / MRR après rerank | L'ordre s'est-il amélioré ? |
| Génération | Faithfulness / groundedness | Le modèle a-t-il inventé des faits ? |
| Génération | Pertinence de la réponse | A-t-il traité la question ? |
| Bout en bout | Exact match / F1 / LLM-as-judge avec grilles | Qualité globale |
Boucle pratique :
- Corrigez d'abord le recall (chunking, hybride, filtres).
- Puis la précision au prompt (rerank, moins de chunks meilleurs).
- Puis resserrez la génération (prompt, citations, refus).
- Relancez la suite à chaque changement de chunker, version d'embedder ou system prompt.
Les signaux online comptent encore : thumbs down, escalade humaine, clics sur citations, tags "pas utile". Les golden sets offline dérivent ; rafraîchissez-les chaque trimestre.
Architecture de référence minimale
Pour un bot de connaissance interne de taille moyenne (dizaines de milliers de pages) :
| Composant | Choix pragmatique |
|---|---|
| Ingest | Crawler planifié + webhook sur mises à jour de docs |
| Chunk | Markdown/HTML structure-aware, 300-500 tokens, métadonnées riches |
| Embed | Un modèle multilingue épinglé ; re-embed batch aux changements de version |
| Store | Postgres + pgvector ou un vector DB managé ; BM25 dans le même système ou OpenSearch |
| Retrieve | Hybride + filtres de métadonnées + RRF |
| Rerank | Cross-encoder ou API reranker sur le top 40 |
| LLM | Celui que vous faites déjà confiance pour latence/coût ; basse température |
| Eval | Golden set en CI ; bloquer les deploys sur régression recall@10 |
| Observabilité | Log query, ids récupérés, scores, citations finales, détail de latence |
Vous n'avez pas besoin de cinq frameworks d'agents. Un pipeline ennuyeux avec bon chunking et eval bat un graphe d'agents malin sur un index en désordre.
Quand le RAG échoue (soyez honnête avec les parties prenantes)
Le RAG n'est pas une couche d'intelligence générale. Il échoue de façon prévisible :
1. La réponse n'est pas dans le corpus
Aucun tour de retrieval n'invente une politique absente. Mesurez la couverture. Si le support demande le produit X et que la doc ne couvre que Y, le bon comportement est le refus, pas une réponse confiante inventée.
2. La question exige de raisonner sur beaucoup de faits
Multi-hop, comparaison temporelle et "résume tout ce qu'on sait" étirent le RAG en un coup. Il peut falloir du retrieval multi-étapes, des données structurées ou un flux humain.
3. Exactitude et arithmétique
Totaux de facture, calculs de dosage et maths de SLA appartiennent aux outils ou bases de données, pas à "espérons le bon paragraphe". Couplez le RAG à des calculateurs et du SQL quand les chiffres comptent.
4. Sources conflictuelles ou périmées
Deux versions d'une politique dans l'index produisent des bascules. Filtres de version, règles de supersession et métadonnées de fraîcheur sont des features produit, pas des options décoratives.
5. Erreurs de contrôle d'accès
Récupérer un doc que l'utilisateur ne doit pas voir est un bug de sécurité. Appliquez les ACL au moment du retrieval. Ne comptez pas sur le LLM pour "ne pas mentionner" un texte restreint déjà présent dans le prompt.
6. Théâtre d'évaluation
Les démos leaderboard sur questions triées cachent la douleur production. Si vous ne pouvez pas montrer le recall@k sur un échantillon réel de requêtes, vous ne savez pas si le système marche.
7. Quand fine-tuning ou recherche simple est mieux
- Tâches de style/ton stables : fine-tuning ou bon prompting peuvent battre la retrieval.
- Lookup d'item connu ("ouvre le ticket #1842") : mots-clés et recherche structurée gagnent.
- Données personnelles très dynamiques : interrogez le système d'enregistrement ; ne les figez pas en vecteurs chaque jour sauf obligation.
Ordre de build court si vous démarrez cette semaine
- Définir le job : FAQ support, Q&A wiki interne, docs de code. Borner le corpus.
- Collecter 50 vraies questions et labelliser les docs pertinents.
- Livrer un hybrid retrieve ennuyeux + prompt simple avec citations et refus.
- Mesurer recall@10 et faithfulness sur ce set.
- Ajouter le reranking seulement quand le recall de retrieval est correct.
- Automatiser ingest et réindex sur changements de docs.
- Mettre l'eval en CI avant de polir l'UI.
La plupart des équipes inversent cet ordre : UI et démos d'agents d'abord, qualité de retrieval en dernier. Les utilisateurs le ressentent immédiatement.
Conclusion
Un pipeline RAG pratique, c'est surtout de la recherche d'information avec un LLM au bout. Chunker pour coller à la façon dont les gens demandent. Embarquer avec un modèle épinglé. Récupérer en hybride. Réordonner la shortlist. Générer sous règles strictes de grounding. Évaluer chaque changement.
Quand le corpus est incomplet, la question est multi-hop ou la tâche est purement calculatoire, dites-le et construisez le bon composant. Le RAG est puissant dans sa voie. Hors de cette voie, c'est une façon fluide de se tromper.