TL;DR
- Le problème : Télécharger un milliard de pages par mois depuis des millions de sites indépendants, sans en surcharger aucun, sans récupérer deux fois la même chose, sans se perdre dans des espaces d'URL infinis, tout en revisitant les pages qui changent.
- La conception : Une boucle frontière, téléchargement, stockage, analyse, filtrage, déduplication, puis retour à la frontière. La frontière place des files de priorité devant et une file par hôte derrière, régulées par un tas de « prochaine heure de visite autorisée », si bien que la politesse est garantie par construction. La vérification des URL déjà vues utilise un filtre de Bloom adossé à un magasin clé-valeur ; le contenu quasi dupliqué est repéré par SimHash.
- Le résultat : Environ 400 pages par seconde en régime continu avec une flotte modeste, chaque hôte contacté au plus une fois toutes les quelques secondes, et un effort d'exploration consacré aux pages nouvelles, importantes ou susceptibles d'avoir changé.
Un robot d'exploration ressemble au programme le plus simple de cette série : télécharger une page, trouver ses liens, télécharger ceux-là. Écrire cette boucle prend dix minutes. La faire tourner sur le vrai web pendant une semaine vous apprend tout le reste : des serveurs qui ralentissent quand vous êtes impoli, des calendriers aux liens « mois suivant » sans fin, un million de pages qui sont la même page avec des identifiants de session différents, et des propriétaires de sites qui vous écrivent.
Cet article conçoit un robot généraliste, du genre qui alimente un index de recherche ou un grand corpus de recherche comme Common Crawl.
Exigences et chiffres
Fonctionnelles : partir d'URL de départ, découvrir et télécharger des pages HTML, stocker le contenu brut, extraire les liens, respecter robots.txt, revisiter les pages au fil du temps.
Non fonctionnelles : politesse (ne jamais surcharger un site), robustesse face au HTML mal formé et aux espaces d'URL hostiles, passage à des milliards de pages, extensibilité vers de nouveaux types de contenu.
| Hypothèse | Valeur | Conséquence |
|---|---|---|
| Pages par mois | 1 milliard | ~385 pages/s en moyenne |
| Page HTML moyenne | ~100 Ko | ~100 To/mois bruts, quelques dizaines de To compressés |
| Durée moyenne d'un téléchargement | ~500 ms | ~200 téléchargements simultanés suffisent ; prévoir des milliers pour la marge |
| Liens par page | ~50 | ~20 000 nouvelles URL candidates par seconde avant déduplication |
| URL vues en un an | Des dizaines de milliards | L'ensemble des URL vues ne tient pas naïvement dans la mémoire d'une machine |
Les chiffres intéressants ne concernent pas la bande passante. Ce sont les 20 000 URL candidates par seconde qui exigent une réponse à « l'ai-je déjà vue ? », et les millions d'hôtes qui ont chacun besoin de leur propre limite de rythme.
Le pipeline
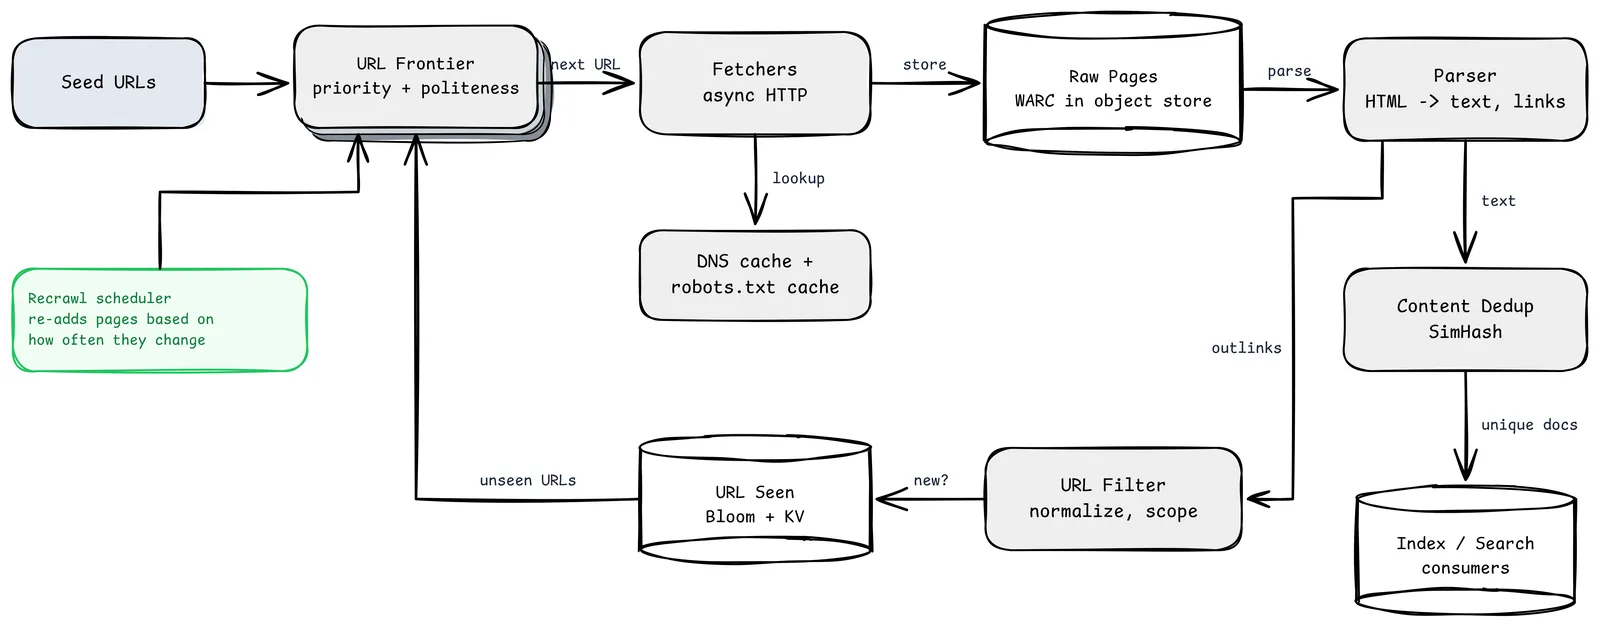
- Seed URLs. Un ensemble de départ de sites connus et de qualité. Leur qualité façonne toute l'exploration.
- URL Frontier. La liste de tâches. Elle décide à la fois quoi télécharger ensuite (priorité) et quand chaque hôte peut être contacté (politesse). C'est le cœur de la conception, avec son propre schéma plus bas.
- Fetchers (HTTP asynchrone). Des milliers de connexions simultanées depuis une poignée de machines grâce aux E/S non bloquantes. Délais d'expiration, limites de taille et de redirections sur chaque requête. Identifiez-vous avec un user agent clair et une URL de contact.
- Cache DNS + cache robots.txt. Les résolutions DNS peuvent vite devenir le goulot d'étranglement à des centaines de téléchargements par seconde : mettez-les en cache agressivement. Récupérez le
robots.txtde chaque hôte une fois, gardez-le environ un jour, et vérifiez chaque URL avant de la télécharger. La RFC 9309 (2022) a enfin normalisé le protocole d'exclusion des robots. - Raw Pages (WARC dans un stockage objet). Stockez exactement ce que vous avez téléchargé, en-têtes compris, dans des fichiers WARC (le format d'archivage utilisé par Common Crawl et Internet Archive). L'analyse peut être refaite plus tard ; le téléchargement, non.
- Parser. Transforme le HTML en texte et en liens, résout les URL relatives et survit au balisage cassé.
- Content Dedup (SimHash). De nombreuses URL servent un contenu identique ou presque (miroirs, versions imprimables, paramètres de suivi). Une empreinte SimHash sur 64 bits permet de repérer les quasi-doublons en comparant la distance de Hamming ; Google a décrit exactement cela dans son article de 2007 sur l'exploration.
- URL Filter. Normalise les URL (hôte en minuscules, suppression des ports par défaut et des fragments, paramètres de suivi triés ou supprimés), applique les règles de périmètre et bloque les pièges connus.
- URL Seen (Bloom + KV). Un filtre de Bloom répond « certainement pas vue » en mémoire ; les « peut-être » sont confirmés dans un magasin clé-valeur persistant indexé par un hachage de l'URL normalisée.
- Consommateurs index et recherche. Les documents uniques partent vers ce qui exploite l'exploration.
- Planificateur de nouvelle exploration. Remet les URL connues dans la frontière selon leur fréquence de changement.
La frontière : priorité devant, politesse derrière
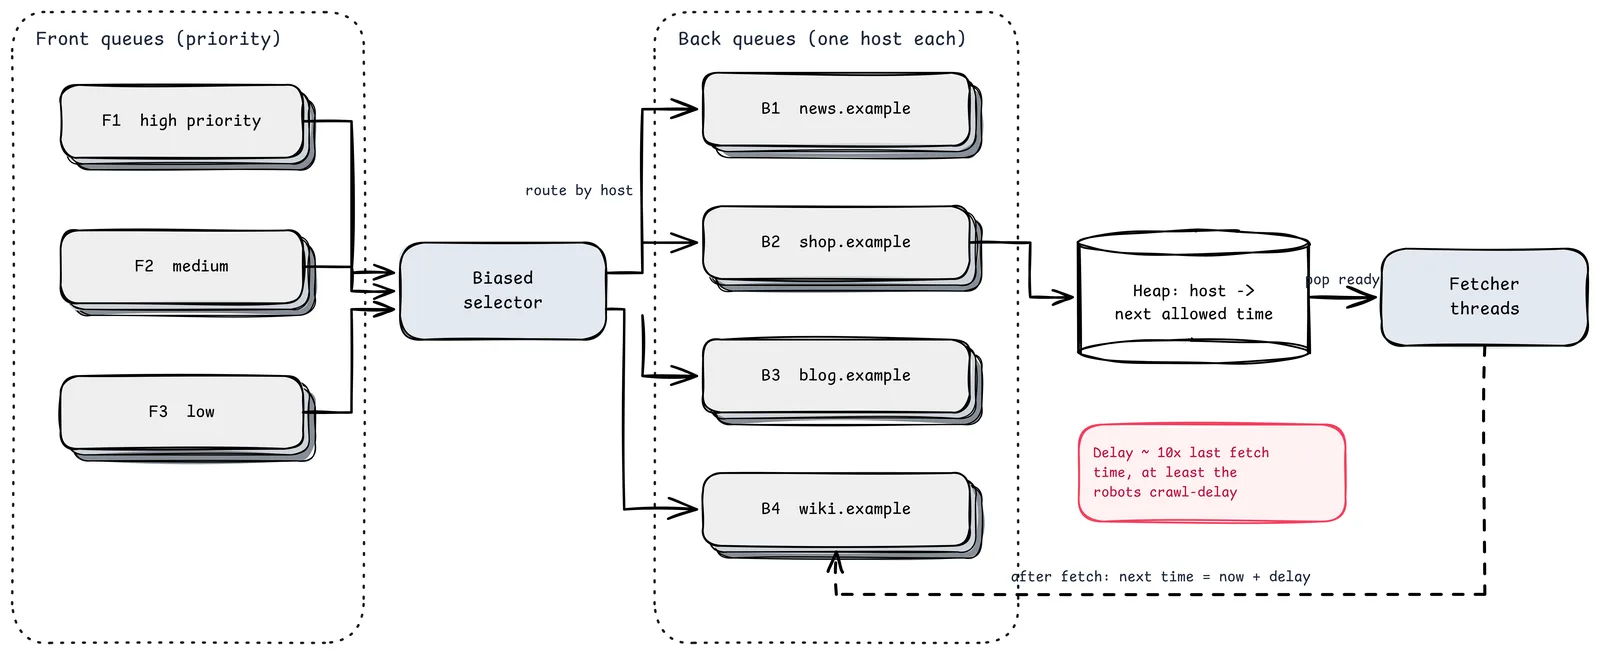
Cette conception en deux étages vient du robot Mercator (Heydon et Najork, 1999) et reste la réponse de référence :
- Les files avant contiennent les URL par priorité. La priorité peut venir d'une importance de type PageRank, d'un besoin de fraîcheur ou simplement de la qualité du domaine.
- Un sélecteur biaisé puise dans les files avant en favorisant la haute priorité, sans affamer complètement la basse.
- Les URL sont orientées vers des files arrière, avec exactement un hôte par file arrière. Toutes les URL de
news.exampleattendent dans la même file. - Un tas contient une entrée par file arrière : le premier instant où cet hôte peut être recontacté.
- Les threads de téléchargement retirent l'hôte dont l'heure est venue, téléchargent une URL de sa file, puis le replacent avec une nouvelle heure : maintenant plus un délai, souvent un multiple (par exemple 10 fois) de la durée du dernier téléchargement, et jamais moins que le crawl-delay demandé par le site.
La note rouge résume toute la politique de politesse en une ligne. Un serveur lent obtient automatiquement plus de répit, puisque ses téléchargements durent plus longtemps et que son délai augmente.
Répartir la frontière sur plusieurs machines devient simple avec cette structure : partitionnez par hôte (hachage du nom d'hôte), pour que la file arrière et l'état de politesse de chaque hôte vivent sur une seule machine.
Pièges et autres territoires hostiles
| Piège | Exemple | Défense |
|---|---|---|
| Espaces d'URL infinis | Calendrier aux liens « mois suivant » sans fin | Profondeur et longueur d'URL maximales ; budget de pages par hôte |
| Identifiants de session et paramètres de suivi | ?sid=abc123 rend chaque URL unique |
Règles de normalisation ; apprentissage des paramètres par hôte |
| Faux 404 | Pages « introuvable » servies avec le statut 200 | La déduplication de contenu repère le gabarit répété |
| Réponses énormes ou binaires | Un fichier de 2 Go derrière une URL qui ressemble à du HTML | Vérification du type de contenu, plafonds de taille, streaming avec arrêt anticipé |
| Serveurs au goutte-à-goutte | Des réponses qui livrent un octet par seconde | Délais sur la durée totale, pas seulement sur la connexion |
| Spam et fermes de liens | Des millions de pages générées automatiquement | Signaux de qualité dans la priorité ; budgets par domaine |
Le budget de pages par hôte est la défense la plus efficace à elle seule. Aucun site ne reçoit plus que sa part, quel que soit le nombre de liens qu'il génère.
La nouvelle exploration : la fraîcheur est un budget
Les pages changent à des rythmes très différents. La une d'un journal change toutes les quelques minutes ; un article archivé ne change jamais. Tout retélécharger selon un cycle fixe gaspille l'essentiel du budget.
- Conservez l'historique des changements par URL (le SimHash a-t-il changé depuis la dernière visite ?).
- Estimez un taux de changement et programmez la visite suivante en proportion, entre un intervalle minimal et un maximal.
- Utilisez des requêtes conditionnelles (
If-Modified-Since,If-None-Match) pour qu'une page inchangée coûte un304plutôt qu'un téléchargement complet. - Donnez des intervalles plus courts aux pages importantes ; laissez vieillir la longue traîne.
- Exploitez les sitemaps quand les sites en proposent, car ils indiquent souvent des dates de dernière modification.
Être un bon citoyen
- Respectez
robots.txt, y compris les règles d'exclusion pour votre user agent et tout crawl-delay. - Identifiez le robot dans le user agent avec une URL qui explique ce qu'il est et comment s'en exclure.
- Publiez les plages d'adresses IP depuis lesquelles vous explorez, pour que les exploitants puissent vous vérifier.
- Reculez sur
429et503, et respectezRetry-After. - Fournissez une adresse de contact, et lisez-la vraiment.
La tolérance du web envers les robots est un bien commun. Chaque robot mal élevé pousse les exploitants à bloquer plus agressivement tous les autres.
Liste de contrôle pour la production
- La frontière impose un hôte par file arrière avec un tas des prochaines heures autorisées
- robots.txt récupéré, mis en cache et vérifié avant chaque URL ; sémantique de la RFC 9309
- DNS en cache ; délais par requête sur la connexion, le premier octet et la durée totale
- Règles de normalisation et de périmètre des URL versionnées et testées
- Vérification des URL vues par filtre de Bloom et magasin persistant
- Détection des quasi-doublons par SimHash ou équivalent
- Budgets de pages par hôte et par domaine ; limites de profondeur et de longueur d'URL
- Réponses brutes stockées en WARC avant l'analyse
- Nouvelle exploration planifiée selon le taux de changement observé ; requêtes conditionnelles
- Tableaux de bord : pages/s, taux d'erreur par classe, hôtes en attente, taille de la frontière, taux de doublons
Ce qui reste
Un robot d'exploration est un invité dans des millions de maisons à la fois. L'ingénierie parle de vitesse, mais la réputation parle de manières : frapper, attendre, ne pas revenir trop souvent, partir quand on vous le demande.
Quelque part, un petit blog sur un serveur bon marché reçoit la visite de votre robot tous les quelques jours. Il ne connaîtra jamais votre nom. Il ne devrait jamais non plus remarquer votre passage.
Sources
- Heydon et Najork, « Mercator: A Scalable, Extensible Web Crawler » (1999)
- Manku, Jain et Das Sarma, « Detecting Near-Duplicates for Web Crawling » (WWW 2007)
- RFC 9309 : Robots Exclusion Protocol
- Common Crawl : présentation et données WARC
- ISO 28500 : format de fichier WARC (description de la Bibliothèque du Congrès)
- Dans la même série : Concevoir l'autocomplétion de recherche, Estimations au dos de l'enveloppe, Comment fonctionne le DNS