TL;DR
- Le problème : Un raccourcisseur, ce sont deux chemins aux profils très différents : un chemin de création rare et orienté écriture, et un chemin de lecture jusqu'à 100 fois plus chaud, sensible à la latence, et le seul que les utilisateurs remarquent vraiment.
- La conception : Générer les identifiants à partir de blocs loués d'un million, les brouiller avec un réseau de Feistel, les encoder en 7 caractères Base62, stocker
code -> urldans un magasin partitionné par code, et servir les redirections depuis le CDN et Redis, la base de données ne servant qu'en cas d'échec de cache. L'analytique des clics quitte le chemin chaud via une file.- Le résultat : Une écriture en base par million de liens pour l'allocation des identifiants, un p99 de redirection sous 20 ms en périphérie, une analytique qui peut prendre du retard ou perdre des événements sans jamais ralentir une redirection, et une réponse claire pour chaque mode de défaillance.
Toutes les listes d'entretiens de conception de systèmes placent le raccourcisseur d'URL en tête, et la plupart des articles le traitent comme un échauffement. Ce n'en est pas un. C'est l'un des exemples les plus nets d'un système où le chemin de lecture et le chemin d'écriture méritent des architectures différentes, et où de petites décisions (quel code de redirection, où vit un compteur) déterminent si le système survit à un lien qui devient viral.
Cet article le conçoit comme je le ferais pour la production, puis indique ce qui change en entretien.
Les exigences et les chiffres qui les façonnent
Fonctionnelles
POST /linksreçoit une URL longue et renvoie une URL courte. Alias personnalisé et expiration optionnels.GET /{code}redirige vers l'URL longue, ou renvoie 404 si le code est inconnu, expiré ou retiré.- Les propriétaires voient le nombre de clics. Une valeur approximative et légèrement différée est acceptable.
Non fonctionnelles
- Les redirections doivent être rapides et très disponibles. Un lien court cassé est visible par tous ceux qui cliquent.
- Une fois que la création a renvoyé
201, la correspondance ne doit jamais être perdue. L'utilisateur a déjà collé le lien quelque part. - Les codes ne doivent pas être énumérables trivialement.
Calcul au dos de l'enveloppe
| Hypothèse | Valeur | Conséquence |
|---|---|---|
| Nouveaux liens par mois | 100 M | ~40 écritures/s en moyenne, ~400/s lors d'un pic à 10x |
| Rapport lecture:écriture | 100:1 | ~4 000 redirections/s en moyenne, ~40 000/s en pic |
| Taille d'une ligne (code, URL, propriétaire, dates, statut) | ~500 octets | ~50 Go/mois, ~3 To sur 5 ans |
| Ensemble chaud | ~20 % des liens reçoivent ~80 % des clics | Quelques Go de code -> url tiennent largement dans Redis |
| Espace de codes à 7 caractères Base62 | 62^7 ≈ 3 500 milliards | Des siècles de marge à 100 M par mois |
Deux constats sautent aux yeux. Le stockage n'est pas la partie difficile : 3 To, c'est une base modeste. Et le chemin de redirection est bien plus un problème de cache qu'un problème de base de données.
L'architecture
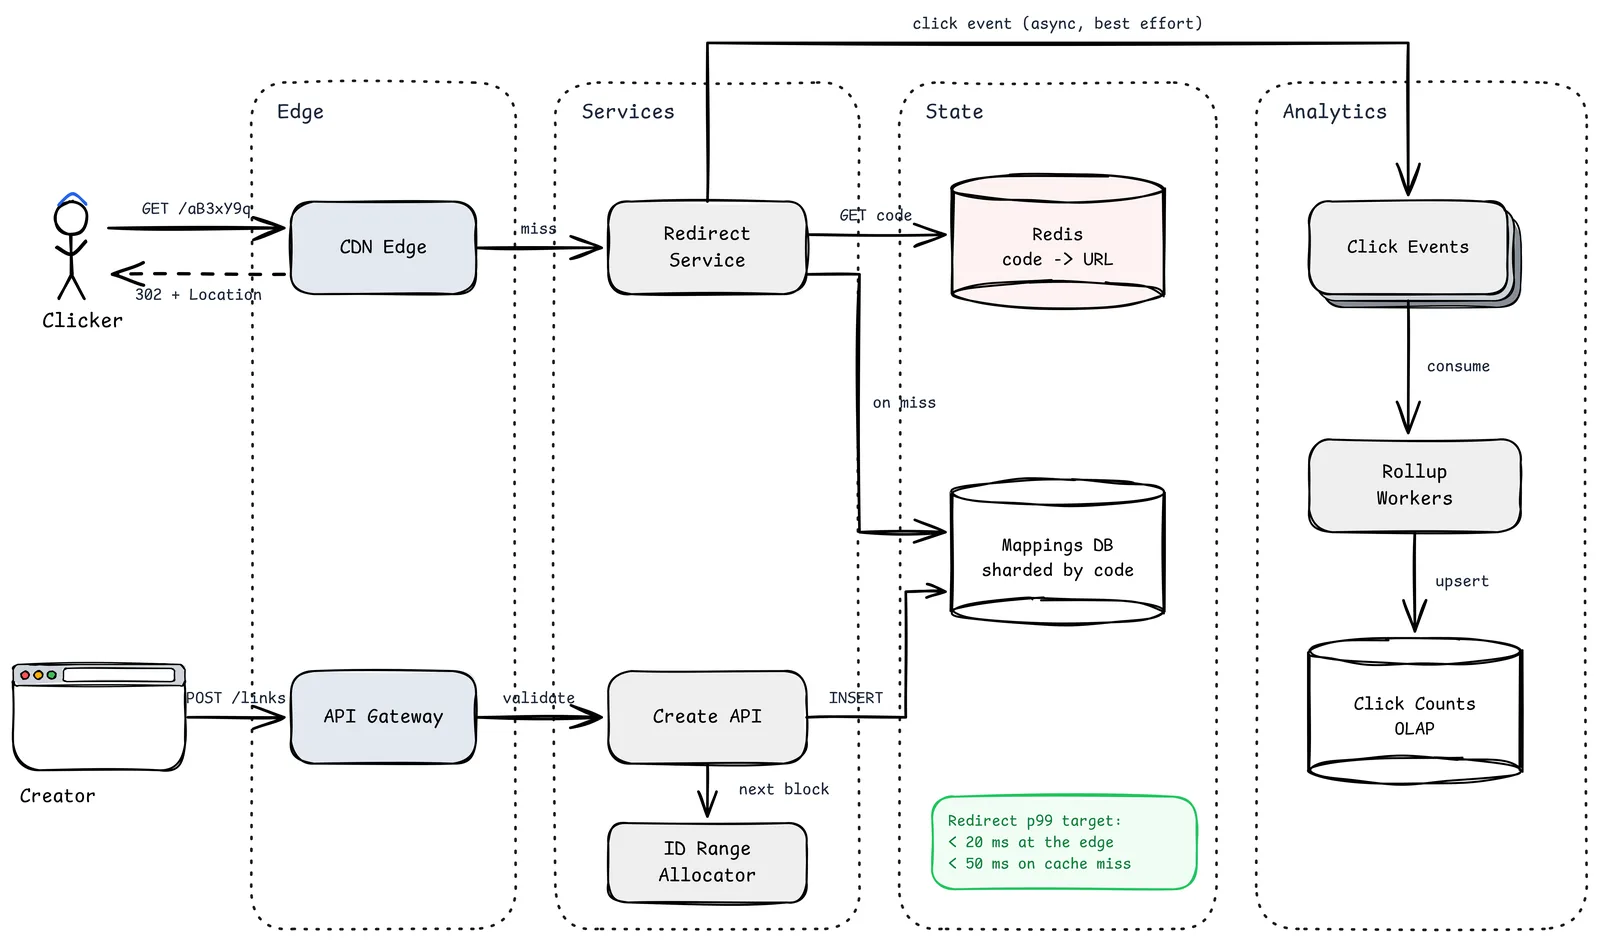
Parcourez-la de gauche à droite.
- Celui qui clique / celui qui crée. Deux clients très différents. Ceux qui cliquent sont anonymes, mondiaux et impatients. Ceux qui créent sont des utilisateurs authentifiés ou des intégrations d'API, bien moins nombreux.
- CDN Edge. Termine le TLS près de l'utilisateur et peut mettre en cache les réponses de redirection des codes populaires. Pour un lien viral, la plupart des clics ne devraient jamais atteindre votre origine.
- API Gateway. Authentifie les créateurs, applique des limites de création par utilisateur et par IP, et rejette les charges trop lourdes ou mal formées avant qu'elles ne coûtent quoi que ce soit.
- Redirect Service. Un minuscule service sans état avec une seule mission : résoudre un code et renvoyer une redirection. Il lit d'abord Redis, se rabat sur la base des correspondances en cas d'échec, et émet un événement de clic sans l'attendre.
- Create API. Valide l'URL (liste blanche de schémas, longueur maximale, liste de blocage), prend l'identifiant suivant de son bloc loué, l'encode et insère la correspondance.
- ID Range Allocator. Distribue des blocs d'un million d'identifiants aux pods de Create API. Il est sollicité une fois par million de liens, il peut donc s'agir d'une simple ligne dans une base relationnelle sans histoire.
- Redis (
code -> url). Le cache chaud. Les entrées ont un TTL, et les résultats « introuvable » sont mis en cache brièvement pour que les scanners ne martèlent pas la base. - Mappings DB. La source de vérité, partitionnée par code. Chaque recherche de redirection est une lecture par clé primaire sur
code, le seul motif d'accès que ce système doit rendre bon marché. - Click Events, Rollup Workers, Click Counts. Les redirections émettent des événements vers un journal (Kafka, Kinesis ou équivalent). Les workers les agrègent en compteurs par lien et par jour dans un magasin OLAP. Si tout ce bloc prend feu, les redirections continuent de fonctionner.
La note verte du schéma est le contrat : moins de 20 ms de p99 en périphérie, moins de 50 ms quand la requête doit aller jusqu'à Redis ou à la base.
Générer les codes : blocs loués, brouillage de Feistel, puis Base62
Il existe trois façons courantes de produire un code court :
| Approche | Fonctionnement | Atout | Faiblesse |
|---|---|---|---|
| Hachage de l'URL | SHA-256 de l'URL, garder les 40 premiers bits, passer en Base62 | La même URL peut donner le même code | Les collisions imposent des réessais ; deux utilisateurs qui partagent un code mélangent propriété et analytique |
| Code aléatoire | 7 caractères Base62 aléatoires, insertion avec contrainte d'unicité | Impossible à deviner | Réessais en cas de collision ; chaque création est un contrôle d'unicité sur toute la table |
| Compteur + encodage | Entier unique, puis Base62 | Ni collision ni réessai | Des codes séquentiels sont énumérables si on ne les brouille pas |
Je préfère le compteur, avec deux améliorations.
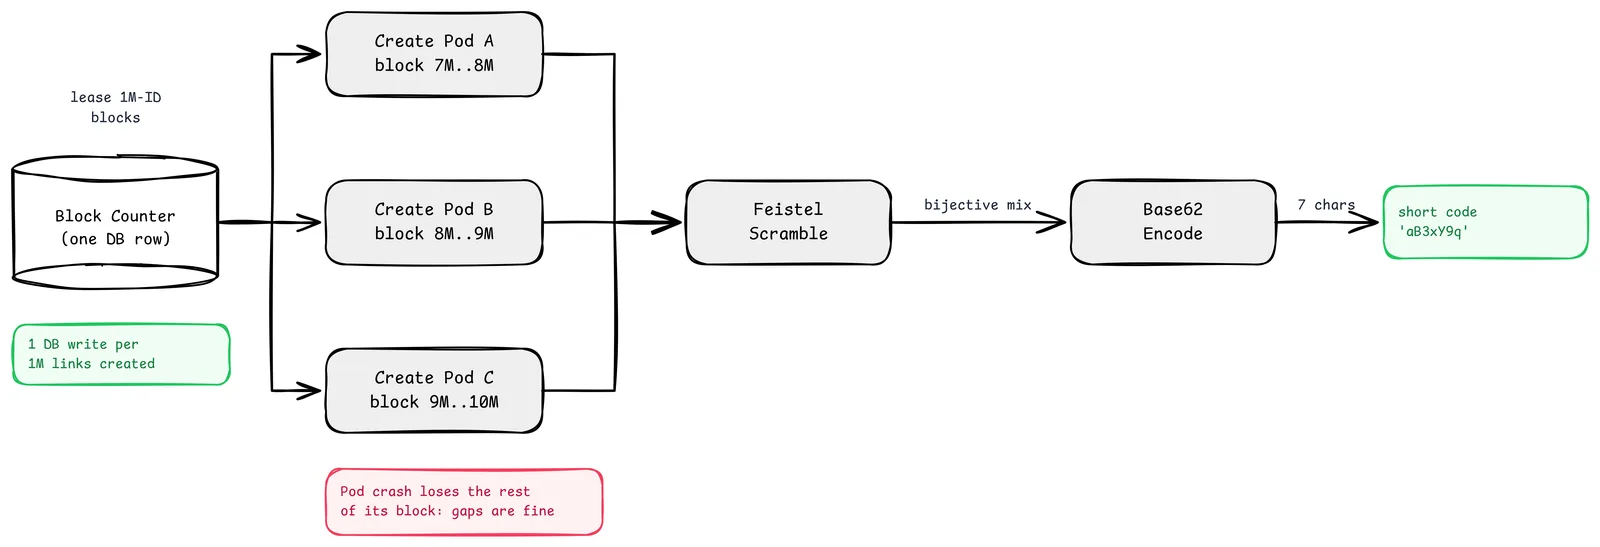
Des blocs loués. Un compteur global unique serait une ligne chaude. À la place, chaque pod de Create API loue un bloc d'un million d'identifiants (UPDATE counter SET next = next + 1000000 RETURNING next) et les distribue depuis sa mémoire. Cela fait une écriture en base par million de liens. Si un pod tombe, le reste de son bloc n'est simplement jamais utilisé. Les trous sont acceptables ; les doublons, non.
Le brouillage de Feistel. Des identifiants séquentiels produisent des codes séquentiels, ce qui rend l'énumération de tous les liens triviale. Un réseau de Feistel est une permutation réversible et paramétrée par une clé sur une largeur de bits fixe : chaque entrée de 40 bits correspond à exactement une sortie de 40 bits, donc l'unicité est préservée, mais les voisins cessent de se ressembler. Ce n'est pas un secret cryptographique. C'est une obfuscation peu coûteuse qui supprime l'attaque de collecte la plus simple.
Base62. 0-9a-zA-Z est sûr dans une URL sans échappement. Un espace de 40 bits (environ 1 100 milliards d'identifiants, soit environ 900 ans à 100 M de liens par mois) tient dans 7 caractères Base62, puisque 62^7 vaut environ 3 500 milliards. Un espace de 42 bits ne tiendrait pas : 2^42 vaut environ 4 400 milliards, et son quart supérieur déborderait sur 8 caractères.
ALPHABET = "0123456789abcdefghijklmnopqrstuvwxyzABCDEFGHIJKLMNOPQRSTUVWXYZ"
HALF_BITS, MASK = 20, (1 << 20) - 1  # 40-bit permutation, always < 62**7

def feistel(n: int, keys=(0x5bd1e, 0x1b873, 0x2f1d3)) -> int:
    left, right = n >> HALF_BITS, n & MASK
    for k in keys:
        left, right = right, left ^ (((right * 0x9E3779B1) ^ k) & MASK)
    return (left << HALF_BITS) | right

def encode(n: int, width: int = 7) -> str:
    out = []
    while n:
        n, r = divmod(n, 62)
        out.append(ALPHABET[r])
    return "".join(reversed(out)).rjust(width, "0")

code = encode(feistel(8_000_123))  # 7 chars, unique per ID
Les alias personnalisés vont dans la même colonne code, avec la même contrainte d'unicité, après une vérification des mots réservés (api, admin, login, health) et un filtre contre les grossièretés et l'usurpation.
Le stockage
Le schéma est volontairement ennuyeux :
| Colonne | Type | Remarques |
|---|---|---|
code |
varchar(16) clé primaire |
Clé de partition ; chaque redirection est une lecture ponctuelle dessus |
long_url |
text |
Validée à la création, jamais réécrite à la lecture |
owner_id |
bigint |
Index secondaire pour les tableaux de bord « mes liens » |
created_at, expires_at |
horodatages | expires_at nul signifie pour toujours |
status |
énumération : active, disabled, taken_down | Permet de neutraliser un lien sans effacer son historique |
SQL ou clé-valeur ? Les deux conviennent. Un magasin clé-valeur managé (DynamoDB, Cassandra, Bigtable) rend la lecture ponctuelle trivialement scalable et offre un TTL natif pour les liens qui expirent. Postgres avec un partitionnement par hachage de code suffit largement jusqu'à plusieurs téraoctets et offre gratuitement des transactions pour l'allocateur et les requêtes par propriétaire. Le mauvais choix, c'est tout ce qui fait de GET par code plus d'un aller-retour.
Partitionnez par code, pas par propriétaire. Partitionner par propriétaire placerait les liens d'une célébrité sur une seule partition chaude. Partitionner par hachage du code répartit la charge, et le tableau de bord du propriétaire peut s'appuyer sur un index secondaire ou une table séparée.
Ne mettez jamais de compteur sur la ligne de correspondance. UPDATE links SET clicks = clicks + 1 à chaque redirection transforme votre lecture la plus chaude en écriture disputée sur une seule ligne. Un lien viral fera fondre cette ligne. Les compteurs ont leur place dans le pipeline analytique.
Le chemin de redirection, précisément
- Le CDN consulte son cache. Succès : il renvoie la redirection en cache. Terminé.
- Redirect Service consulte Redis. Succès : il répond.
- Échec : il lit la base des correspondances par clé primaire. Si la ligne manque, a expiré ou n'est pas active, il met brièvement en cache un « introuvable » et renvoie 404. Sinon, il alimente Redis et répond.
- Il émet un événement de clic vers le journal de façon asynchrone. Si le journal est lent, l'événement est abandonné. On ne bloque jamais la redirection.
Quel code de statut ? Cette décision a des conséquences concrètes :
| Statut | Sémantique (RFC 9110) | Mise en cache | À utiliser quand |
|---|---|---|---|
| 301 Moved Permanently | Permanent | Navigateurs et proxys mettent en cache agressivement | Vous voulez une charge minimale sur l'origine et n'avez pas besoin de comptes de clics précis |
| 302 Found | Temporaire | Pas de cache par défaut | Vous avez besoin que chaque clic vous parvienne pour l'analytique, ou les liens peuvent changer |
| 307 / 308 | Temporaire / permanent, méthode conservée | Comme ci-dessus | Rare pour un raccourcisseur ; utile si des requêtes autres que GET sont redirigées |
Mon choix par défaut : 302 avec un Cache-Control: max-age court et explicite au niveau du CDN (de 60 à 300 secondes, par exemple). Les liens populaires sont servis depuis la périphérie, l'analytique reste raisonnablement honnête (comptez aussi les journaux du CDN), et un retrait se propage en quelques minutes au lieu de vivre éternellement dans le cache du navigateur de quelqu'un.
Ruée sur le cache. Quand un lien froid devient soudain viral, des milliers d'échecs de cache simultanés peuvent frapper la base pour la même clé. Utilisez la coalescence des requêtes (une lecture, plusieurs en attente) dans Redirect Service, ou un verrou court dans Redis.
La lutte contre les abus est une fonctionnalité centrale, pas un ajout
Un raccourcisseur prête la réputation de votre domaine à n'importe quelle URL collée par quelqu'un. Il devient un outil d'hameçonnage si vous ne le concevez pas pour l'empêcher.
- Vérifiez les destinations à la création auprès d'une source de réputation comme Google Safe Browsing, et réanalysez périodiquement les liens populaires, car les destinations changent après coup.
- Limitez la création par compte, par IP et par domaine de destination.
- Proposez une page d'aperçu (
sho.rt/aB3xY9q+selon la convention de Bitly) pour que les utilisateurs prudents voient la destination avant d'y aller. - Rendez le retrait rapide : passez
status = taken_down, supprimez la clé Redis et purgez le chemin du CDN. Avec un 302 et un TTL de périphérie court, c'est une affaire de minutes, pas de jours. - Limitez les redirections par IP pour freiner l'énumération, même avec des codes brouillés.
Modes de défaillance et comportement attendu
| Défaillance | Comportement attendu |
|---|---|
| Redis indisponible | Les redirections se rabattent sur la base. La latence augmente, l'exactitude tient. Délestez en périphérie si la base approche de sa limite |
| Une partition de la base indisponible | Les codes de cette partition échouent ; tout le reste fonctionne. Les réplicas doivent prendre le relais en quelques secondes |
| Journal des clics indisponible | Les redirections continuent ; les événements sont abandonnés ou mis en tampon localement. Les compteurs seront sous-estimés sur la période |
| Allocateur d'identifiants indisponible | Les pods continuent de puiser dans leur bloc actuel. Avec des blocs d'un million, cela laisse des heures de marge |
| Mauvais déploiement de Redirect Service | Le rayon d'impact, c'est chaque lien. Déployez en canari sur une petite part du trafic et gardez le service minuscule pour que le retour arrière soit rapide |
| Un lien devient viral | Le CDN en absorbe l'essentiel ; la coalescence des requêtes protège la base de la première tempête d'échecs de cache |
Ce qui change en entretien
Vous n'aurez pas le temps de parler de réseaux de Feistel ni de réglage des TTL de CDN en 45 minutes. Priorisez :
- Énoncez le rapport lecture:écriture et le calcul de capacité en deux phrases.
- Dessinez les deux chemins séparément.
- Choisissez compteur plus Base62, et mentionnez l'énumération et la parade du brouillage.
- Expliquez pourquoi les compteurs de clics ne vivent pas sur la ligne de correspondance.
- Ayez un avis sur 301 contre 302.
Cela suffit à montrer votre jugement. Le reste est une conversation.
Liste de contrôle pour la production
- Calcul de capacité écrit, avec rapport lecture:écriture et multiplicateur de pic
- Identifiants loués par blocs ; l'allocateur survit aux redémarrages ; les trous sont documentés comme acceptables
- Codes brouillés avant encodage ; les alias personnalisés partagent la contrainte d'unicité
- Liste blanche de schémas, longueur maximale et contrôle de réputation à la création
- Chemin de redirection : CDN, puis Redis avec TTL et cache négatif, puis base par clé primaire
- Coalescence des requêtes contre les ruées sur clés froides
- 302 avec TTL de périphérie court, ou une justification écrite pour 301
- Événements de clic asynchrones, abandonnables, et jamais sur la ligne de correspondance
- Le retrait nettoie statut en base, Redis et CDN en une seule opération
- Tableaux de bord : p99 des redirections, taux de succès du cache, taux de 404, rythme de création par compte
Ce qui reste
Le plus intéressant dans ce système n'est pas l'astuce d'encodage. C'est la discipline qui consiste à garder le chemin de redirection ennuyeux. Chaque demande de fonctionnalité (compteurs en temps réel, destinations A/B, routage géographique) essaiera d'y glisser de la logique.
Dites non à la plupart. Le lien que quelqu'un a collé dans une discussion de groupe il y a trois ans doit encore fonctionner demain matin, avant votre café et avant que quiconque se souvienne qu'il existe.
Sources
- RFC 9110 : HTTP Semantics, section 15.4 (Redirection 3xx)
- Google Safe Browsing API
- Amazon DynamoDB : Time to Live
- Luby et Rackoff, « How to Construct Pseudorandom Permutations from Pseudorandom Functions » (réseaux de Feistel)
- Dans la même série : Concevoir un générateur d'identifiants uniques, Concevoir un limiteur de débit, Estimations au dos de l'enveloppe