TL;DR
- Le problème : Un auto-incrément de base de données unique est unique et ordonné, mais il place une seule machine sur chaque chemin d'écriture. Dès que vous partitionnez, ou que vous créez des identifiants avant l'insertion, il vous faut des identifiants uniques sur de nombreuses machines sans rien demander à personne.
- La conception : Pour la plupart des systèmes, un identifiant de 64 bits de type Snowflake : 41 bits de millisecondes depuis une époque personnalisée, 10 bits d'identifiant de worker loué auprès d'un service de coordination, 12 bits de séquence par milliseconde. Quand 128 bits sont acceptables, UUIDv7 offre le même ordre temporel sans aucune coordination des workers.
- Le résultat : Jusqu'à 4 096 identifiants par milliseconde et par générateur, environ 69 ans de plage, des identifiants approximativement triés par date qui gardent les insertions B-tree bon marché, et une politique claire pour le seul vrai mode de défaillance : l'horloge qui recule.
Les identifiants ressemblent à de la plomberie jusqu'au jour où ils sont faux. Des doublons corrompent les données en silence. Des identifiants aléatoires gonflent les index. Des identifiants séquentiels révèlent votre volume d'activité à quiconque s'inscrit deux fois à une semaine d'intervalle. Et des identifiants qui dépendent d'une seule base de données font de cette base le plafond de débit de toute l'entreprise.
Cet article parcourt les options dans l'ordre où la plupart des entreprises les découvrent, puis conçoit celle que presque toutes finissent par adopter.
Les exigences
- Uniques sur tous les générateurs, pour toujours. Sans exception, y compris après des redémarrages et des problèmes d'horloge.
- Triables approximativement par date de création, pour que les requêtes « les plus récents d'abord » et le stockage par tranches de temps fonctionnent sans index de date séparé.
- Tenir sur 64 bits si possible, car les entiers de 64 bits sont bon marché à stocker, indexer, comparer et faire transiter dans tous les langages et toutes les bases.
- Aucune coordination sur le chemin chaud. Générer un identifiant ne doit pas nécessiter d'appel réseau.
- Un débit élevé : des dizaines de milliers d'identifiants par seconde et par service, avec des rafales.
Tous les systèmes n'ont pas besoin des cinq. La comparaison ci-dessous montre ce que chaque option sacrifie.
Les options
| Approche | Taille | Triable | Coordination | Faiblesse |
|---|---|---|---|---|
| Auto-incrément de base de données | 64 bits | Oui | Chaque insertion passe par une seule base | Goulot d'écriture unique ; casse avec le partitionnement ; révèle le volume |
| Auto-incrément multi-maître (pas = N) | 64 bits | Par serveur uniquement | Nombre fixe de serveurs | Ajouter un serveur impose de renuméroter le schéma |
| UUIDv4 | 128 bits | Non | Aucune | Les insertions aléatoires fragmentent les index B-tree ; clés volumineuses |
| UUIDv7 (RFC 9562) | 128 bits | Oui (ms) | Aucune | 128 bits ; reste plus gros qu'une clé entière |
| Serveur de tickets (Flickr) | 64 bits | Oui | Un appel réseau par identifiant, ou par lot | Les serveurs de tickets deviennent une infrastructure critique |
| Snowflake (Twitter) | 64 bits | Oui (ms) | Attribution de l'identifiant de worker au démarrage seulement | Dépend du bon comportement des horloges |
UUIDv4, ce sont 122 bits aléatoires. Les collisions ne posent pas de problème pratique. La localité d'index, si : chaque insertion tombe sur une page aléatoire du B-tree de la clé primaire, ce qui provoque des éclatements de pages et garde en mémoire une bien plus grande partie de l'index. Sur de grosses tables, c'est une pénalité mesurable en débit d'écriture et en efficacité du cache.
UUIDv7, normalisé dans la RFC 9562 en 2024, place un horodatage Unix de 48 bits en millisecondes dans les bits de poids fort, suivi de bits aléatoires. On obtient l'ordre temporel et une bonne localité d'index sans aucune coordination. Si votre base dispose d'un type UUID natif et que des clés de 16 octets sont acceptables, UUIDv7 est la bonne réponse la plus simple en 2025.
Les serveurs de tickets, c'est ce que Flickr a décrit en 2010 : une minuscule table MySQL où REPLACE INTO Tickets64 (stub) VALUES ('a'); SELECT LAST_INSERT_ID(); distribue le numéro suivant. Deux serveurs configurés avec auto_increment_increment = 2 et des décalages de 1 et 2 apportent la redondance (identifiants pairs et impairs). Cela fonctionne bien et se raisonne facilement, mais chaque identifiant exige un aller-retour, sauf à distribuer des lots.
Snowflake, que Twitter a publié en open source en 2010, obtient à la fois l'ordre, les 64 bits et l'absence de coordination par identifiant. C'est pourquoi on en retrouve des variantes chez Discord, dans le schéma d'identifiants partitionnés d'Instagram et dans Sonyflake de Sony.
Le format Snowflake
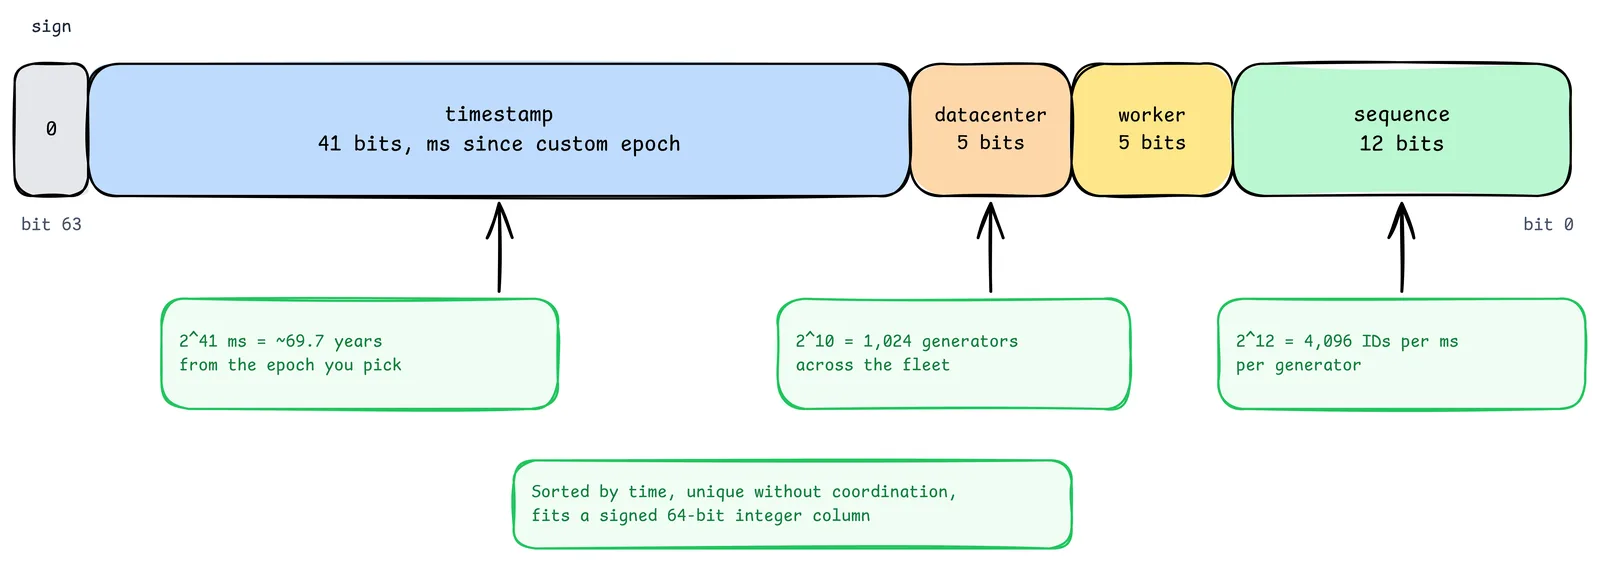
- Bit de signe (0). Maintenu à zéro pour que l'identifiant soit un entier signé positif de 64 bits dans les langages et bases sans type non signé.
- Horodatage, 41 bits. Des millisecondes depuis une époque de votre choix. 2^41 millisecondes font environ 69,7 ans. L'époque de Twitter se situe en novembre 2010 ; celle de Discord est la première milliseconde de 2015. Choisissez une époque récente pour ne pas gaspiller de plage.
- Centre de données et worker, 10 bits. Identifient le générateur. Les découper en 5 + 5 est une convention, pas une obligation. L'important est que deux générateurs actifs ne partagent jamais la même valeur.
- Séquence, 12 bits. Un compteur remis à zéro à chaque milliseconde. 4 096 identifiants par milliseconde et par générateur, cela fait environ 4 millions par seconde.
Comme l'horodatage occupe les bits de poids fort, trier les identifiants numériquement les trie par date de création (à la milliseconde, et entre générateurs seulement avec la précision de l'accord entre leurs horloges).
La variante d'Instagram de 2012 modifie le format en 41 bits de temps, 13 bits d'identifiant de partition logique et 10 bits de séquence, générés à l'intérieur même de PostgreSQL. Le principe est identique : d'abord le temps, puis le « qui », puis le « combien dans cette milliseconde ».
Un générateur qui fonctionne
Voici un générateur complet et sûr en contexte multithread. Il utilise un identifiant de worker plat de 10 bits plutôt que le découpage 5 + 5, et gère les deux cas limites qui comptent : l'épuisement de la séquence dans une milliseconde, et l'horloge qui recule.
import threading
import time

EPOCH_MS = 1_704_067_200_000          # 2024-01-01T00:00:00Z, your own epoch
WORKER_BITS, SEQ_BITS = 10, 12
MAX_WORKER, MAX_SEQ = (1 << WORKER_BITS) - 1, (1 << SEQ_BITS) - 1
MAX_BACKWARD_MS = 5

class Snowflake:
    def __init__(self, worker_id: int):
        if not 0 <= worker_id <= MAX_WORKER:
            raise ValueError("worker_id out of range")
        self.worker_id, self.last_ms, self.seq = worker_id, -1, 0
        self.lock = threading.Lock()

    def next_id(self) -> int:
        with self.lock:
            now = time.time_ns() // 1_000_000
            if now < self.last_ms:                      # clock moved backward
                if self.last_ms - now > MAX_BACKWARD_MS:
                    raise RuntimeError("clock moved backward, refusing to mint IDs")
                now = self._wait_until(self.last_ms)
            if now == self.last_ms:
                self.seq = (self.seq + 1) & MAX_SEQ
                if self.seq == 0:                       # 4,096 IDs used this ms
                    now = self._wait_until(self.last_ms + 1)
            else:
                self.seq = 0
            self.last_ms = now
            return ((now - EPOCH_MS) << (WORKER_BITS + SEQ_BITS)) | (self.worker_id << SEQ_BITS) | self.seq

    @staticmethod
    def _wait_until(target_ms: int) -> int:
        while (now := time.time_ns() // 1_000_000) < target_ms:
            time.sleep(0.0001)
        return now
Je l'ai exécuté pour 300 000 identifiants sur un générateur : tous uniques, strictement croissants, et chacun se décode vers le bon horodatage et le bon worker. Décoder, ce ne sont que des décalages et des masques : timestamp = (id >> 22) + EPOCH_MS, worker = (id >> 12) & 1023, sequence = id & 4095.
Où vit le générateur
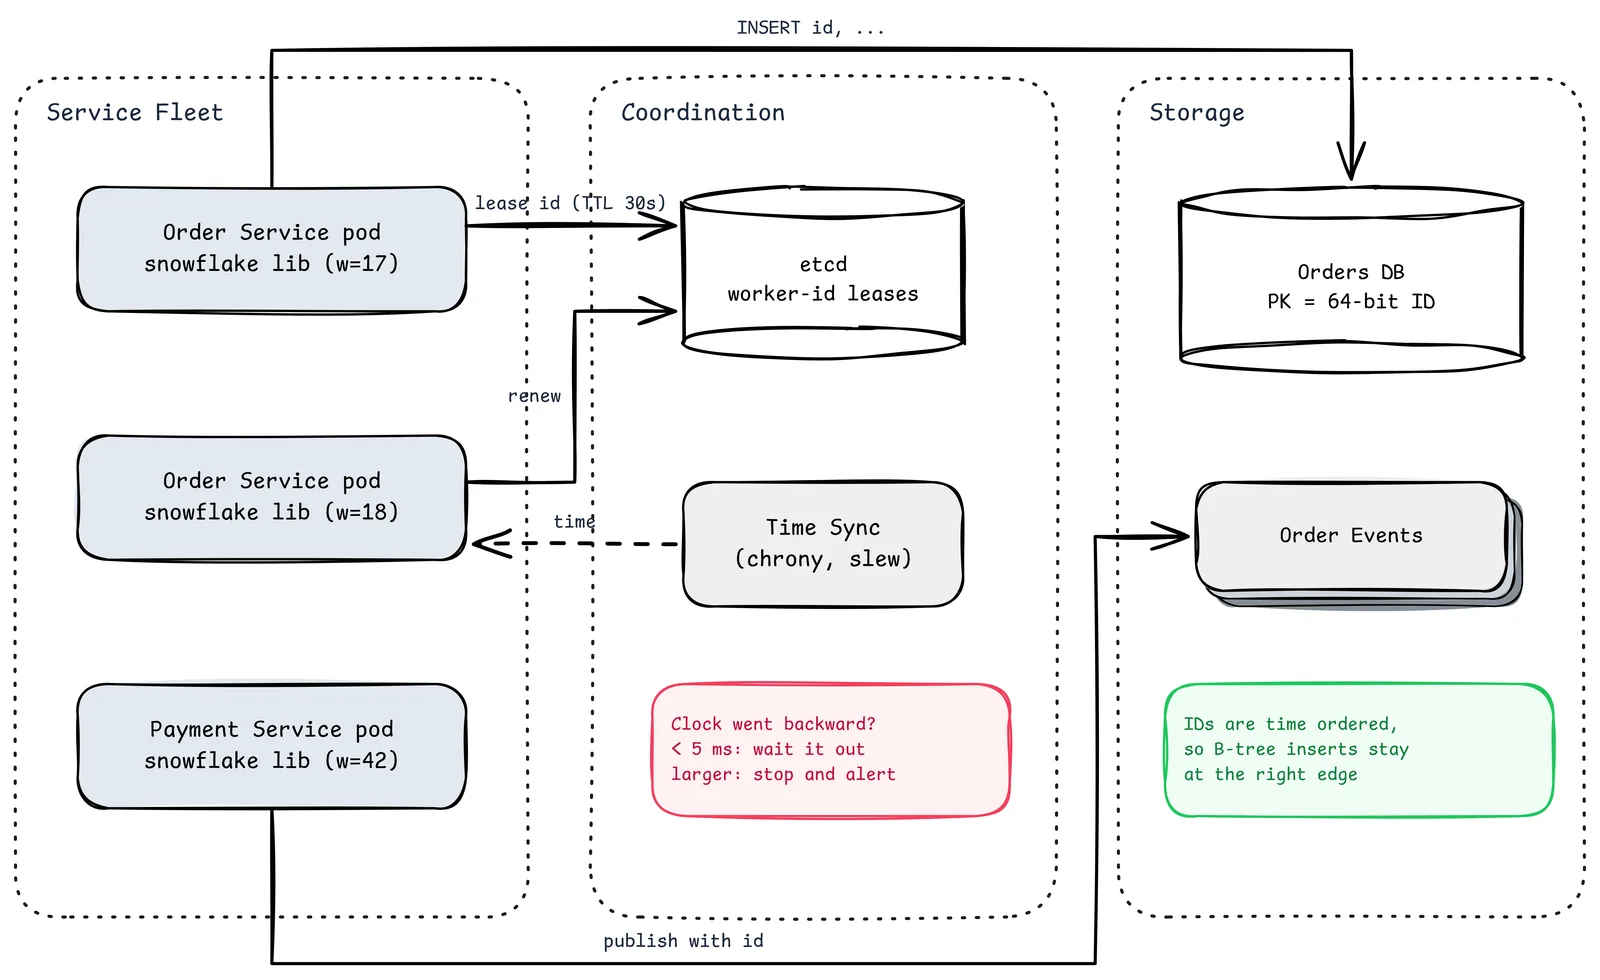
- Pods de service avec bibliothèque embarquée. Le générateur est une bibliothèque dans chaque service, pas un service réseau. Créer un identifiant est un appel de fonction sous verrou : pas de saut réseau, pas de dépendance sur le chemin de la requête.
- etcd (location des identifiants de worker). Au démarrage, chaque pod loue un identifiant de worker libre avec un TTL (30 secondes par exemple) et le renouvelle tant qu'il vit. Si le pod meurt, le bail expire et l'identifiant peut être réutilisé, mais seulement après le TTL, donc deux pods vivants ne le partagent jamais. Les nœuds éphémères de ZooKeeper ou une table de baux en base fonctionnent de la même façon. Une configuration statique convient aussi à une flotte fixe, mais c'est précisément ce que l'autoscaling casse.
- Time Sync (chrony, mode slew). La discipline d'horloge est la vraie dépendance du générateur. Configurez NTP/chrony pour ajuster progressivement l'horloge (l'accélérer ou la ralentir) plutôt que de la faire sauter, afin que les corrections ne ramènent jamais le temps en arrière.
- Orders DB. La clé primaire est l'identifiant de 64 bits. Comme les identifiants sont ordonnés dans le temps, les nouvelles lignes arrivent au bord droit du B-tree, le cas le moins coûteux pour tout moteur relationnel.
- Order Events. Le même identifiant circule dans les événements, les journaux et les traces, ce qui rend trivial le rapprochement entre une ligne et tout ce qui s'est passé autour.
La note rouge décrit la politique face à la seule défaillance inquiétante, traitée ci-dessous.
Le vrai problème, ce sont les horloges
L'unicité de Snowflake repose sur une hypothèse : un générateur ne réutilise jamais un couple (timestamp, sequence). Une horloge qui recule brise cette hypothèse.
Pourquoi les horloges reculent : un saut NTP après une longue dérive, une VM migrée vers un hôte à l'horloge différente, une modification manuelle, ou une implémentation de seconde intercalaire qui répète une seconde.
Les défenses, par ordre de préférence :
- Empêcher les grands sauts. Utilisez chrony ou ntpd configurés en ajustement progressif. Activez le lissage de seconde intercalaire (Google et AWS publient une heure lissée), pour qu'aucune seconde ne soit jamais répétée.
- Absorber les petits sauts. Si l'horloge a quelques millisecondes de retard sur le dernier horodatage utilisé, attendez qu'elle rattrape, comme le fait le code ci-dessus.
- Refuser les grands sauts. Si l'horloge a beaucoup de retard, arrêtez de produire des identifiants et levez une alerte. Échouer bruyamment vaut bien mieux que produire des doublons en silence.
- Survivre aux redémarrages. Au démarrage, attendez que l'horloge dépasse le dernier horodatage que le processus précédent a pu utiliser (ou persistez-le), surtout si un redémarrage peut atterrir sur un autre hôte.
Rappelez-vous aussi que l'ordre temporel entre générateurs ne vaut que l'accord entre leurs horloges. Deux identifiants produits à une milliseconde d'écart sur deux machines différentes peuvent se trier dans un sens comme dans l'autre. « Approximativement triés », c'est la promesse honnête.
Remarques de sécurité et de produit
- Les identifiants divulguent de l'information. Un identifiant Snowflake révèle quand quelque chose a été créé, et parfois dans quel centre de données. Des identifiants séquentiels de base révèlent le volume (créez deux commandes à une semaine d'intervalle et faites la soustraction). Pour des identifiants publics, envisagez un identifiant opaque distinct ou le chiffrement de l'identifiant interne.
- N'utilisez jamais un identifiant comme secret. Impossible à deviner ne veut pas dire autorisé. Les contrôles d'autorisation s'appliquent à chaque recherche par identifiant.
- La précision en JavaScript. En JavaScript, les nombres sont des doubles, sûrs seulement jusqu'à 2^53. Un Snowflake de 64 bits envoyé comme nombre JSON sera arrondi en silence dans les navigateurs. Envoyez les identifiants sous forme de chaînes dans le JSON. L'API de Discord fait exactement cela.
Comment je choisirais
| Situation | Choix |
|---|---|
| Une seule base, débit d'écriture modéré, identifiants internes | L'auto-incrément suffit. Pas de sur-ingénierie |
| Besoin d'identifiants avant l'insertion, 16 octets acceptables, pas de budget d'exploitation pour coordonner | UUIDv7 |
| Besoin d'entiers de 64 bits, nombreux services, débit élevé | Snowflake avec identifiants de worker loués |
| Besoin de numéros strictement consécutifs (factures, séquences légales) | Un serveur de tickets ou une séquence de base, en acceptant le goulot |
Liste de contrôle pour la production
- Époque choisie récente et documentée ; horizon de 69 ans noté
- Identifiants de worker loués avec TTL auprès d'un service de coordination, jamais attribués à la main dans une flotte autoscalée
- Synchronisation d'horloge en ajustement progressif ; lissage des secondes intercalaires activé
- Politique d'horloge qui recule implémentée : attendre pour un petit décalage, échouer et alerter pour un grand
- L'épuisement de la séquence attend la milliseconde suivante au lieu de reboucler
- Identifiants sérialisés en chaînes dans les API JSON
- Identifiants publics examinés pour éviter les fuites d'information
- Métriques : identifiants produits par seconde, attentes dues à la séquence épuisée, erreurs de décalage d'horloge, échecs de renouvellement de bail
Ce qui reste
Un identifiant Snowflake est une minuscule autobiographie : quand il est né, où, et combien de frères et sœurs il a eus dans cette milliseconde.
C'est aussi un pari discret : que l'horloge de cette machine continuera d'avancer. La plupart du temps, elle le fait. Toute la conception porte sur les rares fois où ce n'est pas le cas, et sur la garantie que le générateur s'en aperçoive avant votre base de données.
Sources
- Twitter Engineering : Announcing Snowflake (2010)
- Flickr : Ticket Servers, Distributed Unique Primary Keys on the Cheap
- Instagram Engineering : Sharding and IDs at Instagram
- RFC 9562 : Universally Unique IDentifiers (UUIDv7)
- Documentation développeur de Discord : Snowflakes
- Google Public NTP : leap smear
- Dans la même série : Concevoir un raccourcisseur d'URL, Concevoir un magasin clé-valeur