TL;DR
- Le problème : Renvoyer les dix meilleures complétions pour le préfixe saisi, à chaque frappe, assez vite pour que les suggestions paraissent instantanées (bien moins de 100 ms de bout en bout), pour des dizaines de milliers de requêtes par seconde, sans jamais suggérer quoi que ce soit d'offensant.
- La conception : Séparer le système en deux chemins. Le chemin de requête est une recherche purement en mémoire dans un trie dont chaque nœud stocke déjà ses k meilleures complétions, avec des caches CDN et client devant. Le chemin de données agrège hors ligne les journaux de recherche avec décroissance temporelle, les filtre, construit de nouveaux instantanés du trie et les envoie aux serveurs.
- Le résultat : Une recherche coûte un parcours de
len(prefix)étapes et renvoie une liste calculée il y a des heures. Tout le travail coûteux, classement, filtrage et déduplication, se fait hors ligne, là où il peut être lent et soigneux.
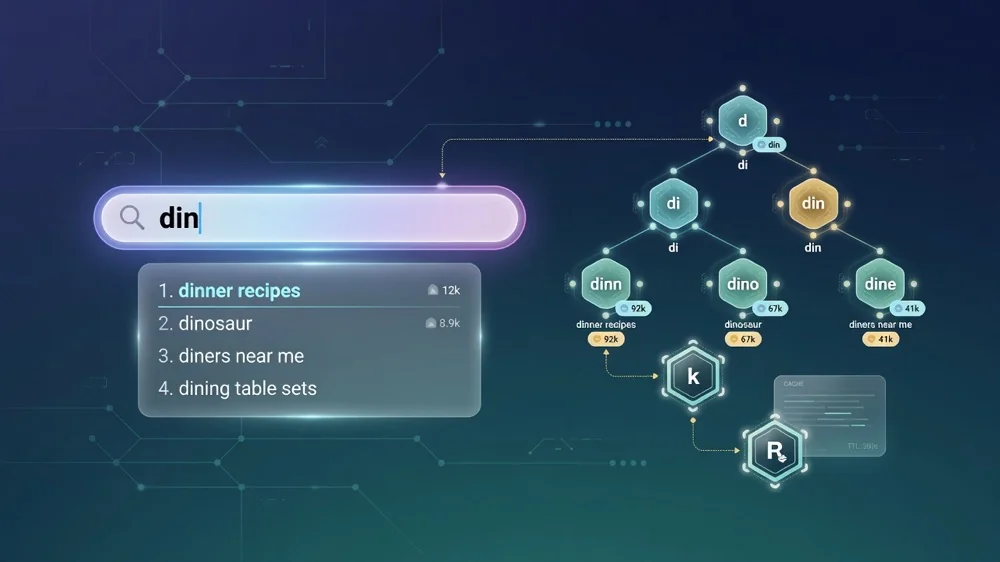
L'autocomplétion fait partie des rares fonctionnalités où la latence est le produit. Une barre de recherche qui suggère « dinner recipes » 300 ms après que vous avez tapé « din » paraît cassée, même si les suggestions sont bonnes. La conception découle de cette seule contrainte : rien de coûteux ne doit se produire pendant que l'utilisateur tape.
Exigences et chiffres
Fonctionnelles : pour un préfixe donné, renvoyer jusqu'à 10 suggestions classées par popularité (éventuellement personnalisées et localisées) ; mettre à jour les suggestions quand le comportement de recherche évolue ; ne jamais suggérer de contenu bloqué.
Non fonctionnelles : p99 sous environ 50 ms côté serveur pour que l'expérience complète reste sous 100 ms ; haute disponibilité (si l'autocomplétion tombe, la recherche doit continuer de marcher) ; les résultats peuvent avoir quelques heures de retard.
| Hypothèse | Valeur | Conséquence |
|---|---|---|
| Utilisateurs qui cherchent chaque jour | 10 M | |
| Recherches par utilisateur et par jour | 10 | 100 M de recherches/jour |
| Requêtes par recherche après anti-rebond | ~6 | ~600 M de requêtes/jour, ~7 k/s en moyenne, ~20 k/s en pic |
| Requêtes distinctes conservées | ~100 M | Après élimination de la longue traîne vue une ou deux fois |
| Suggestions par nœud | 10 | La mémoire croît avec nœuds x k, d'où un k petit |
Le nombre de requêtes par recherche est l'endroit où la conception du client compte. Sans anti-rebond, une requête de 15 caractères, c'est 15 requêtes.
Deux chemins
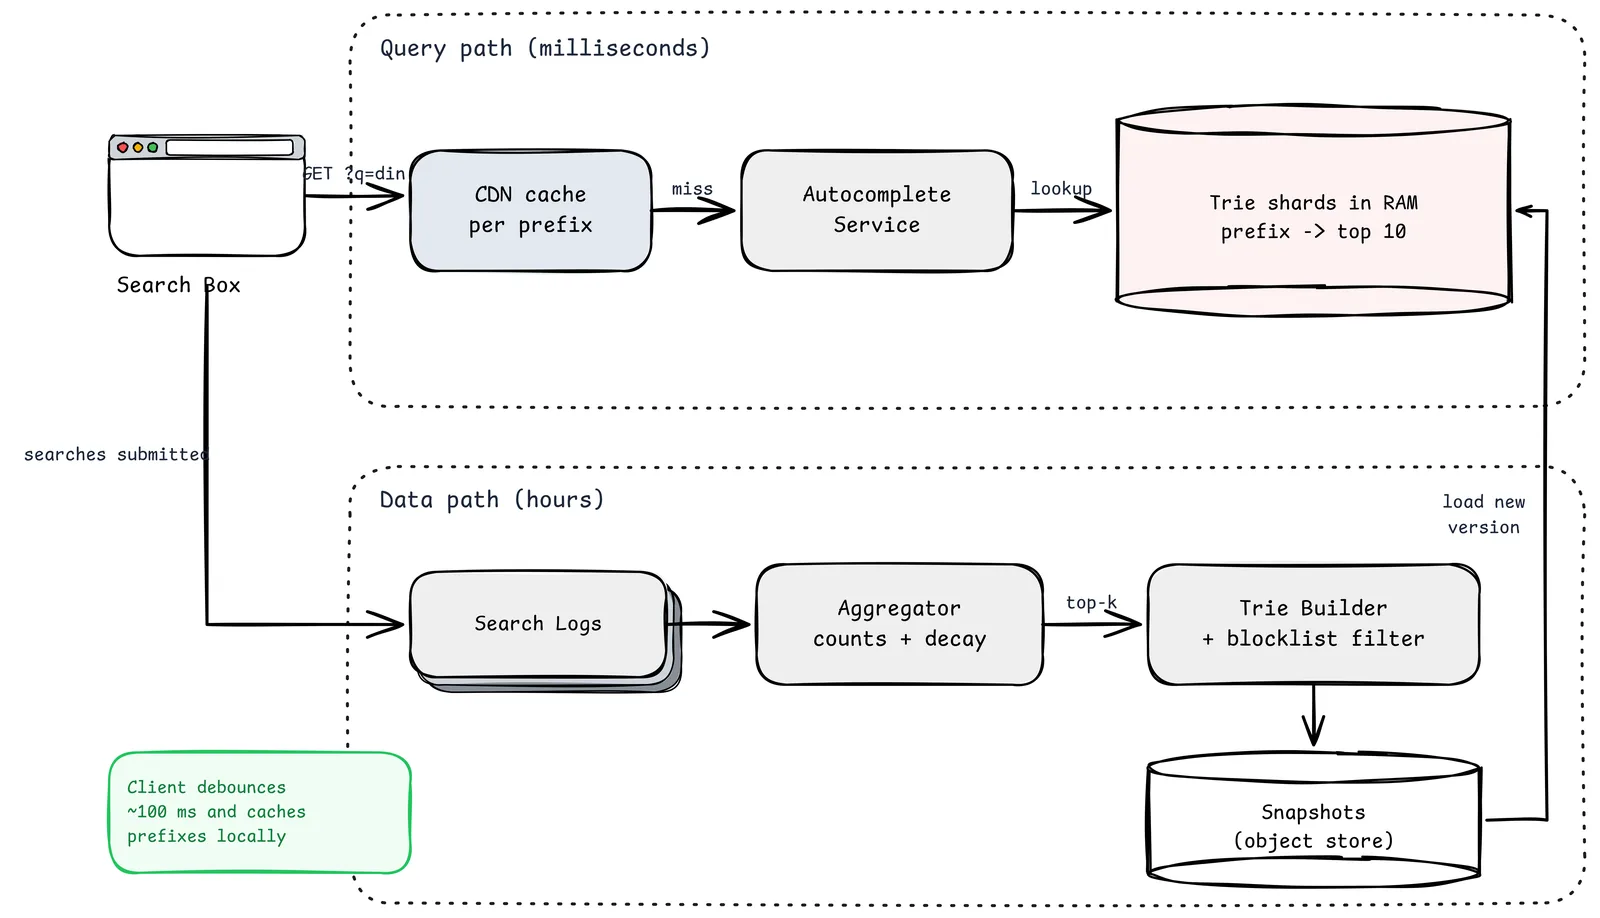
Chemin de requête (millisecondes)
- Search Box. Applique un anti-rebond aux frappes (environ 100 ms), met en cache localement les réponses par préfixe et annule les requêtes en cours quand un préfixe plus récent est saisi.
- Cache CDN par préfixe. Les préfixes courts (« a », « th », « how ») sont demandés par des millions d'utilisateurs. Mettre les réponses en cache en périphérie pendant quelques minutes absorbe une grande part du trafic avant qu'il n'atteigne vos serveurs. Les résultats personnalisés ne peuvent pas être mis en cache ainsi, ce qui explique en partie pourquoi la personnalisation est généralement une fine couche de reclassement par-dessus.
- Autocomplete Service. Traitement des requêtes sans état : normaliser le préfixe (minuscules, espaces supprimés, normalisation Unicode), router vers la bonne partition du trie, renvoyer la liste stockée.
- Partitions du trie en RAM. Tout l'index vit en mémoire. Chaque nœud stocke son top 10 précalculé.
Chemin de données (heures)
- Search Logs. Chaque recherche soumise (pas chaque frappe) est journalisée avec l'heure, la langue et le fait que l'utilisateur ait cliqué ou non sur un résultat.
- Agrégateur (comptes et décroissance). Un traitement par lots ou en flux calcule un score par requête, en pondérant davantage les recherches récentes, pour que l'actualité de la semaine dernière s'efface et que le nom d'un nouveau produit monte.
- Trie Builder + filtre de blocage. Écarte les termes bloqués, les données personnelles et le spam, puis construit le trie avec des listes top-k par nœud.
- Snapshots (stockage objet). Des fichiers de trie versionnés. Les serveurs chargent une nouvelle version en arrière-plan et basculent atomiquement ; une mauvaise construction s'annule en pointant vers la version précédente.
Cette séparation est toute la conception. Le chemin de requête ne calcule jamais rien ; le chemin de données ne sert jamais rien.
Le trie, avec un top-k à chaque nœud
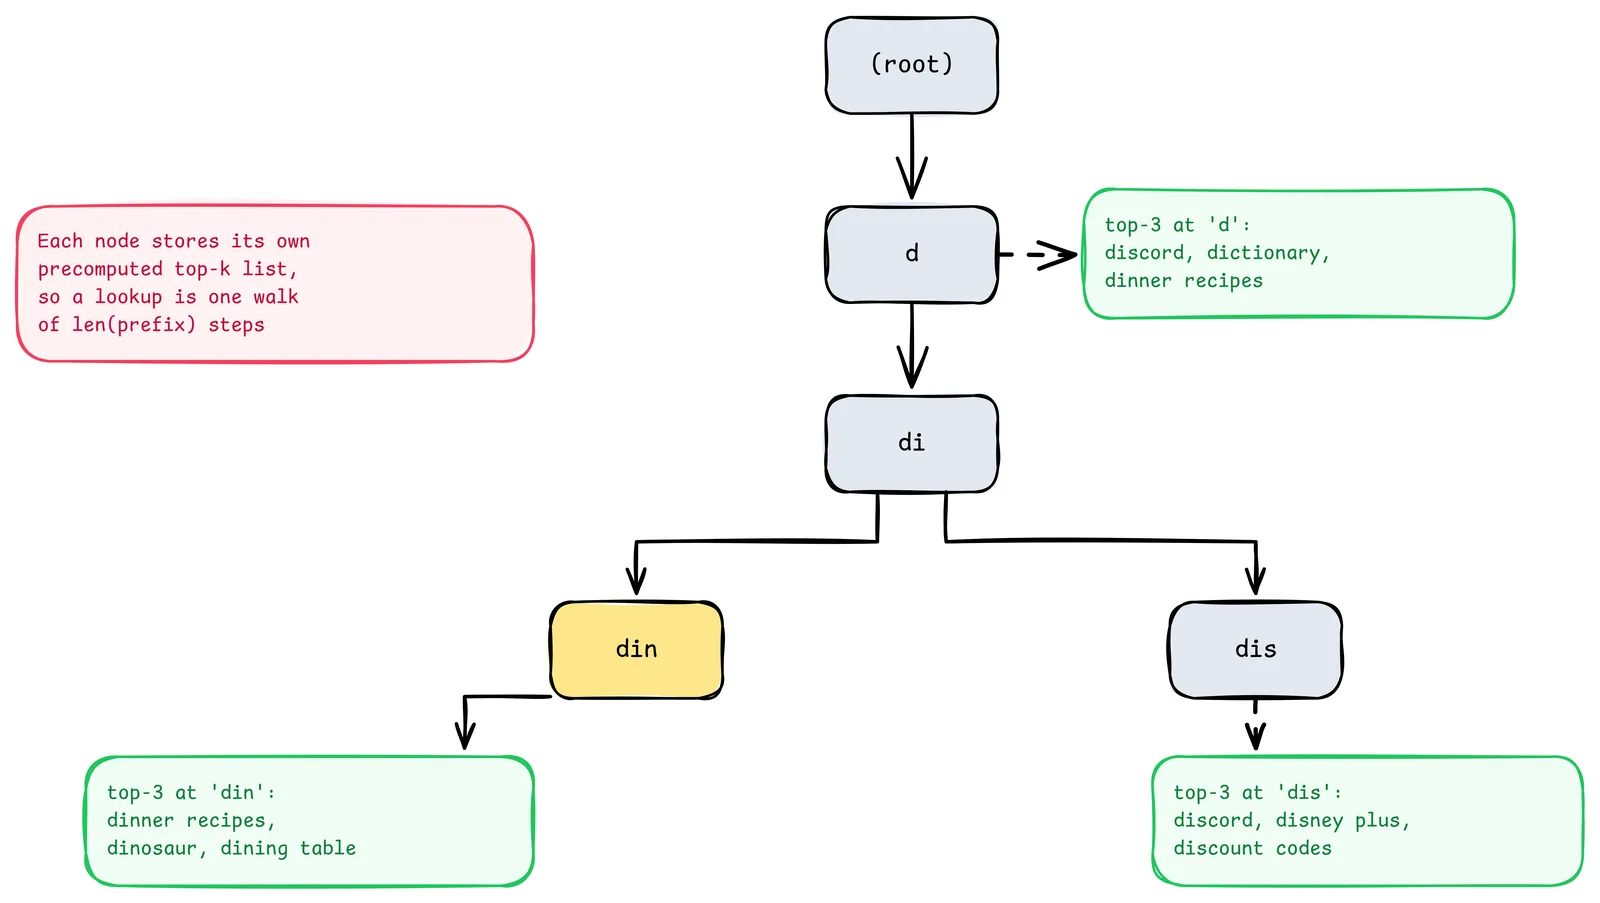
Un trie classique trouve tous les mots d'un préfixe en descendant jusqu'au nœud du préfixe, puis en parcourant tout ce qui se trouve en dessous. Pour le préfixe « d », ce sous-arbre est immense. La parade consiste à stocker la réponse dans le nœud : à la construction, on pousse le score de chaque requête dans la liste top-k de chaque nœud de son chemin. Une recherche devient alors un parcours de len(prefix) étapes suivi du renvoi d'une liste.
import heapq

class Node:
    __slots__ = ("children", "top")
    def __init__(self):
        self.children, self.top = {}, []

def build(counts: dict[str, int], k: int = 10) -> Node:
    root = Node()
    for query, score in counts.items():
        node = root
        for ch in query:
            node = node.children.setdefault(ch, Node())
            heapq.heappush(node.top, (score, query))
            if len(node.top) > k:
                heapq.heappop(node.top)          # keep only the k best
    for node in _walk(root):                      # freeze: best first
        node.top = [q for _, q in sorted(node.top, reverse=True)]
    return root

def _walk(node):
    yield node
    for child in node.children.values():
        yield from _walk(child)

def suggest(root: Node, prefix: str) -> list[str]:
    node = root
    for ch in prefix.lower():
        node = node.children.get(ch)
        if node is None:
            return []
    return node.top
Avec les scores discord: 2000, dictionary: 1200, dinner recipes: 900, disney plus: 850, discount codes: 800, dinosaur: 700, dining table: 650 et k = 3, suggest("din") renvoie ["dinner recipes", "dinosaur", "dining table"], comme sur le schéma. Je l'ai exécuté pour vérifier.
Le compromis mémoire. Stocker k suggestions à chaque nœud multiplie la mémoire, donc les systèmes en production stockent des identifiants de requête plutôt que des chaînes, plafonnent la profondeur à laquelle les listes sont stockées (les préfixes profonds sont rares et peuvent se rabattre sur un parcours du sous-arbre) et compressent la structure. Le completion suggester de Lucene et d'Elasticsearch utilise des transducteurs à états finis (FST) précisément pour cette raison : ils partagent préfixes et suffixes communs et font tenir de grands vocabulaires en mémoire.
Classement et fraîcheur
| Signal | Effet |
|---|---|
| Fréquence de la requête avec décroissance temporelle | Une popularité de base qui laisse quand même monter les nouvelles tendances |
| Clics sur les résultats | Les requêtes qui ne mènent nulle part sont rétrogradées |
| Langue et région | « football » ne veut pas dire la même chose selon les pays |
| Historique personnel | Un léger reclassement de la liste globale, fait dans le service, pas dans le trie |
| Détection des tendances | Un petit chemin en flux qui injecte les requêtes montantes entre deux reconstructions complètes |
Une reconstruction complète toutes les quelques heures couvre l'essentiel des besoins de fraîcheur. Pour l'actualité brûlante, un traitement en flux peut calculer un petit trie « tendances » que le service fusionne avec le résultat principal, pour qu'un pic soudain apparaisse en quelques minutes plutôt qu'en quelques heures.
Faire passer le chemin de requête à l'échelle
- Répliquer avant de partitionner. Un trie filtré pour une langue tient souvent dans quelques dizaines de gigaoctets de RAM. Répliquer le trie entier sur chaque serveur est plus simple que de le partitionner et donne à chaque serveur la réponse complète.
- Partitionner par préfixe quand il ne tient plus. Découper sur le premier ou les deux premiers caractères, avec des coupes plus fines pour les lettres déséquilibrées (bien plus de requêtes commencent par « s » que par « x »). Le service route selon le préfixe normalisé.
- Mettre en cache agressivement en périphérie. Les préfixes courts sont les plus chauds et les moins personnels ; donnez-leur des TTL CDN de quelques minutes.
- Échouer en ne renvoyant rien. Si l'autocomplétion est en panne, renvoyez vite une liste vide. La barre de recherche fonctionne toujours ; les utilisateurs tapent juste un peu plus.
La sécurité n'est pas optionnelle
L'autocomplétion met des mots dans la bouche des utilisateurs. Toutes les grandes entreprises de recherche ont été embarrassées par une suggestion qui complétait le nom d'une personne par une accusation, ou celui d'un groupe par une insulte.
- Maintenez des listes de blocage pour la haine, la violence, le contenu sexuel et l'automutilation, appliquées dans le constructeur et revérifiées au moment de servir pour les ajouts urgents.
- Retirez des journaux les données personnelles comme les numéros de téléphone et les adresses e-mail avant l'agrégation.
- Redoublez de prudence pour les requêtes portant sur des personnes ; beaucoup de produits ne suggèrent pas de complétions sur des personnes nommées dans des contextes sensibles.
- Exigez un nombre minimal d'utilisateurs distincts avant qu'une requête puisse être suggérée, pour qu'une seule personne ou un bot ne puisse pas injecter de suggestions.
- Prévoyez un interrupteur d'urgence par suggestion, effectif en quelques minutes, pas à la prochaine reconstruction.
Liste de contrôle pour la production
- Anti-rebond côté client, cache local par préfixe et annulation des requêtes
- Normalisation des préfixes identique dans le constructeur et dans le service
- Top-k stocké par nœud ; mémoire mesurée à chaque construction
- Constructions versionnées, validées (taille, requêtes d'échantillon, vérification de la liste de blocage) et basculées atomiquement
- Retour à l'instantané précédent en une étape
- Cache CDN pour les préfixes courts et non personnalisés
- Seuil minimal d'utilisateurs distincts et listes de blocage, plus une procédure de retrait d'urgence
- Échec rapide avec une liste vide ; la recherche ne doit pas dépendre de l'autocomplétion
- Tableaux de bord : latence p99, taux de succès des caches (client, CDN, service), clics sur les suggestions, âge de la construction
Ce qui reste
La meilleure autocomplétion est celle à laquelle les utilisateurs ne pensent jamais. Ils tapent trois lettres, ce qu'ils voulaient est déjà là, et ils appuient sur Entrée.
Derrière ce moment, il y a un pipeline exécuté il y a des heures, une liste de blocage que quelqu'un a mise à jour à minuit, et un instantané chargé sans un bruit. L'utilisateur a vu dix mots. Le système s'est souvenu de millions de personnes qui avaient posé la même question avant lui.
Sources
- Elasticsearch : completion suggester (fondé sur les FST)
- Apache Lucene : documentation du paquet FST
- Aide de la recherche Google : fonctionnement et règles de la saisie semi-automatique
- MDN : anti-rebond (glossaire)
- Dans la même série : Concevoir un robot d'exploration web, Estimations au dos de l'enveloppe, Motifs de cache avec Redis