TL;DR
- Le problème : Tous les schémas d'architecture des grands systèmes montrent l'état final. Les équipes copient cet état final dès le premier jour et se noient dans la complexité, ou ignorent la montée en charge jusqu'à ce que la base de données tombe pendant un lancement.
- La conception : Grandir en huit étapes (séparer la base de données, ajouter un répartiteur de charge, ajouter des réplicas de lecture et un cache, déplacer les fichiers statiques vers un CDN et rendre les serveurs applicatifs sans état, envoyer le travail lent vers des files, ajouter des régions, partitionner la base principale), et ne franchir chaque étape que lorsqu'une métrique dit que la conception précédente est à bout.
- Le résultat : Un système jamais plus complexe que son trafic ne l'exige, avec le coup suivant prêt quand un tableau de bord passe au rouge. Beaucoup de très gros produits ont tourné des années sur étonnamment peu de machines parce qu'ils ont franchi ces étapes tard, et bien.
Stack Overflow, l'un des sites les plus fréquentés d'internet, a longtemps tourné sur environ neuf serveurs web et quelques machines SQL Server. Instagram a atteint des dizaines de millions d'utilisateurs avec une petite équipe et une pile assez classique : Django, PostgreSQL, Redis et memcached. La leçon n'est pas que la montée en charge est facile. C'est que l'essentiel consiste à faire la prochaine chose évidente au bon moment, mesures à l'appui, plutôt que la chose impressionnante trop tôt.
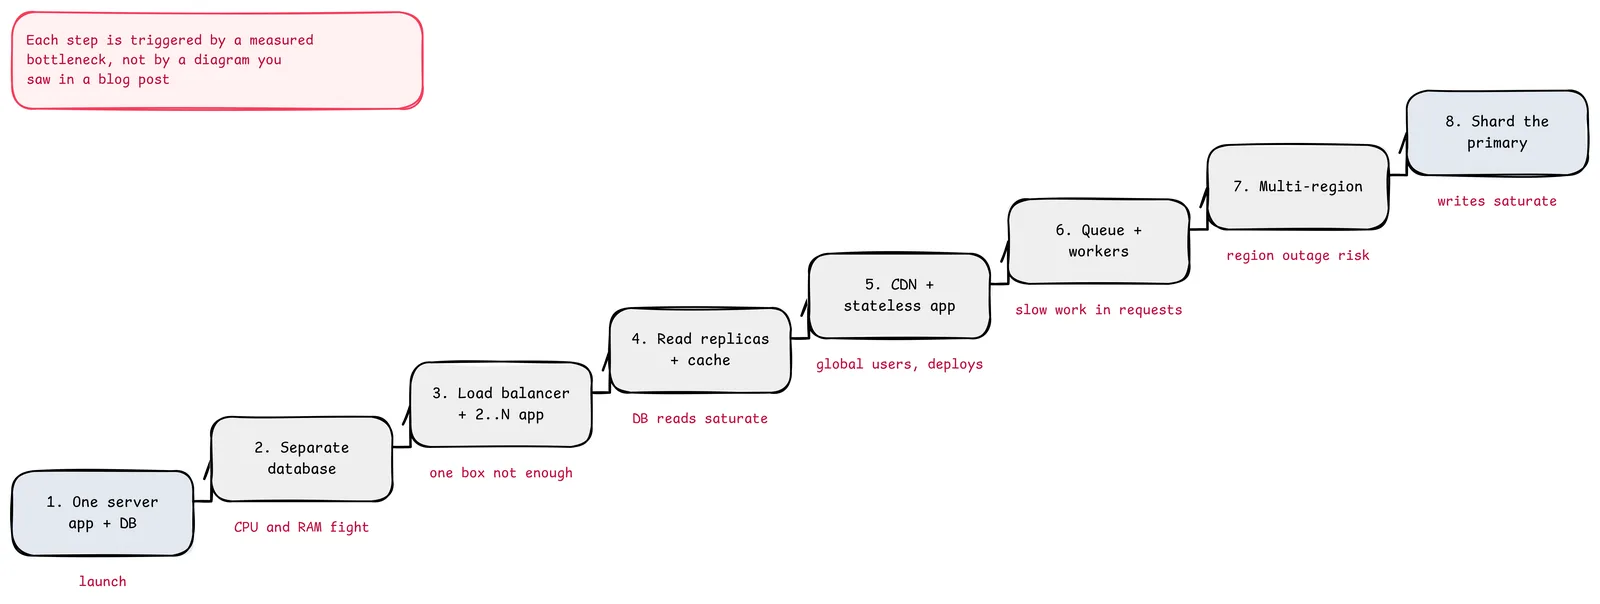
La note rouge est la règle de tout l'article. Chaque étape ci-dessous indique ce qui la déclenche, ce qu'elle apporte et le nouveau problème qu'elle crée.
Étape 1 : un seul serveur
Application, base de données et fichiers sur une seule machine. C'est la bonne architecture pour un nouveau produit : une seule chose à déployer, une seule à sauvegarder, aucun réseau entre les composants.
Quand passer à la suite : l'application et la base se disputent le CPU et la mémoire, ou il faut redémarrer l'une sans l'autre.
Étape 2 : séparer la base de données
Placez la base sur sa propre machine (ou un service managé). Chacune se dimensionne alors indépendamment, et l'hôte de la base ne fait plus que servir des requêtes.
Nouveau problème : le saut réseau. Des requêtes peu coûteuses en local coûtent désormais un aller-retour, si bien que le motif des N+1 requêtes compte soudain.
Quand passer à la suite : le CPU du serveur applicatif sature en pic, ou vous ne pouvez plus tolérer l'interruption quand cette machine redémarre.
Étape 3 : un répartiteur de charge et plusieurs serveurs applicatifs
Placez deux serveurs applicatifs ou plus derrière un répartiteur de charge. Faire grandir la couche web revient à ajouter des machines.
Nouveau problème : l'état. Si la session d'un utilisateur vit dans la mémoire d'un serveur, la requête suivante peut atterrir ailleurs. Soit on utilise des sessions collantes (simple et fragile), soit, mieux, on sort complètement les sessions des serveurs applicatifs (étape 5).
Quand passer à la suite : la limite n'est plus la couche applicative mais la base. Généralement les lectures.
Étape 4 : réplicas de lecture et cache
La plupart des produits lisent bien plus qu'ils n'écrivent. Deux outils s'attaquent aux lectures :
- Les réplicas de lecture copient les données de la base principale de façon asynchrone et servent les requêtes de lecture.
- Un cache (Redis ou memcached) garde en mémoire les résultats chauds selon le motif cache-aside : lire dans le cache, et en cas d'échec lire la base puis alimenter le cache avec un TTL.
Nouveaux problèmes :
- Le retard de réplication. Un utilisateur modifie son profil, rafraîchit, et voit l'ancienne valeur parce que la lecture est allée sur un réplica. Envoyez vers la base principale les lectures d'un utilisateur pendant un court moment après son écriture (relire ses propres écritures), ou lisez les données critiques sur la principale.
- L'invalidation du cache et les ruées. Supprimez ou mettez à jour les clés de cache lors des écritures, utilisez les TTL comme filet de sécurité, et regroupez les échecs simultanés sur une même clé.
Quand passer à la suite : les utilisateurs lointains voient des pages lentes, ou les déploiements sont pénibles parce que les serveurs conservent de l'état.
Étape 5 : CDN et serveurs applicatifs sans état
- CDN. Servez images, scripts, feuilles de style et vidéo depuis des points de présence proches des utilisateurs. L'origine ne sert plus que les réponses dynamiques.
- Serveurs sans état. Les sessions passent dans un magasin partagé (Redis ou jetons signés), les fichiers envoyés vont dans un stockage objet, et rien d'important ne vit sur le disque d'un serveur applicatif. N'importe quel serveur peut traiter n'importe quelle requête : l'autoscaling et les déploiements deviennent routiniers.
Nouveau problème : les en-têtes de cache et l'invalidation des fichiers statiques. Ajoutez une empreinte aux noms de fichiers (app.3f9c1.js) pour ne jamais avoir à purger.
Quand passer à la suite : les requêtes sont lentes parce qu'elles font du travail lent en ligne (envoi d'e-mails, redimensionnement d'images, appels à des tiers).
Étape 6 : files et workers
Sortez du chemin de la requête le travail lent ou sujet aux échecs. La requête écrit un message et répond ; des workers le traitent.
Nouveaux problèmes : réessais et idempotence (un message peut être livré deux fois), ordre (au mieux au sein d'une partition) et visibilité (un arriéré est invisible si on ne le trace pas). Une file de lettres mortes et des alertes sur la profondeur des files sont indispensables.
Quand passer à la suite : la panne d'une seule région serait un désastre pour l'entreprise, ou les utilisateurs éloignés subissent une latence inacceptable sur les requêtes dynamiques.
Étape 7 : plusieurs régions
Faites tourner la pile dans deux régions ou plus, avec du GeoDNS ou de l'anycast qui envoie chaque utilisateur vers la région saine la plus proche.
| Modèle | Fonctionnement | Coût |
|---|---|---|
| Actif-passif | Une région sert le trafic ; l'autre est un secours tiède avec des données répliquées | La bascule prend des minutes et doit être répétée ; des écritures récentes peuvent être perdues |
| Actif-actif, partitionné | Les données de chaque utilisateur ont une région d'attache ; les deux régions servent du trafic | Logique de routage et de placement des données ; requêtes inter-régions pour les données partagées |
| Actif-actif, données globales | Chaque région accepte des écritures sur les données partagées | Résolution de conflits, ou base globalement cohérente avec une latence d'écriture plus élevée |
Nouveau problème : les données. Les couches sans état se répliquent sans effort ; les bases, non. Choisissez le modèle en vous demandant ce qu'il advient d'une écriture faite une seconde avant la panne d'une région.
Quand passer à la suite : la base principale ne peut plus absorber la charge d'écriture, même sur la plus grosse machine disponible.
Étape 8 : partitionner la base principale
Avant de partitionner, épuisez les options moins chères : une machine plus grosse, l'optimisation des requêtes et des index, le déplacement des fonctionnalités gourmandes en écritures vers des bases séparées par domaine (fédération), et l'archivage des données froides. Le partitionnement est la dernière étape, et pour cause.
Quand vous partitionnez, répartissez les lignes sur de nombreuses bases selon une clé de partition :
- Choisissez la clé d'après le motif d'accès dominant. Un SaaS multi-locataire partitionne par locataire ; une application sociale, souvent par utilisateur. Les requêtes qui incluent la clé ne touchent qu'une partition.
- Évitez les partitions chaudes. Hachez la clé plutôt que d'utiliser des plages de temps ou des identifiants séquentiels.
- Prévoyez le repartitionnement dès le premier jour. Utilisez de nombreuses partitions logiques réparties sur moins de bases physiques, pour que grandir signifie déplacer des partitions logiques et non rehacher chaque ligne (voir le hachage cohérent).
Nouveaux problèmes : les requêtes et transactions entre partitions deviennent du code applicatif, les contraintes d'unicité entre partitions exigent un schéma d'identifiants global (générateur d'identifiants uniques), et l'exploitation se multiplie par le nombre de partitions.
La destination, pour référence
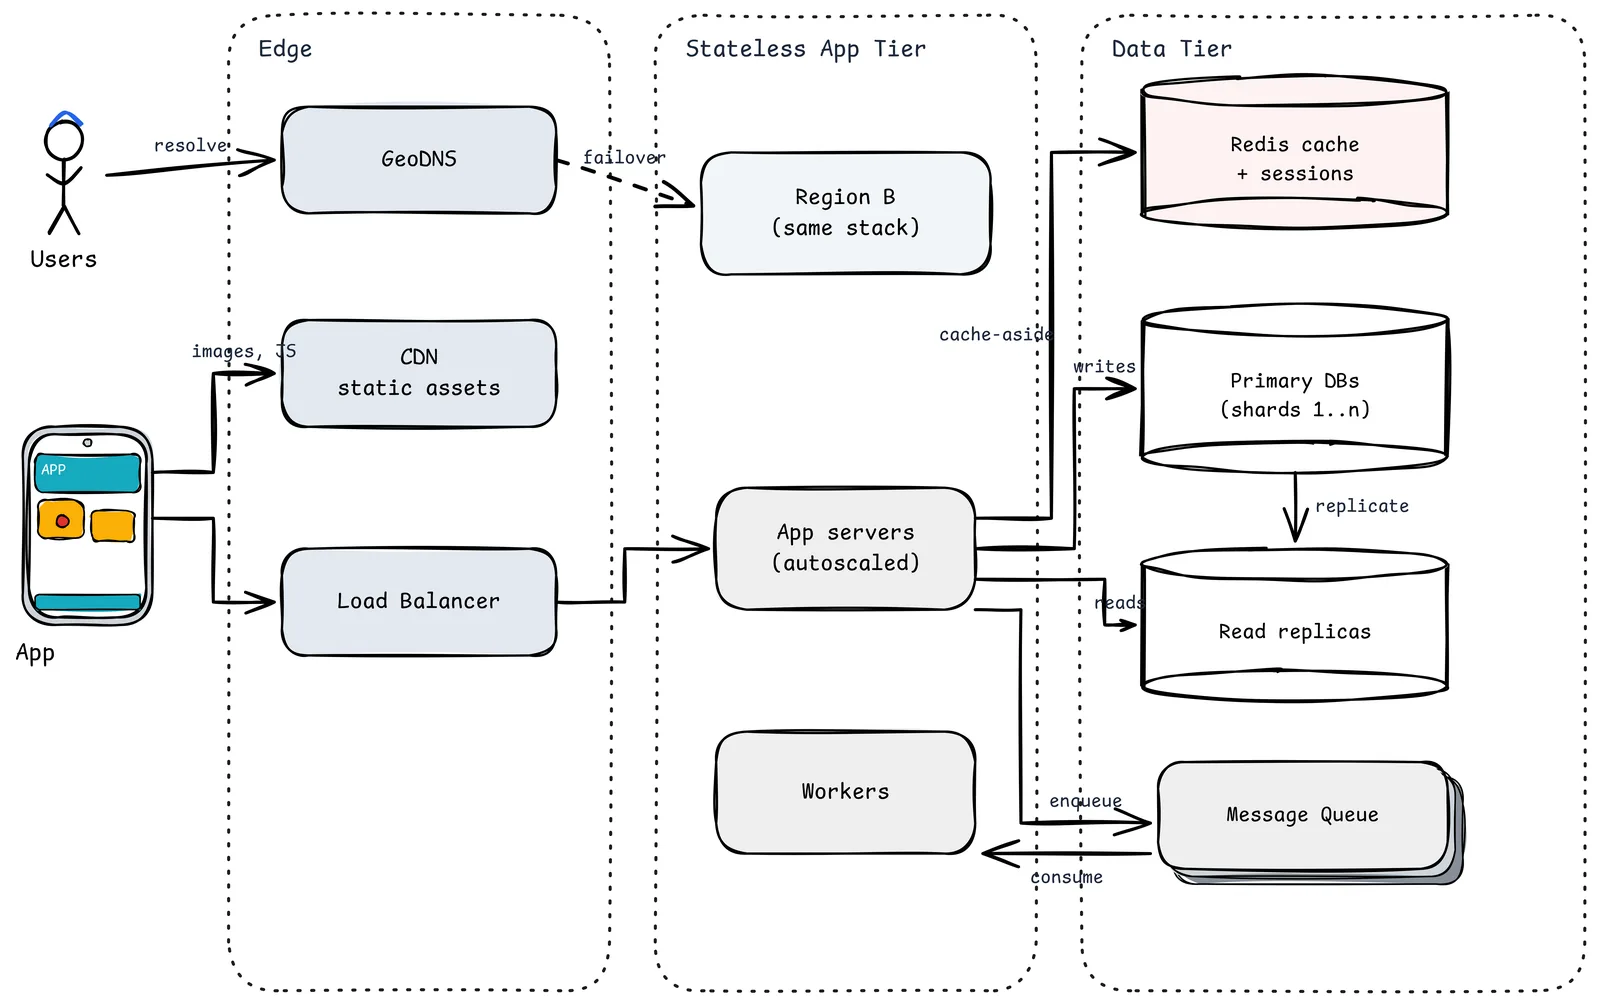
- GeoDNS envoie les utilisateurs vers la région saine la plus proche et bascule vers la Région B.
- CDN sert les fichiers statiques depuis la périphérie.
- Load Balancer répartit les requêtes entre des App servers sans état et autoscalés.
- Redis conserve les entrées de cache et les sessions.
- Primary DBs (partitions 1..n) reçoivent les écritures ; Read replicas reçoivent le trafic de lecture.
- Message Queue et Workers gèrent tout ce qui n'a pas besoin d'être terminé avant la réponse.
C'est là que finissent beaucoup de grands produits. C'est un très mauvais endroit pour commencer.
Quoi mesurer pour savoir quand avancer
| Signal | Suggère |
|---|---|
| CPU applicatif élevé en pic, base correcte | Ajouter des serveurs applicatifs (étape 3) |
| CPU ou E/S de la base élevés, surtout en lecture | Réplicas et cache (étape 4) |
| p99 élevé pour les utilisateurs éloignés de votre région | CDN (étape 5), puis régions (étape 7) |
| Latence dominée par les appels externes | Files et workers (étape 6) |
| Débit d'écriture ou stockage de la principale proche de la limite après optimisation | Fédération, puis partitionnement (étape 8) |
Ce qui reste
L'architecture la plus coûteuse est celle que vous avez construite pour un trafic que vous n'avez pas. La deuxième plus coûteuse est celle qui tombe le jour où le trafic arrive.
Le chemin entre les deux est ennuyeux : quelques tableaux de bord, une liste écrite des trois prochaines étapes, et la discipline de n'en franchir une que lorsqu'un graphique vous le demande. Le schéma impressionnant sera toujours là quand vous en aurez besoin.
Sources
- Nick Craver : Stack Overflow, The Architecture (2016 Edition)
- Instagram Engineering : What Powers Instagram
- AWS Well-Architected Framework : pilier fiabilité (motifs multi-régions)
- Martin Fowler : CQRS et modèles de lecture
- Dans la même série : Estimations au dos de l'enveloppe, Concevoir le hachage cohérent, Motifs de cache avec Redis