TL;DR
- Le problème : Des dizaines de services internes veulent parler aux utilisateurs. Sans plateforme partagée, chacun intègre APNs, un fournisseur d'e-mail et une passerelle SMS de son côté, ignore les préférences à sa manière, et réessaie jusqu'à ce que l'utilisateur reçoive trois fois le même message.
- La conception : Une Notification API unique accepte les requêtes avec une clé d'idempotence, vérifie préférences, contacts et heures de silence, et répartit vers des files par canal. Les workers de chaque canal rendent les modèles, appellent les fournisseurs, réessaient les échecs transitoires avec délai et jitter, envoient le reste en file de lettres mortes et nettoient les jetons invalides. Les accusés des fournisseurs alimentent un journal de livraison.
- Le résultat : Une livraison « au moins une fois » qui paraît « exactement une fois » à l'utilisateur, des canaux qui tombent indépendamment, des campagnes incapables de bloquer une réinitialisation de mot de passe, et un seul endroit pour répondre à « l'utilisateur l'a-t-il reçu ? ».
Les notifications sont la partie d'un produit qui sort du produit. Elles atterrissent sur l'écran verrouillé et dans la boîte de réception, au milieu de tout ce qui se dispute l'attention. Ratez-les et les utilisateurs ne signalent pas de bug : ils coupent les notifications, et vous perdez le canal pour toujours.
Cet article conçoit la plateforme partagée qui se trouve entre « une commande a été expédiée » et « un téléphone a vibré ».
Les exigences
Fonctionnelles
- Canaux : push mobile (iOS et Android), e-mail, SMS et, en option, notifications dans l'application.
- Les producteurs envoient un événement porteur de sens (« commande expédiée », « réinitialisation du mot de passe »), pas un message déjà mis en forme.
- Respecter les préférences par catégorie et par canal, les désabonnements et les heures de silence.
- Des modèles par type de notification et par langue.
- Un statut de livraison par notification, consultable par les équipes de support.
Non fonctionnelles
- Les messages transactionnels (réinitialisation de mot de passe, alertes de sécurité) sont livrés en quelques secondes, même en plein envoi marketing massif.
- Ne jamais envoyer deux fois la même notification au même utilisateur à cause d'un réessai interne.
- Canaux et fournisseurs tombent indépendamment : une panne du fournisseur SMS ne doit pas retarder les push.
Chiffres : 50 M de notifications lors d'une journée normale, c'est environ 600 par seconde en moyenne, mais une campagne marketing vers 30 M d'utilisateurs programmée à 9 heures peut exiger des dizaines de milliers par seconde pendant un moment. Concevez pour le pic, et isolez-le.
L'architecture
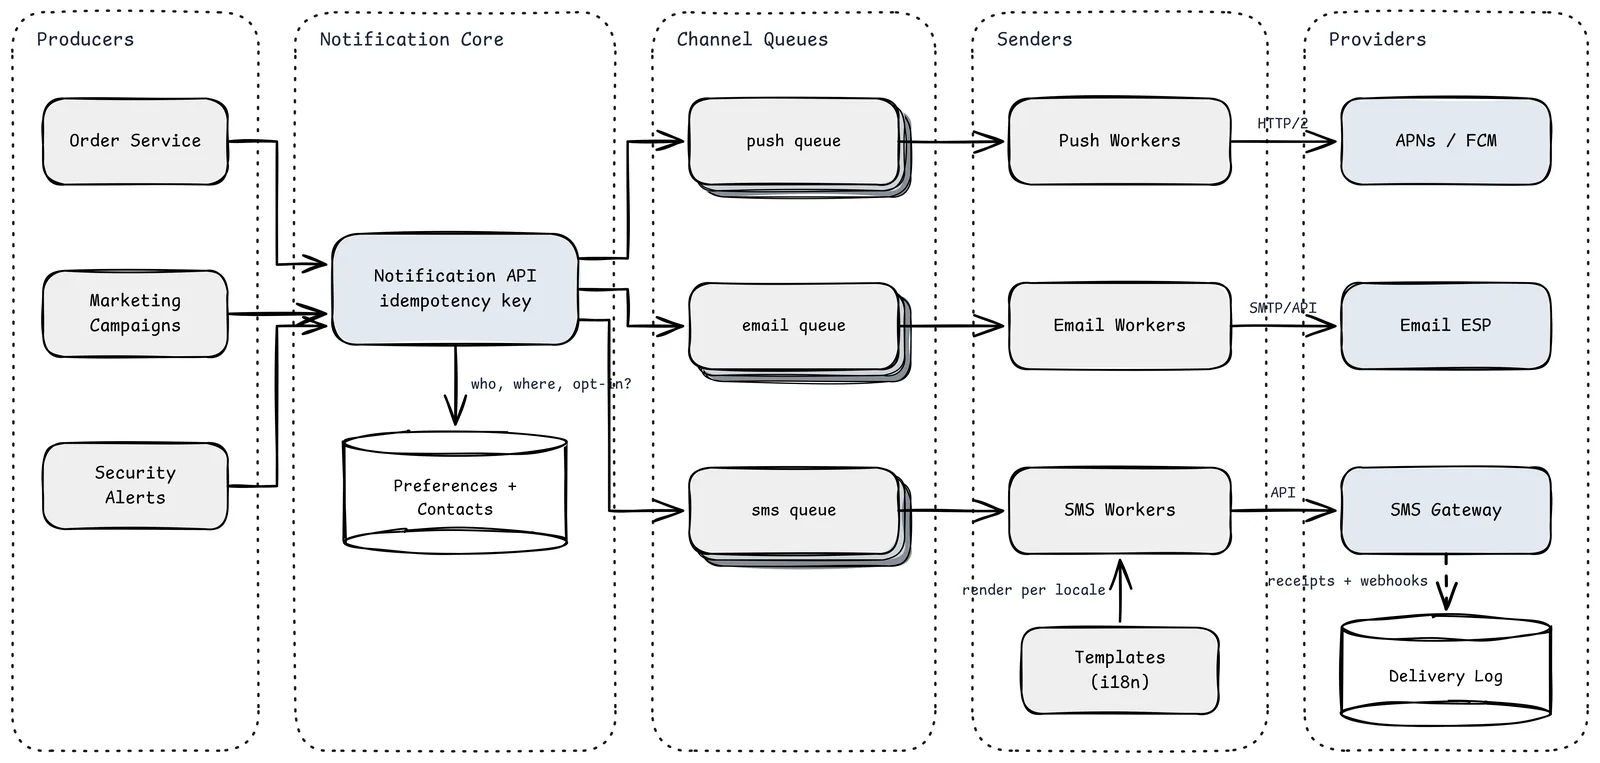
- Producteurs (Order Service, Marketing Campaigns, Security Alerts). Ils appellent une seule API avec un type d'événement, un destinataire et des données. Ils ne parlent jamais directement à APNs ou Twilio.
- Notification API (clé d'idempotence). Valide la requête, rejette les doublons par clé d'idempotence (par exemple
order-8812:shipped), attribue une classe de priorité et décide des canaux concernés. - Preferences + Contacts. Consentements par catégorie et canal, désabonnements, heures de silence et fuseau horaire, ainsi que jetons d'appareils, adresses e-mail vérifiées et numéros de téléphone. Les désabonnements imposés par la loi (e-mail marketing, SMS) sont vérifiés ici, à chaque fois.
- Channel Queues (push, email, sms). Une file par canal et, en pratique, des files haute priorité et envoi massif séparées par canal, pour qu'une campagne ne passe jamais devant une réinitialisation de mot de passe.
- Senders (workers push, e-mail et SMS). Prennent les tâches, rendent le modèle, appellent le fournisseur, enregistrent le résultat et appliquent la politique de réessai décrite plus bas.
- Templates (i18n). Des modèles versionnés par type de notification et par langue. Le rendu se fait à l'envoi, donc une coquille corrigée s'applique aussi aux messages encore en file.
- Providers (APNs / FCM, fournisseur d'e-mail, passerelle SMS). Des systèmes externes avec leurs propres limites, codes d'erreur et pannes. Encapsulez chacun dans un adaptateur pour pouvoir ajouter un second fournisseur de secours.
- Delivery Log. Chaque tentative et chaque accusé ou webhook du fournisseur (livré, rejeté, ouvert, désabonné) y est consigné. Le support peut répondre « a-t-elle reçu le code ? » sans fouiller les journaux.
Un événement de bout en bout : « commande expédiée »
- Le service de commandes appelle
POST /notificationsavectype=order_shipped,user_id=42, les données de suivi etidempotency_key=order-8812:shipped. - L'API vérifie la clé. Si elle l'a vue ces derniers jours, elle renvoie le résultat d'origine. Les réessais du service de commandes deviennent inoffensifs.
- Les préférences indiquent que l'utilisateur 42 veut les avis d'expédition par push et e-mail, pas par SMS. Il est 2 heures du matin dans son fuseau, mais les avis d'expédition sont permis pendant les heures de silence sous forme de push « silencieux ».
- L'API met en file une tâche push et une tâche e-mail, toutes deux haute priorité et porteuses de la clé d'idempotence.
- Le worker push rend le modèle localisé, envoie à chaque jeton d'appareil actif via APNs ou FCM et journalise la réponse. Le worker e-mail rend le modèle HTML et le confie au fournisseur d'e-mail.
- Plus tard, les webhooks du fournisseur signalent « livré » pour l'e-mail et, via l'accusé de l'application elle-même, « affiché » pour le push. Le journal de livraison contient tout l'historique.
Réessais, lettres mortes et illusion du « exactement une fois »
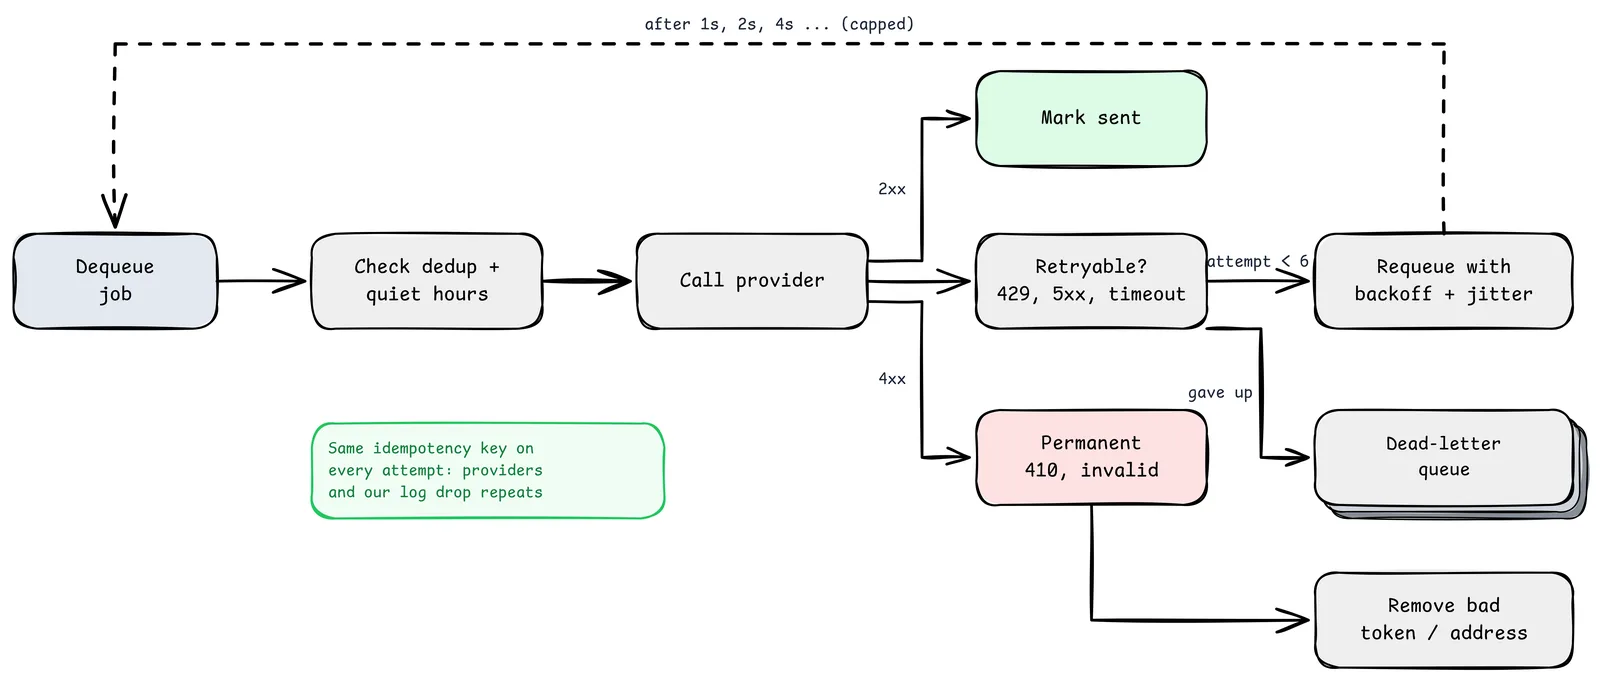
Les systèmes distribués livrent au moins une fois. L'astuce consiste à donner à l'utilisateur l'impression d'un « exactement une fois » :
- Classez les erreurs. Réessayez la limitation (429), les erreurs serveur (5xx) et les délais dépassés. Ne réessayez pas les erreurs permanentes : APNs répond
410 Unregisteredpour les jetons qui ne sont plus valides, et les fournisseurs d'e-mail signalent les rebonds définitifs. Les réessayer ne fait qu'abîmer votre réputation d'expéditeur. - Délai avec jitter. 1 s, 2 s, 4 s, avec de l'aléa et un plafond. Sans jitter, toutes les tâches en échec réessaient au même instant et martèlent un fournisseur déjà en difficulté.
- Tentatives limitées, puis lettres mortes. Une fois la limite atteinte, la tâche part dans une file de lettres mortes avec l'erreur jointe. Quelqu'un ou quelque chose doit regarder cette file ; une DLQ que personne ne lit n'est qu'une façon plus lente de perdre des messages.
- La même clé d'idempotence à chaque tentative. Le worker consulte le journal de livraison avant d'envoyer, et de nombreux fournisseurs acceptent aussi une clé d'idempotence. Un crash entre « le fournisseur a accepté » et « nous l'avons enregistré » ne provoque alors aucun doublon.
- Nettoyez. Supprimez immédiatement les jetons push morts et bloquez les e-mails en rebond définitif, sinon chaque envoi futur vers cet utilisateur gaspille une tentative.
Les réalités de chaque canal
| Canal | Coût | Latence | Pièges |
|---|---|---|---|
| Push (APNs, FCM) | Quasiment gratuit | Secondes | Les jetons tournent et expirent ; charge utile limitée à environ 4 Ko ; le système peut limiter ou abandonner les push de faible priorité ; Google a retiré en 2024 les anciennes API de FCM au profit de HTTP v1 |
| Fractions de centime | De quelques secondes à quelques minutes | La délivrabilité, c'est la réputation : SPF, DKIM et DMARC sont obligatoires ; depuis 2024, Gmail et Yahoo exigent des expéditeurs en masse un désabonnement en un clic et un faible taux de plaintes pour spam | |
| SMS | Quelques centimes par message, selon le pays | Secondes | Coûteux à grande échelle ; enregistrement auprès des opérateurs (10DLC aux États-Unis) et règles de consentement ; identifiants d'expéditeur différents selon les pays |
| Dans l'application | Gratuit | Instantané si connecté | Ne marche qu'avec l'application ouverte ; souvent stocké comme une boîte de réception et synchronisé |
La colonne des coûts dicte la politique de routage. Un code OTP peut valoir un SMS. Un « votre ami a publié » non.
Protéger les utilisateurs de votre propre entreprise
Les exigences les plus difficiles ne sont pas techniques :
- Des plafonds de fréquence. Pas plus de N push marketing par utilisateur et par jour, appliqués de façon centrale, quel que soit le nombre d'équipes qui veulent envoyer.
- Des heures de silence dans le fuseau de l'utilisateur, avec des exceptions explicites pour la sécurité et les messages transactionnels.
- Regrouper et résumer. Dix mentions « j'aime » en cinq minutes doivent donner une notification, pas dix. Les fournisseurs de push prennent en charge des clés de regroupement ; votre plateforme doit gérer des fenêtres de regroupement.
- Un désabonnement est un désabonnement. Le magasin de préférences est l'unique source de vérité, et chaque canal le consulte au moment de l'envoi, pas au moment où la campagne a été programmée.
Les métriques qui comptent
| Métrique | Pourquoi |
|---|---|
| Délai entre l'événement et l'acceptation par le fournisseur, par priorité | Montre si le trafic de masse retarde les messages transactionnels |
| Taux d'erreur des fournisseurs par code | Sépare vos bugs (4xx) de leurs pannes (5xx) |
| Profondeur et ancienneté de la DLQ | Les messages que vous n'avez pas livrés, en silence |
| Taux de jetons invalides et de rebonds définitifs | Hygiène des données de contact |
| Taux de désabonnement après chaque campagne | La seule mesure honnête de l'envie des gens de recevoir ce que vous envoyez |
Liste de contrôle pour la production
- Une seule API pour tous les producteurs ; aucune intégration directe des fournisseurs ailleurs
- Clés d'idempotence obligatoires sur chaque requête et réutilisées à chaque réessai
- Préférences, désabonnements et heures de silence vérifiés au moment de l'envoi
- Files haute priorité et envoi massif séparées pour chaque canal
- Classification des réessais, délai avec jitter, limite de tentatives et DLQ surveillée
- Jetons invalides et rebonds définitifs supprimés automatiquement
- SPF, DKIM, DMARC et désabonnement en un clic pour l'e-mail
- Plafonds de fréquence et regroupement ou résumé pour les événements bruyants
- Journal de livraison consultable par le support, accusés des fournisseurs inclus
- Fournisseur secondaire configuré pour les canaux critiques
Ce qui reste
Le meilleur système de notifications, c'est celui que les utilisateurs remarquent à peine : le code arrive quand ils l'ont demandé, l'avis de colis arrive quand le colis bouge, et rien n'arrive à 3 heures du matin qui aurait pu attendre.
Cette retenue est un choix de conception, pas un réglage par défaut. Chaque équipe qui livre une fonctionnalité voudra sa notification. La plateforme est l'endroit où quelqu'un peut dire « mets-la dans le résumé du jour », et avoir raison.
Sources
- Apple : Sending notification requests to APNs (codes de statut, dont le 410)
- Firebase Cloud Messaging : migrer des anciennes API vers HTTP v1
- Google : consignes pour les expéditeurs d'e-mails (exigences pour les envois en masse)
- RFC 8058 : Signaling one-click functionality for list email headers
- AWS Architecture Blog : Exponential backoff and jitter
- Dans la même série : Concevoir un système de chat, Concevoir un limiteur de débit, L'architecture orientée événements