TL;DR
- Le problème : Stocker des milliards de petites valeurs derrière
put(key, value)etget(key), sur de nombreuses machines, en restant disponible en écriture quand certaines tombent, avec une latence prévisible de quelques millisecondes.- La conception : Partitionner les clés sur un anneau de hachage cohérent, répliquer chaque clé sur N nœuds et laisser les clients choisir W et R par requête. Accepter les écritures pendant les pannes grâce aux quorums relâchés et au hinted handoff, réparer la dérive par read repair et arbres de Merkle, détecter les pannes par gossip, et stocker les données de chaque nœud dans un arbre LSM.
- Le résultat : Un système qui échange un peu de cohérence contre de la disponibilité, de façon contrôlée et réglable. C'est la conception derrière l'article Dynamo d'Amazon, Cassandra et Riak, et le modèle mental derrière DynamoDB.
Un magasin clé-valeur a la plus petite API de toute cette série : deux verbes. C'est précisément pour cela que c'est une bonne question d'entretien. Sans rien derrière quoi se cacher, chaque décision porte sur la distribution : où vivent les données, combien de copies existent, que se passe-t-il quand une copie manque, et ce que signifie même « la valeur actuelle » quand deux machines ne sont pas d'accord.
Cet article construit un magasin de type Dynamo, parce que cette conception oblige à affronter explicitement chacune de ces questions.
Les exigences
- API :
put(key, value),get(key), et éventuellementdelete(key). Des valeurs jusqu'à environ 1 Mo ; la plupart sous 10 Ko. - Échelle : des dizaines de téraoctets, des centaines de milliers d'opérations par seconde.
- La disponibilité d'abord : les écritures doivent réussir même quand quelques nœuds ou une zone de disponibilité entière sont injoignables. Les paniers d'achat et les magasins de sessions sont les exemples classiques : perdre une écriture est pire que lire brièvement une ancienne valeur.
- Une cohérence réglable : certains appelants ont besoin de relire ce qu'ils viennent d'écrire ; d'autres acceptent volontiers une valeur légèrement périmée en échange d'une latence plus faible.
- L'exploitabilité : ajouter et retirer des nœuds sans interruption ; se remettre automatiquement de la perte d'un disque.
Esquisse de capacité : 20 To de données avec un facteur de réplication de 3, cela fait 60 To sur disque. Avec des nœuds d'environ 2 To chacun, maintenus sous 60 % de remplissage pour laisser de la marge à la compaction, il faut environ 50 nœuds. Si chaque nœud sert confortablement 10 000 opérations par seconde, le cluster en sert environ 500 000 par seconde avant tout cache.
CAP, énoncé précisément
Le théorème CAP dit que pendant une partition réseau, un système doit choisir entre la cohérence (chaque lecture voit la dernière écriture) et la disponibilité (chaque requête adressée à un nœud vivant reçoit une réponse qui n'est pas une erreur). Sans partition, on peut avoir les deux.
PACELC ajoute la partie qu'on oublie : sinon, en l'absence de partition, on échange encore la latence contre la cohérence, car attendre davantage de réplicas prend plus de temps.
| Style de système | Pendant une partition | En temps normal | Exemples |
|---|---|---|---|
| CP | Refuse les requêtes du côté minoritaire | Cohérent, latence plus élevée | etcd, ZooKeeper, Spanner |
| AP | Continue d'accepter lectures et écritures partout | Réglable ; souvent cohérence à terme | Dynamo, Cassandra, Riak |
Cet article construit la variante AP, avec des réglages qui permettent aux appelants de se rapprocher de la cohérence quand ils en ont besoin.
Partitionnement et réplication
Les clés sont placées sur un anneau de hachage cohérent avec nœuds virtuels (voir l'article sur le hachage cohérent de cette série). La liste de préférence de chaque clé correspond aux N premiers nœuds physiques distincts dans le sens horaire à partir de sa position, répartis sur plusieurs zones de disponibilité. Avec N = 3, chaque clé a trois réplicas, et la perte d'un nœud ou d'une zone ne fait perdre aucune donnée.
N'importe quel nœud peut servir de coordinateur pour une requête. Les clients envoient leurs requêtes à n'importe quel nœud (qui les transmet si besoin), ou utilisent un client conscient des partitions qui envoie directement à un réplica, économisant un saut.
Les quorums : le réglage dont tout le monde parle
Pour chaque requête, le coordinateur envoie l'opération aux N réplicas et attend un sous-ensemble :
- W = le nombre de réplicas qui doivent confirmer une écriture pour qu'elle réussisse.
- R = le nombre de réplicas qui doivent répondre à une lecture pour qu'elle renvoie un résultat.
Si R + W > N, chaque quorum de lecture recoupe chaque quorum d'écriture sur au moins un réplica, donc une lecture verra au moins une copie de la dernière écriture réussie.
| N, W, R | Comportement | À utiliser quand |
|---|---|---|
| 3, 1, 1 | Le plus rapide, le plus faible ; les lectures peuvent facilement manquer des écritures récentes | Données de type cache, métriques |
| 3, 2, 2 | Quorums qui se recoupent ; tolère un réplica lent ou mort sur chaque chemin | Le réglage par défaut courant |
| 3, 3, 1 | Lectures rapides ; les écritures échouent si un réplica tombe | Données très lues qui changent rarement |
| 3, 1, 3 | Écritures rapides, lectures lentes | Journalisation très écrite et rarement lue |
Ce que les quorums ne garantissent pas. R + W > N n'est pas la linéarisabilité. Avec des écritures concurrentes, des horodatages « la dernière écriture gagne » et des quorums relâchés (voir plus bas), une lecture peut encore renvoyer une valeur plus ancienne ou une valeur écrasée ensuite. Designing Data-Intensive Applications de Martin Kleppmann reste l'explication la plus claire de ces cas limites. Si vous avez besoin d'une vraie sémantique compare-and-set, il vous faut un protocole de consensus (Paxos, Raft) ou une écriture conditionnelle, pas un quorum plus grand.
Le chemin d'écriture quand un réplica est en panne
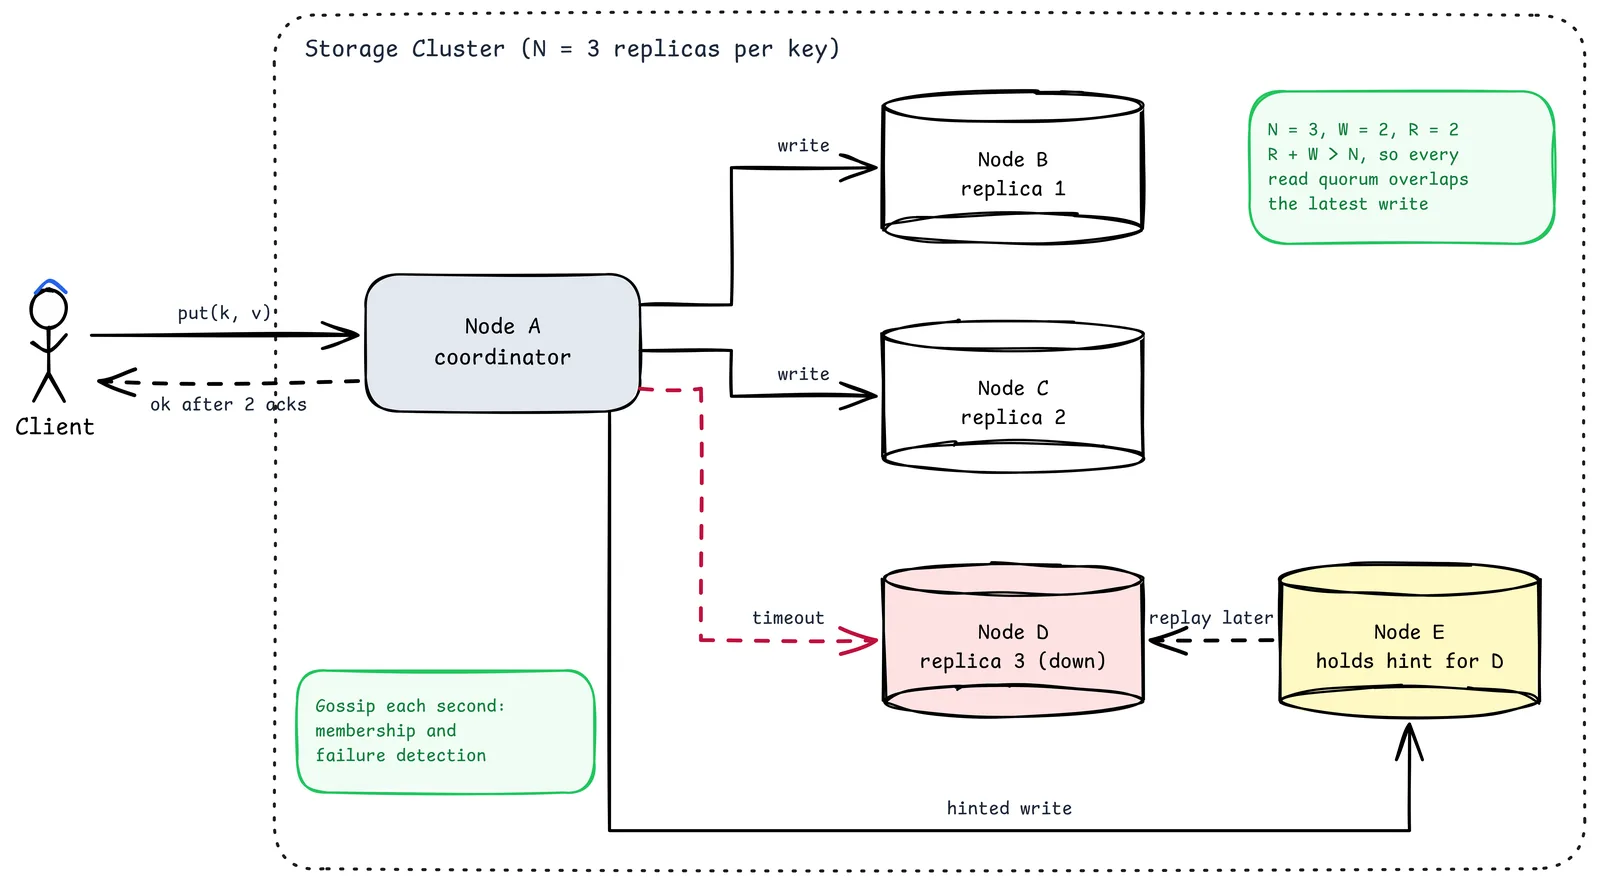
- Client. Envoie
put(k, v)avec le niveau de cohérence de son choix. - Node A (coordinateur). Transmet l'écriture à la liste de préférence de la clé et répond dès que W réplicas ont confirmé. Il n'attend pas le réplica le plus lent.
- Nodes B et C (réplicas 1 et 2). Confirment. Avec W = 2, le client obtient le succès à ce stade.
- Node D (réplica 3, en panne). L'écriture expire. Avec un quorum strict, le coordinateur ne compterait que B et C et poursuivrait.
- Node E (détient l'indice pour D). Avec un quorum relâché, le coordinateur écrit la copie de D sur le nœud sain suivant de l'anneau, marquée d'un indice indiquant « ceci appartient à D ». La durabilité reste ainsi à trois copies pendant la panne.
- Rejeu ultérieur. Quand le gossip signale le retour de D, E lui transmet les écritures indicées puis les supprime. C'est le hinted handoff.
- Gossip. Chaque seconde, chaque nœud échange son état d'appartenance et ses battements de cœur avec quelques pairs pris au hasard. Cassandra ajoute un détecteur de pannes phi accrual, qui produit un niveau de suspicion plutôt qu'un simple vivant ou mort, pour qu'un réseau lent ne déclare pas instantanément des nœuds morts.
La note verte énonce la règle de recoupement. Le prix des quorums relâchés, c'est que pendant un temps, les « W nœuds » qui ont confirmé ne sont pas forcément les vrais nœuds de la clé ; c'est l'une des raisons pour lesquelles les quorums seuls ne garantissent pas une cohérence forte.
Quand les réplicas divergent
Les réplicas dérivent : un nœud manque des écritures pendant une panne plus longue que la fenêtre d'indices, un disque est remplacé, le réseau vacille. Trois mécanismes les réconcilient :
- Read repair. Quand une lecture avec R > 1 voit des versions différentes, le coordinateur renvoie la plus récente et la réécrit sur les réplicas en retard.
- L'anti-entropie par arbres de Merkle. Chaque nœud construit un arbre de hachages sur ses plages de clés. Deux réplicas comparent leurs hachages racines et ne descendent que dans les sous-arbres qui diffèrent, ce qui leur permet de trouver quelques clés divergentes parmi des milliards en échangeant très peu de données. Cassandra l'exécute via
nodetool repair. - Le hinted handoff, vu plus haut, pour les pannes courtes.
Quelle version gagne ? Il faut une règle :
| Stratégie | Fonctionnement | Coût |
|---|---|---|
| La dernière écriture gagne (LWW) | L'horodatage le plus élevé l'emporte | Simple, mais les écritures concurrentes perdent des données en silence ; dépend de la synchronisation des horloges |
| Horloges vectorielles | Chaque version porte des compteurs par nœud ; les versions concurrentes sont conservées comme sœurs | Pas de perte silencieuse, mais l'application doit fusionner les sœurs (le panier de Dynamo le faisait) |
| CRDT | Types de données dont la fusion est sans conflit par construction (compteurs, ensembles, tables) | Élégants quand ils conviennent ; tous les types de données n'ont pas de CRDT naturel |
Cassandra utilise LWW par colonne. Le Dynamo original utilisait des horloges vectorielles et déléguait la fusion à l'application. DynamoDB propose des écritures conditionnelles pour que les applications évitent les conflits plutôt que de les résoudre.
Les suppressions sont des écritures. Une suppression écrit une pierre tombale, un marqueur indiquant « cette clé a été supprimée à l'instant T ». Les pierres tombales doivent vivre plus longtemps que la plus longue panne possible d'un réplica, sinon un réplica qui a manqué la suppression ressuscitera la valeur pendant la réparation. Le gc_grace_seconds de Cassandra (10 jours par défaut) existe précisément pour cela.
Dans un nœud : le moteur de stockage LSM
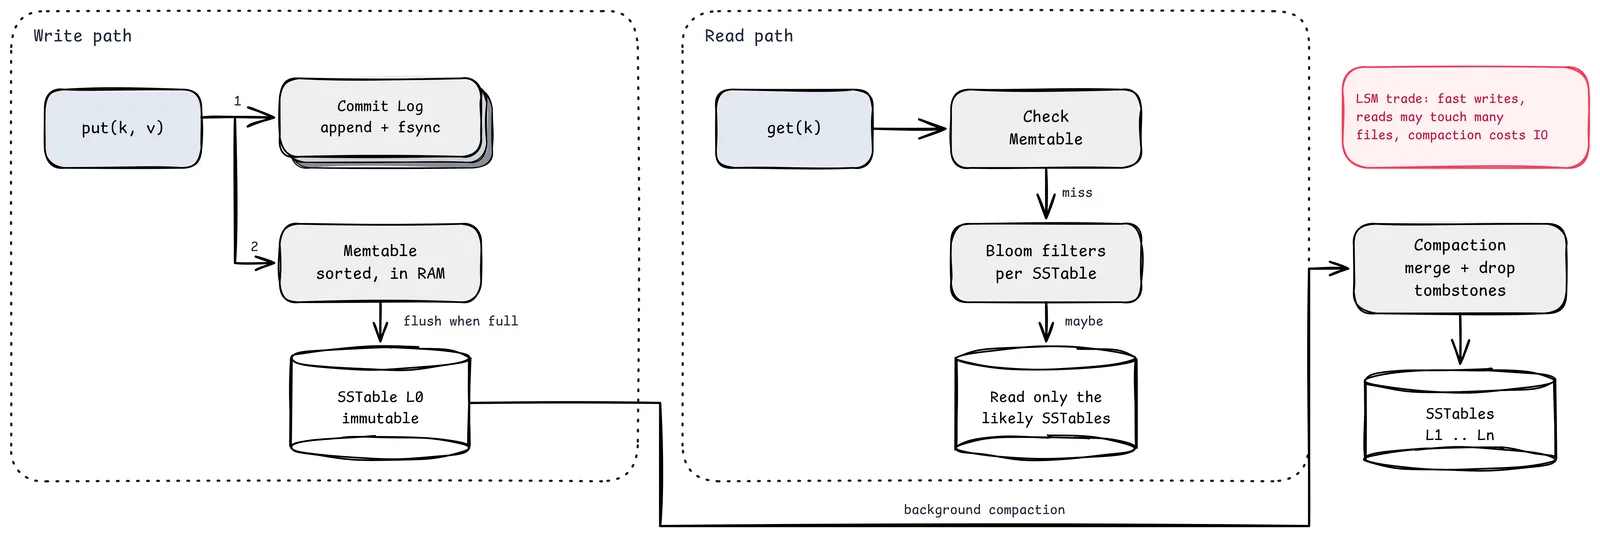
La plupart des magasins de type Dynamo utilisent un arbre LSM (log-structured merge tree), la conception derrière LevelDB, RocksDB et le moteur de stockage de Cassandra.
Le chemin d'écriture
- Ajouter l'écriture au commit log et faire un fsync (ou une validation groupée), pour qu'elle survive à un crash.
- L'insérer dans le memtable, une structure triée en mémoire.
- Quand le memtable est plein, le vider sur disque sous forme de SSTable, un fichier trié immuable. Les écritures ne modifient jamais un fichier en place, ce qui les rend séquentielles et rapides.
Le chemin de lecture
- Consulter le memtable.
- Pour chaque SSTable, interroger son filtre de Bloom, une structure probabiliste compacte qui répond « certainement pas ici » ou « peut-être ici ». Un filtre bien dimensionné écarte l'immense majorité des fichiers qui ne contiennent pas la clé.
- Ne lire que les SSTables susceptibles de la contenir, de la plus récente à la plus ancienne.
La compaction tourne en arrière-plan : elle fusionne les SSTables et élimine les valeurs écrasées et les pierres tombales expirées. La compaction par paliers de taille favorise le débit d'écriture ; la compaction par niveaux favorise la latence de lecture et l'espace, au prix d'une amplification d'écriture plus forte.
| Arbre LSM | B-tree | |
|---|---|---|
| Écritures | Séquentielles, rapides | Mises à jour de pages en place, E/S aléatoires |
| Lectures | Peuvent toucher plusieurs fichiers ; les filtres de Bloom aident | Un seul parcours d'arbre |
| Espace | Duplication temporaire jusqu'à la compaction | Fragmentation avec le temps |
| Moteurs typiques | RocksDB, LevelDB, Cassandra | InnoDB, PostgreSQL, BoltDB |
Des scénarios de panne à raconter
| Événement | Ce que fait le système |
|---|---|
| Un nœud tombe pendant 5 minutes | Les écritures en quorum relâché vont au nœud suivant avec des indices ; le hinted handoff rejoue au retour |
| Le disque d'un nœud meurt définitivement | On remplace le nœud ; ses plages sont transférées depuis les autres réplicas ; la réparation Merkle vérifie |
| Une zone de disponibilité est isolée | Avec des réplicas répartis sur plusieurs zones et W = 2, les écritures continuent côté majoritaire ; le côté minoritaire peut encore accepter des écritures en quorum relâché, à réconcilier ensuite |
| Une horloge décalée sur un nœud | Avec LWW, ses écritures peuvent gagner ou perdre à tort. Surveillez le décalage d'horloge et alertez |
| Une clé chaude | Les réplicas de cette clé sont surchargés ; le partitionnement n'y peut rien. Mettez-la en cache ou repensez la clé |
Aide-mémoire des réglages
| Réglage | Valeur typique | À augmenter pour | À baisser pour |
|---|---|---|---|
| Facteur de réplication N | 3 | Durabilité, capacité de lecture | Coût de stockage |
| Quorum d'écriture W | 2 | Durabilité à la confirmation | Latence d'écriture, disponibilité |
| Quorum de lecture R | 2 | Lectures plus fraîches | Latence de lecture |
| Fenêtre d'indices | 3 heures | Couvrir des pannes plus longues par handoff | Disque consommé par les indices |
| Délai de grâce des pierres tombales | 10 jours | Sécurité contre la résurrection | Espace et coût de lecture des pierres tombales |
Liste de contrôle pour la production
- Réplicas répartis sur plusieurs zones de disponibilité, pas seulement sur plusieurs nœuds
- Niveau de cohérence par défaut choisi par table et documenté pour les appelants
- Stratégie de conflit explicite (LWW avec horloges surveillées, horloges vectorielles ou CRDT)
- Fenêtre de hinted handoff et calendrier de réparation alignés sur le délai de grâce des pierres tombales
- Réparation anti-entropie régulière en place et surveillée
- Taux de faux positifs des filtres de Bloom et nombre de SSTables par lecture suivis
- Stratégie de compaction choisie par charge ; disques sous ~60 % pour garder de la marge
- Tableaux de bord : p99 par opération et par niveau de cohérence, indices en attente, avancement des réparations, mutations abandonnées
Ce qui reste
Un magasin clé-valeur, c'est là où les systèmes distribués cessent d'être abstraits. Deux verbes, et pourtant toutes les questions difficiles surgissent : quelle copie est la vraie, combien de temps attendre, que faire du nœud absent pendant une heure qui a son avis sur le passé.
Les meilleures conceptions ne prétendent pas que ces questions ont une seule réponse. Elles donnent un réglage à l'appelant et écrivent, très clairement, ce que chaque position promet et ce qu'elle ne promet pas.
Sources
- DeCandia et al., « Dynamo: Amazon's Highly Available Key-value Store » (SOSP 2007)
- Lakshman et Malik, « Cassandra: A Decentralized Structured Storage System »
- O'Neil et al., « The Log-Structured Merge-Tree (LSM-Tree) » (1996)
- Documentation d'Apache Cassandra : hints, réparation et compaction
- Abadi, « Consistency Tradeoffs in Modern Distributed Database System Design » (PACELC)
- Hayashibara et al., « The Phi Accrual Failure Detector »
- Dans la même série : Concevoir le hachage cohérent, Concevoir un générateur d'identifiants uniques