TL;DR
- Le problème : Placer les clés avec
hash(key) % Nfonctionne tant que N ne change pas. Ajoutez un onzième nœud de cache à dix nœuds et environ 90 % des clés pointent soudain ailleurs, ce qui, pour un cache, signifie une avalanche d'échecs presque totale sur la base de données située derrière.- La conception : Projeter clés et serveurs sur le même espace circulaire. Une clé appartient au premier point de serveur rencontré dans le sens horaire. Donner à chaque serveur quelques centaines de nœuds virtuels pour équilibrer la charge, et continuer dans le sens horaire pour choisir des réplicas sur des serveurs distincts.
- Le résultat : Ajouter ou retirer un nœud déplace environ 1/N des clés. Dans un essai mesuré avec 10 nœuds et 200 nœuds virtuels chacun, le nœud le plus chargé portait 1,11 fois la moyenne, contre 2,3 fois avec un seul point par nœud.
La plupart des systèmes distribués doivent répondre des millions de fois par seconde à une question banale : quelle machine possède cette clé ? Caches, bases partitionnées, répartiteurs de charge qui veulent de l'affinité de session et magasins d'objets ont besoin d'une réponse rapide, sans annuaire central, qui ne s'effondre pas quand une machine arrive ou tombe.
Le hachage cohérent est la réponse classique. Il a été introduit par Karger et ses collègues en 1997 pour les caches web, popularisé par l'article Dynamo d'Amazon en 2007, et vit aujourd'hui dans Cassandra, dans les clients memcached, dans le répartiteur de charge d'Envoy et bien d'autres. Cet article explique son fonctionnement, mesure ce qu'apportent réellement les nœuds virtuels et passe en revue les alternatives parfois meilleures.
Pourquoi hash(key) % N casse
Le placement par modulo est parfaitement équilibré et parfaitement fragile. Une clé ne reste sur le même nœud lorsque N devient N+1 que si h % N == h % (N+1), ce qui arrive pour environ une clé sur N+1.
Je l'ai mesuré avec 200 000 clés :
| Changement | Clés déplacées |
|---|---|
De % 10 à % 11 |
90,7 % |
| Anneau de hachage cohérent, de 10 à 11 nœuds, 200 nœuds virtuels chacun | 9,0 % |
Pour un cache, 90 % de clés déplacées signifie que 90 % des lectures échouent d'un coup et retombent sur la base, généralement au moment précis où vous ajoutiez de la capacité parce que la charge était élevée. Pour une base partitionnée, cela signifie déplacer 90 % des données pour ajouter une machine. Aucun des deux n'est acceptable.
L'anneau
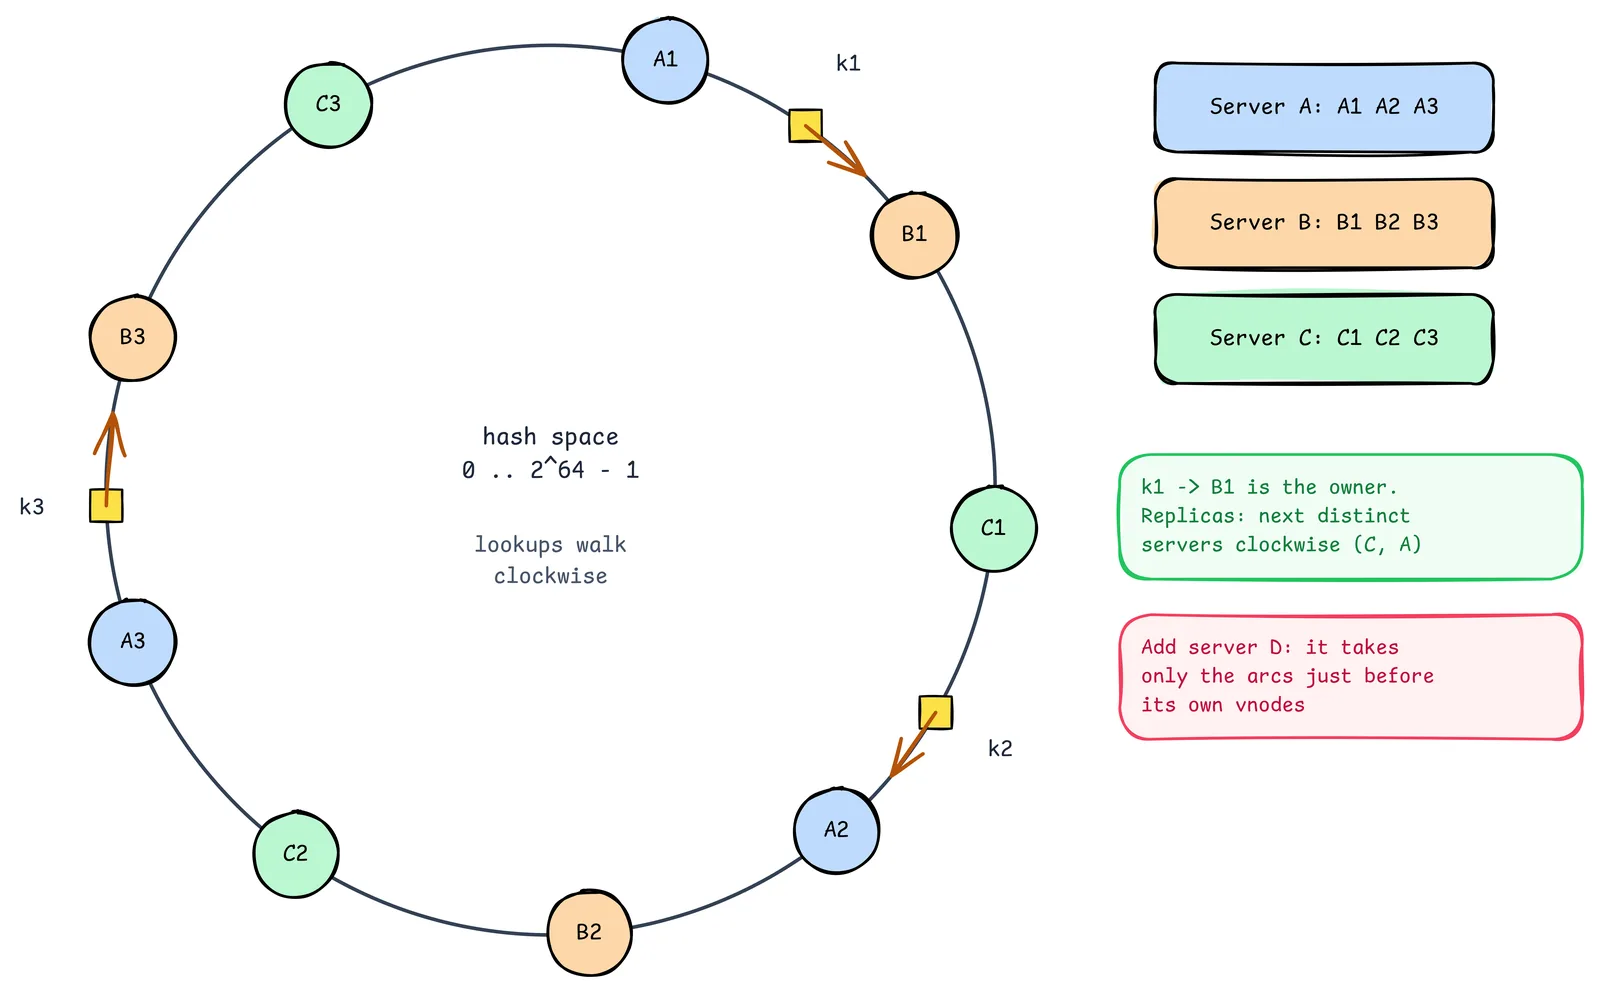
- L'espace de hachage. Choisissez une fonction de hachage à large sortie (64 bits suffisent) et traitez son intervalle comme un cercle : après la plus grande valeur vient zéro.
- Les serveurs sur l'anneau. Chaque serveur est projeté sur le cercle, en pratique de nombreuses fois, sous forme de nœuds virtuels (A1, A2, A3 sur le schéma).
- Les clés sur l'anneau. Chaque clé est projetée sur le même cercle.
- La propriété. Une clé appartient au premier nœud virtuel rencontré dans le sens horaire.
k1tombe juste avantB1, c'est donc le serveur B qui la possède. - L'arrivée. Un nouveau serveur D place ses nœuds virtuels sur l'anneau. Chacun ne récupère que l'arc entre lui et le point précédent. Tout le reste ne bouge pas.
- Le départ. Quand un serveur part, chacun de ses arcs est absorbé par le point suivant dans le sens horaire. Là encore, seules les clés de ce serveur bougent.
La recherche est une recherche dichotomique dans la liste triée des positions de nœuds virtuels : O(log V), V étant le nombre total de nœuds virtuels. Avec 100 serveurs et 200 nœuds virtuels chacun, c'est une recherche parmi 20 000 entiers, bien en dessous d'une microseconde.
import bisect, hashlib

def h(s: str) -> int:
    return int.from_bytes(hashlib.md5(s.encode()).digest()[:8], "big")

class Ring:
    def __init__(self, nodes, vnodes=200):
        self.vnodes, self.points, self.owner = vnodes, [], {}
        for n in nodes:
            self.add(n)

    def add(self, node):
        for i in range(self.vnodes):
            p = h(f"{node}#{i}")
            bisect.insort(self.points, p)
            self.owner[p] = node

    def remove(self, node):
        self.points = [p for p in self.points if self.owner[p] != node]
        self.owner = {p: n for p, n in self.owner.items() if n != node}

    def lookup(self, key):
        i = bisect.bisect(self.points, h(key)) % len(self.points)
        return self.owner[self.points[i]]
MD5 sert ici pour sa distribution, pas pour la sécurité. N'importe quel hachage rapide et bien mélangé convient ; en production on utilise souvent Murmur3 ou xxHash.
Nœuds virtuels : ce qu'ils apportent vraiment
Avec un seul point par serveur, les arcs ont des longueurs très différentes, si bien que certains serveurs possèdent bien plus d'anneau que d'autres. Les nœuds virtuels corrigent cela en moyennant de nombreux petits arcs. Même expérience, 200 000 clés réparties sur 10 serveurs :
| Nœuds virtuels par serveur | Plus chargé / moyenne | Moins chargé / moyenne |
|---|---|---|
| 1 | 2,30x | 0,12x |
| 10 | 1,46x | 0,69x |
| 200 | 1,11x | 0,92x |
L'anneau à un seul point est presque inutile : un serveur porte plus du double de sa part pendant qu'un autre reste presque inactif. À 200 nœuds virtuels, l'écart tourne autour de ±10 %.
Les nœuds virtuels apportent deux autres avantages :
- Une capacité pondérée. Un serveur doté de deux fois plus de mémoire reçoit deux fois plus de nœuds virtuels.
- Des pannes plus douces. Quand un serveur meurt, ses nombreux petits arcs sont absorbés par de nombreux successeurs différents, au lieu qu'un voisin malchanceux hérite de toute sa charge.
Le coût, c'est la mémoire de l'anneau et davantage de métadonnées à déplacer. Cassandra a longtemps utilisé 256 tokens par nœud par défaut ; la version 4.0 a abaissé cette valeur à 16, avec un algorithme d'allocation de tokens plus intelligent, car des valeurs très élevées rendaient les réparations et le streaming plus coûteux. Plus n'est pas gratuit.
La réplication sur l'anneau
Les systèmes de type Dynamo utilisent aussi l'anneau pour choisir les réplicas. Pour stocker une clé avec un facteur de réplication de 3, on avance dans le sens horaire depuis la clé et on prend les trois premiers serveurs physiques distincts, en sautant les nœuds virtuels supplémentaires d'un serveur déjà retenu. La note du schéma l'illustre pour k1 : B la possède, puis C et A en détiennent des réplicas.
Deux raffinements comptent en production :
- La prise en compte des racks ou des zones. « Serveurs distincts » devrait en réalité signifier « domaines de panne distincts ». Trois réplicas dans le même rack ne font qu'un seul réplica pendant une coupure de courant.
- Les listes de préférence. La liste ordonnée des candidats (les trois premiers nœuds sains dans le sens horaire) permet à un coordinateur de contourner un réplica temporairement indisponible ; c'est ainsi que fonctionnent les quorums relâchés et le hinted handoff dans Dynamo et Cassandra.
Un cluster de cache bâti sur l'anneau
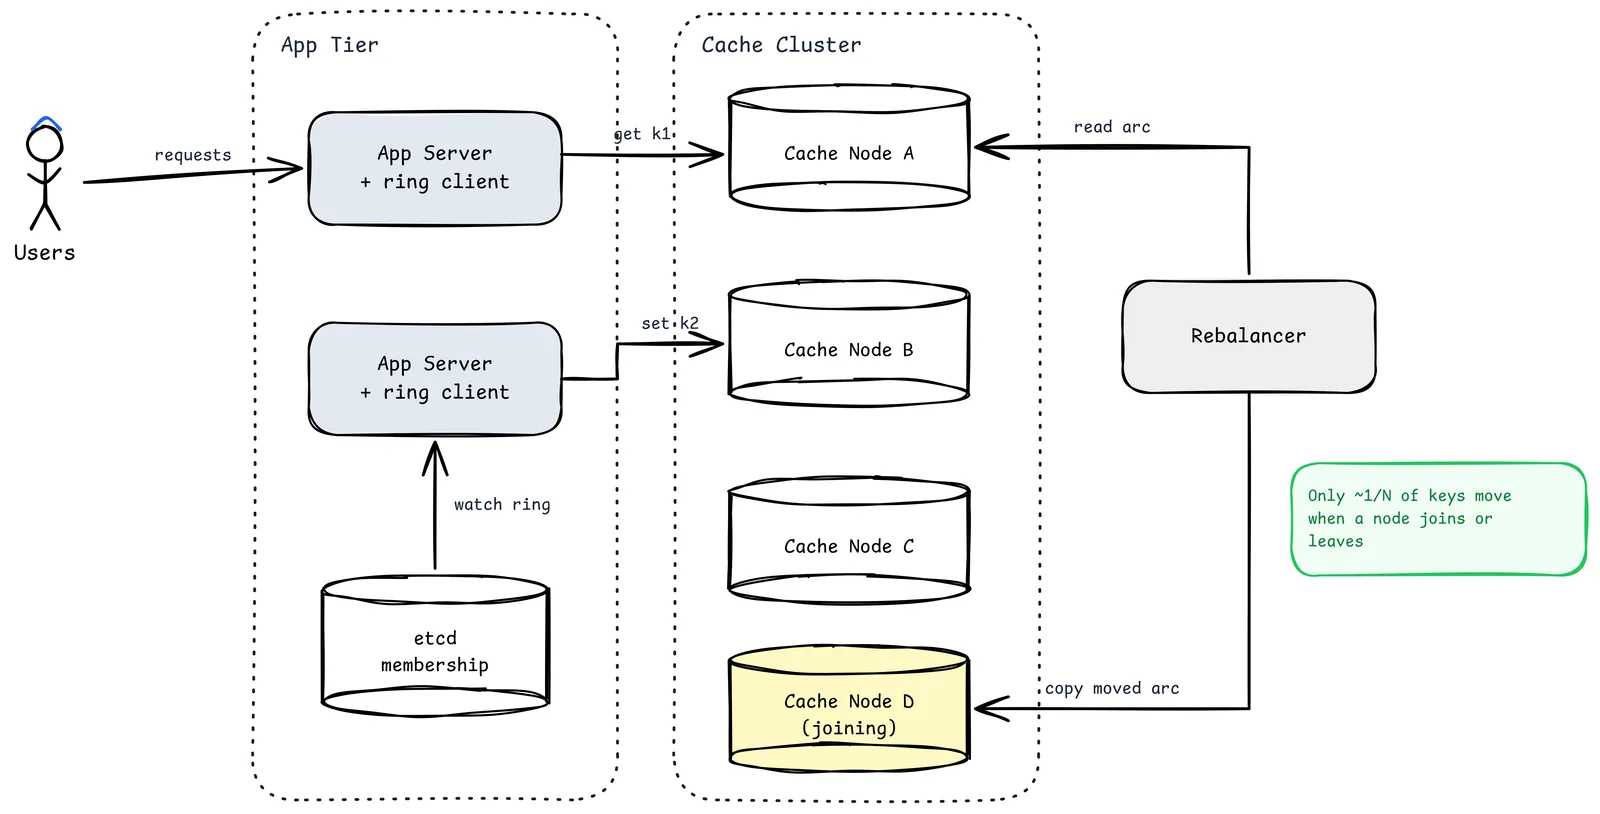
- App Server + client d'anneau. L'anneau vit dans la bibliothèque cliente (c'est ainsi que fonctionnent les clients memcached de style ketama). Pas de saut par un proxy, pas d'annuaire central sur le chemin de la requête.
- etcd (appartenance). La source de vérité sur les nœuds présents dans l'anneau et leurs poids. Les clients la surveillent et reconstruisent leur anneau quand elle change. ZooKeeper, Consul ou un protocole de gossip peuvent jouer le même rôle.
- Cache Nodes A, B, C. De simples serveurs clé-valeur. Ils n'ont pas besoin de connaître l'anneau.
- Cache Node D (en cours d'intégration). Ajouté d'abord à l'appartenance dans un état de « préchauffage ». Les clients commencent à lui envoyer les écritures de ses arcs pendant que le rééquilibreur le remplit.
- Rebalancer. Pour un cache, le rééquilibrage est facultatif : les échecs se reremplissent naturellement. Pour une base, ou tout état impossible à régénérer, le rééquilibreur transfère les arcs qui ont changé de propriétaire, avec un débit plafonné pour ne pas affamer le trafic réel.
La note verte résume tout : seuls environ 1/N des clés se déplacent.
Ce que le hachage cohérent ne résout pas
- Les clés chaudes. Si une clé reçoit 10 % de tout le trafic, elle vit toujours sur un seul serveur. L'anneau équilibre les clés, pas les requêtes. Il faut répliquer les clés chaudes, regrouper les requêtes ou ajouter un cache local de proximité.
- Des vues incohérentes de l'anneau. Si, pendant un changement d'appartenance, la moitié des clients a le nouvel anneau et l'autre moitié l'ancien, la même clé est lue à deux endroits. Pour un cache, cela fait davantage d'échecs. Pour une base, il faut une propriété versionnée (des époques) et un protocole de passation.
- La surcharge en cascade. Quand un nœud meurt, ses successeurs absorbent sa charge. S'ils étaient déjà à 80 %, ils peuvent tomber à leur tour. Le « hachage cohérent à charges bornées » (Mirrokni, Thorup et Zadimoghaddam) plafonne la charge de chaque nœud et déborde sur le suivant dans le sens horaire ; Vimeo a expliqué l'avoir adopté pour répartir la diffusion de ses vidéos.
Les alternatives à connaître
| Technique | Fonctionnement | Atout | Faiblesse | Où on la trouve |
|---|---|---|---|---|
| Anneau de hachage avec nœuds virtuels | Successeur dans le sens horaire sur un cercle | Ajouts et retraits arbitraires, listes de réplicas naturelles | Nécessite des nœuds virtuels pour l'équilibre ; métadonnées d'anneau | Dynamo, Cassandra, clients ketama, ring hash d'Envoy |
| Rendezvous (poids aléatoire le plus élevé) | Pour chaque clé, noter chaque nœud avec hash(key, node) et prendre le plus haut |
Pas d'anneau, équilibre quasi parfait, réplicas pondérés triviaux (les K premiers) | O(N) par recherche |
Répartiteurs de charge et petits clusters |
| Jump consistent hash | Fonction arithmétique de saut qui associe une clé à un seau 0..N-1 | Aucune mémoire, très rapide, excellent équilibre | On ne peut ajouter ou retirer des nœuds qu'en fin de numérotation | Stockage partitionné à partitions numérotées |
| Hachage Maglev | Table précalculée remplie à partir de permutations par backend | Recherches en O(1), très uniforme, perturbation minimale |
Reconstruction de la table à chaque changement ; conçu pour les répartiteurs de charge | Google Maglev, politique Maglev d'Envoy |
Ma règle empirique : rendezvous pour de petits ensembles de backends (quelques dizaines), anneau avec nœuds virtuels pour les systèmes de stockage qui ont besoin de listes de réplicas et de changements d'appartenance arbitraires, jump hash quand les partitions sont numérotées et ne font que croître, et Maglev pour les répartiteurs de charge de niveau 4.
Déroulé pour l'entretien
- Partez de
hash % Net montrez ce qui se passe quand N change. Utilisez le chiffre de 90 %. - Dessinez l'anneau et expliquez la propriété dans le sens horaire.
- Montrez qu'ajouter un nœud ne déplace qu'un arc.
- Pointez le déséquilibre avec un point par nœud, puis introduisez les nœuds virtuels.
- Ajoutez la réplication : les K serveurs distincts suivants, idéalement dans des zones différentes.
- Mentionnez une limite (les clés chaudes) et une alternative (rendezvous ou jump hash).
Liste de contrôle pour la production
- Fonction de hachage rapide et bien distribuée (Murmur3, xxHash) ; jamais un
hashCodeà la Java - Nombre de nœuds virtuels choisi et mesuré (écart de charge sous votre cible)
- Des poids qui reflètent la capacité réelle des nœuds
- Une source de vérité unique pour l'appartenance, surveillée par les clients
- Des changements d'anneau versionnés pour détecter les vues périmées
- Des réplicas répartis sur des domaines de panne distincts
- Des flux de rééquilibrage plafonnés et observables
- Une gestion des clés chaudes distincte du placement
- Un tableau de bord par nœud du nombre de clés et du débit de requêtes, pas seulement des moyennes
Ce qui reste
L'anneau fait partie de ces idées qui paraissent évidentes dès qu'on les voit et restent utiles pendant des décennies. Il ne fait qu'une chose : quand le cluster change, il laisse presque tout le monde à sa place.
C'est une promesse modeste. C'est aussi la différence entre ajouter un nœud à 3 heures du matin pour soulager la pression, et ajouter un nœud à 3 heures du matin qui emporte la base de données avec lui.
Sources
- Karger et al., « Consistent Hashing and Random Trees » (STOC 1997)
- DeCandia et al., « Dynamo: Amazon's Highly Available Key-value Store » (SOSP 2007)
- Lamping et Veach, « A Fast, Minimal Memory, Consistent Hash Algorithm » (jump hash, 2014)
- Eisenbud et al., « Maglev: A Fast and Reliable Software Network Load Balancer » (NSDI 2016)
- Mirrokni, Thorup et Zadimoghaddam, « Consistent Hashing with Bounded Loads »
- Envoy : types de répartiteurs de charge (ring hash et Maglev)
- Dans la même série : Concevoir un magasin clé-valeur, Passer de zéro à des millions d'utilisateurs