TL;DR
- Le problème : Les discussions de conception s'enlisent dans les adjectifs (« beaucoup de trafic », « gros fichiers ») parce que personne ne les a traduits en chiffres. Sans chiffres, impossible de savoir s'il faut une base de données ou cent, ni si les images peuvent être servies par vos propres serveurs.
- La méthode : Mémorisez quelques constantes (une journée, c'est environ 10^5 secondes, les puissances de deux, des latences approximatives), puis appliquez cinq recettes : requêtes par seconde, stockage, bande passante, taille du cache et nombre de serveurs. Arrondissez franchement, énoncez chaque hypothèse, et arrêtez-vous dès que les chiffres rendent une décision évidente.
- Le résultat : En cinq minutes, vous savez quelle partie du système est difficile. Dans l'exemple ci-dessous, le calcul montre que les images doivent passer par un CDN et un stockage objet bien avant de dessiner la moindre boîte.
Estimer, ce n'est pas tomber juste. C'est tomber juste à quelques facteurs près, rapidement, pour que la discussion de conception se concentre sur ce qui compte.
Un système qui doit absorber 50 écritures par seconde et un autre qui doit en absorber 50 000 sont deux systèmes différents. Un jeu de données de 50 Go tient en RAM ; 50 To, non. Pas besoin de précision pour les distinguer. Il faut l'ordre de grandeur, et la discipline de l'écrire.
Les constantes à mémoriser
Le temps
| Grandeur | Valeur approximative |
|---|---|
| Secondes par jour | 86 400, à arrondir à 10^5 |
| Secondes par mois | ~2,6 millions, à arrondir à 2,5 x 10^6 |
| Secondes par an | ~31,5 millions, à arrondir à 3 x 10^7 |
Les tailles
| Puissance de deux | Environ | Unité |
|---|---|---|
| 2^10 | mille | Ko |
| 2^20 | un million | Mo |
| 2^30 | un milliard | Go |
| 2^40 | mille milliards | To |
| 2^50 | un million de milliards | Po |
La latence (ordres de grandeur)
| Opération | Durée approximative |
|---|---|
| Accès à la mémoire principale | ~100 ns |
| Lire 1 Mo séquentiellement en mémoire | quelques µs |
| Lecture aléatoire sur SSD | quelques dizaines de µs |
| Aller-retour au sein d'un centre de données | ~0,5 ms |
| Lire 1 Mo séquentiellement sur SSD | de quelques dizaines de µs à ~1 ms |
| Déplacement de tête sur disque dur | ~5 à 10 ms |
| Aller-retour à travers un océan | ~100 à 150 ms |
Ces valeurs viennent de la célèbre liste des « latences que tout programmeur devrait connaître », popularisée par Jeff Dean et Peter Norvig puis mise à jour pour le matériel moderne. Les valeurs exactes évoluent ; ce sont les rapports qui comptent. La mémoire est mille fois plus rapide qu'un aller-retour réseau, lui-même cent fois plus rapide qu'une traversée d'océan.
La disponibilité
| Disponibilité | Indisponibilité par an | Indisponibilité par mois |
|---|---|---|
| 99 % | ~3,65 jours | ~7,3 heures |
| 99,9 % | ~8,8 heures | ~44 minutes |
| 99,99 % | ~53 minutes | ~4,4 minutes |
| 99,999 % | ~5,3 minutes | ~26 secondes |
Chaque neuf supplémentaire coûte environ un ordre de grandeur d'ingénierie de plus. Quatre neufs, cela signifie qu'aucun humain ne peut intervenir dans la plupart des incidents : la reprise doit être automatique.
Les cinq recettes
- QPS. Événements quotidiens divisés par 10^5. Puis multipliez par un facteur de pic (2x pour un trafic mondial régulier, 5 à 10x pour des produits grand public à pics).
- Stockage. Éléments par jour x taille par élément x durée de rétention x surcoût de réplication ou d'encodage.
- Bande passante. QPS x taille de la réponse, séparément pour les lectures et les écritures.
- Cache. Supposez que 20 % des éléments reçoivent 80 % des lectures ; dimensionnez le cache pour les 20 % chauds de l'ensemble de travail d'une journée.
- Serveurs. QPS de pointe divisé par ce qu'encaisse un serveur, plus une marge (visez 50 à 70 % d'utilisation en pic).
Un exemple complet : une application de partage de photos
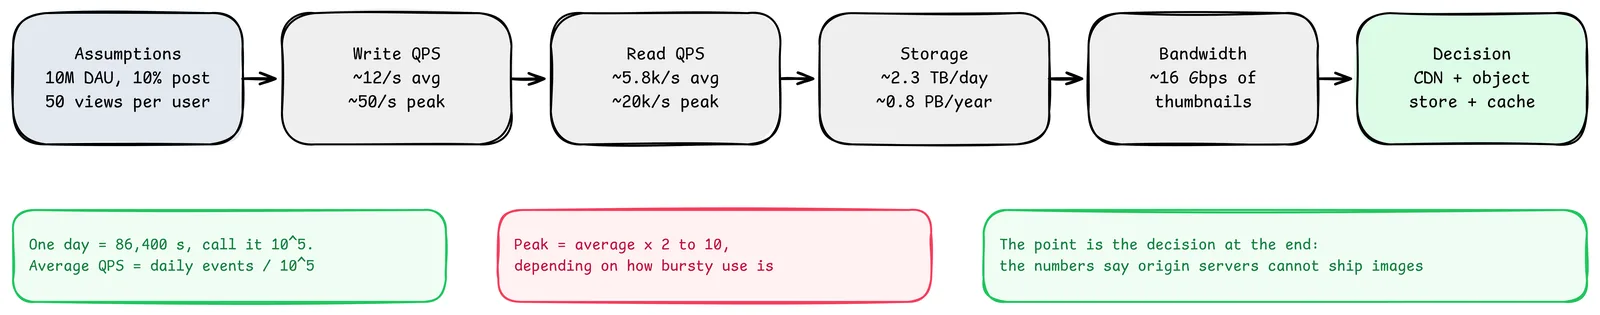
Hypothèses (dites-les à voix haute ; le recruteur ou votre équipe peuvent les changer) :
- 10 M d'utilisateurs actifs par jour.
- 10 % d'entre eux publient une photo par jour.
- Chaque utilisateur regarde 50 photos par jour.
- Chaque envoi est stocké sous forme d'un original de 2 Mo plus des miniatures, soit environ 2,3 Mo au total.
- Chaque vue charge une miniature d'environ 100 Ko.
QPS en écriture : 1 M d'envois par jour / 10^5 ≈ 10 à 12 par seconde en moyenne. Avec un pic à 4x, environ 50 par seconde. Les écritures ne sont pas le problème.
QPS en lecture : 10 M x 50 = 500 M de vues par jour / 10^5 ≈ 5 800 par seconde, environ 20 000 par seconde en pic. Les lectures représentent 400 à 500 fois les écritures.
Stockage : 1 M x 2,3 Mo ≈ 2,3 To par jour, environ 0,8 Po par an avant réplication. Avec une réplication 3x, cela fait environ 2,5 Po par an ; avec des codes d'effacement (environ 1,5x de surcoût), environ 1,2 Po. Les métadonnées, à 1 Ko par photo, ne pèsent qu'environ 1 Go par jour : rien à côté des images.
Bande passante : 20 000 miniatures par seconde x 100 Ko ≈ 2 Go/s ≈ 16 Gbit/s en pic, rien que pour les miniatures.
Ce que les chiffres décident :
- Les images vont dans un stockage objet, pas dans une base de données. Des pétaoctets de blobs n'ont rien à faire dans des lignes.
- Les images sont servies par un CDN. Seize gigabits par seconde depuis des serveurs d'origine seraient coûteux et lents pour les utilisateurs lointains ; un CDN en sert l'essentiel depuis la périphérie.
- La base de métadonnées reste modeste. Une base principale avec des réplicas de lecture et un cache encaisse sans peine 20 000 lectures par seconde, d'autant que le CDN absorbe le trafic d'images.
- Les écritures sont faibles, donc un chemin d'écriture simple et cohérent suffit. Inutile de chercher une montée en charge exotique des écritures.
Cette dernière liste est tout l'intérêt de l'exercice. La boîte verte du schéma en est le résultat ; tout ce qui précède est la manière dont vous avez gagné le droit de l'affirmer.
Le nombre de serveurs, sans faire semblant
Combien de requêtes un serveur peut-il traiter ? Cela dépend énormément du travail par requête, donc utilisez des fourchettes et dites-le :
| Composant | Capacité approximative par nœud (opérations simples) |
|---|---|
| Serveur applicatif sans état, API JSON simple | ~1 000 à 10 000 requêtes/s |
| Redis ou memcached | ~100 000+ opérations simples/s |
| Base relationnelle, lectures ponctuelles indexées | de quelques milliers à quelques dizaines de milliers/s, très dépendant de la charge |
| Périphérie de CDN | quasiment illimitée de votre point de vue |
À 20 000 requêtes par seconde en pic et 2 000 par serveur applicatif à une utilisation saine, il faut une dizaine de serveurs, plus quelques-uns pour la marge et les déploiements. Mesurez votre propre service avec un test de charge avant de vous fier à l'un de ces chiffres en production.
Les erreurs qui rendent les estimations inutiles
- La fausse précision. « 11,574 QPS » montre que vous êtes passé à côté du sujet. Dites « environ 10 ».
- Oublier le pic. Les moyennes cachent l'heure où tout le monde ouvre l'application.
- Oublier la réplication et les surcoûts. Trois réplicas triplent le stockage. Index, journaux et sauvegardes en ajoutent encore.
- Confondre bits et octets. Les liens réseau s'expriment en bits par seconde ; le stockage en octets. Divisez par 8.
- Tout estimer. Arrêtez-vous quand les chiffres ont pris la décision. Pas besoin de taux de succès du cache pour savoir que les images vont sur un CDN.
- Ne pas énoncer les hypothèses. Une estimation sans ses hypothèses ne peut être ni vérifiée ni corrigée.
Comment s'entraîner
Choisissez une application que vous utilisez chaque jour et estimez en cinq minutes son QPS d'écriture, son QPS de lecture et son stockage annuel. Cherchez ensuite des chiffres publics (blogs d'ingénierie, résultats financiers, conférences) et mesurez votre écart. Après une dizaine d'exercices de ce genre, votre intuition des ordres de grandeur devient fiable, et c'est précisément la compétence qu'évaluent les entretiens et les revues de conception.
Ce qui reste
La meilleure estimation que j'aie jamais faite était fausse d'un facteur trois, et cela n'avait aucune importance, car elle était juste sur le seul point qui comptait : la base de données n'allait pas être le problème, la bande passante des images, si.
C'est tout ce qu'est l'estimation. Une serviette en papier, quelques puissances de dix, et le courage de dire « cette partie est facile, celle-là non » avant que quiconque ait dessiné une boîte.
Sources
- Jeff Dean, « Designs, Lessons and Advice from Building Large Distributed Systems » (latences)
- Colin Scott : Latency numbers every programmer should know (interactif, mis à jour par année)
- Livre SRE de Google : Embracing Risk (disponibilité et budgets d'erreur)
- Backblaze : codes d'effacement et surcoût de stockage
- Dans la même série : Passer de zéro à des millions d'utilisateurs, Un cadre pratique pour les entretiens de conception de systèmes, Concevoir un raccourcisseur d'URL