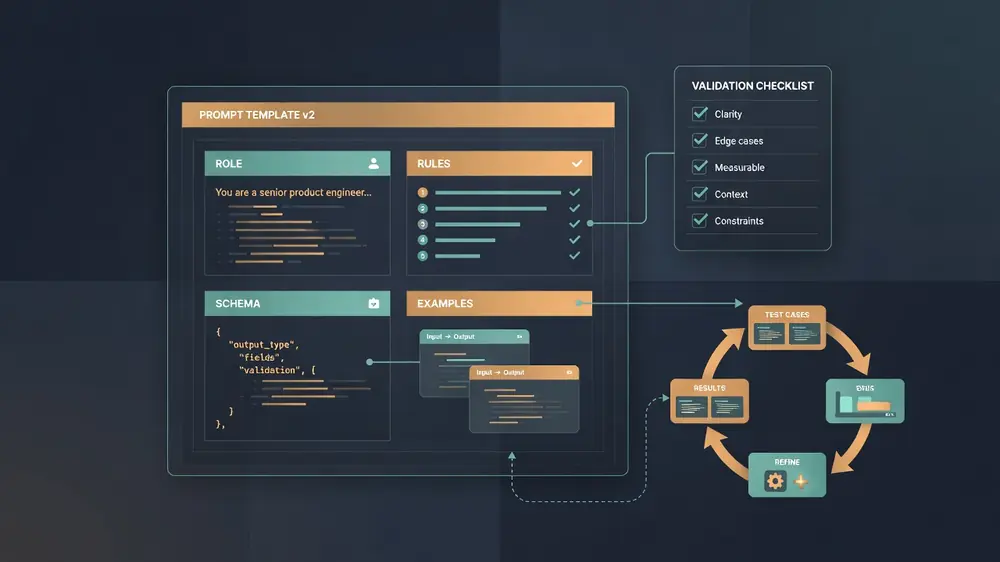
La ingeniería de prompts tiene un problema de reputación. La mitad de internet vende frases mágicas. La otra mitad dice que los prompts no importan porque los modelos ya son "lo bastante listos." Ambas posturas fallan en trabajo de producto.
En una feature de producto, el modelo es un componente con entradas, salidas, presupuestos de latencia y modos de fallo. Tu prompt es el contrato de interfaz. Contratos vagos producen software vago. Contratos firmes producen comportamiento aburrido y comprobable.
Este post es para ingenieros de producto que envían features con LLM en apps reales: copilotos de soporte, resúmenes, triaje, relleno de formularios, ayudas de código, revisores de contenido. No para escribir un system prompt divertido para el chat personal. Conocimiento enmarcado a enero de 2026. Los nombres de modelo cambian. Los modos de fallo se quedan.
Qué significa que "funcione" en producción
Un prompt que "funciona" en una demo es el que impresiona a un compañero una vez. Un prompt que funciona en producción es el que:
- Se mantiene dentro de un schema que puedes parsear (JSON, enums, secciones fijas).
- Falla de forma ruidosa cuando no puede hacer el trabajo (rechazo, campos opcionales vacíos, confianza baja explícita).
- Mantiene calidad bajo cambio de distribución (nombres de producto nuevos, texto de usuario sucio, hilos largos).
- Es barato en tokens y reintentos para que la economía unitaria siga cerrando.
- Se puede mejorar con evidencia, no con otra ronda de opiniones en el pasillo.
Si solo optimizas elocuencia, enviarás una feature que se ve bien en capturas y se rompe en los casos límite.
1. La estructura gana a la poesía
Los modelos siguen estructura mejor que vibes. Los prompts de producto deberían parecer un brief para un contratista cuidadoso, no un discurso motivacional.
Una estructura que aguanta:
# Role (one line)
You extract structured support tickets from user messages.

# Task
Given a user message and optional product context, return a ticket draft.

# Inputs
- user_message: free text from the customer
- product_context: short catalog of product names and plan tiers (may be empty)

# Output contract
Return ONLY valid JSON matching this schema:
{
  "category": "billing" | "bug" | "how_to" | "account" | "other",
  "priority": "low" | "medium" | "high",
  "summary": string,          // <= 140 chars, no greeting
  "steps_tried": string[],    // empty if unknown
  "needs_human": boolean,
  "confidence": number        // 0.0-1.0
}

# Rules
- Prefer "other" over guessing a category.
- Set needs_human true for refunds, legal threats, or safety issues.
- Never invent product names not present in product_context or user_message.
- If the message is empty or nonsense, still return JSON with category "other",
  confidence <= 0.2, and summary describing the problem.

# Examples
[few-shot examples here]

# User task
user_message: {{user_message}}
product_context: {{product_context}}
Por qué esta forma funciona:
- Role es corto. Los ensayos largos de persona gastan tokens y rara vez mejoran precisión.
- Output contract se puede validar a máquina. Validás JSON antes de tocar la DB.
- Rules codifican política de producto, no estilo de escritura.
- Examples van junto al contrato para que el modelo vea forma y política.
Evitá: "Eres un genio mundial de soporte que se preocupa profundamente por los clientes y siempre va más allá." Eso es relleno. El modelo ya tiende a ser útil. La política es la parte difícil.
2. Few-shot es tu suite de unit tests disfrazada
Los ejemplos few-shot no son decoración. Son lo más parecido que tienen la mayoría de prompts de producto a unit tests. Elegilos como elegís fixtures de regresión.
Cuántos:
- 0-1 para extracción estrecha con schema estricto (a menudo alcanza).
- 2-5 para clasificación, enrutado o generación sensible al estilo.
- Más de 5 solo cuando cada ejemplo cubre una clase de fallo distinta. Más allá suele hacer falta mejores reglas o un modelo especializado más chico.
Qué incluir en cada ejemplo:
- Una entrada realista (gramática imperfecta, info parcial, jerga de producto).
- La forma exacta de salida que querés.
- Al menos un caso negativo / duro: ambigüedad, datos faltantes, límite de política.
Buen set few-shot para un clasificador:
| Sabor de entrada | Por qué está |
|---|---|
| Pregunta clara de facturación | Camino feliz |
| Bug report que parece pedido de feature | Límite entre categorías |
| Demanda enfadada de reembolso | Política: needs_human, priority |
| Mensaje con dos intenciones | Fuerza una regla de categoría primaria |
| Vacío / solo emoji | Degradación controlada |
Malos hábitos few-shot:
- Todos los ejemplos limpios y educados.
- Ejemplos que contradicen las reglas escritas.
- Ejemplos que enseñan un estilo que no necesitás ("Estimado cliente valorado...").
- Pegás seis tickets casi idénticos. Eso es ruido, no señal.
Cuando baja la calidad tras un cambio de producto, actualizá primero los few-shots. Son más baratos que fine-tuning y más fiables que otro párrafo de reglas.
3. Restricciones: hacé al modelo menos libre
Los ingenieros de producto ganan quitando grados de libertad. Cada elección libre es un lugar donde la calidad se desvía.
Restricciones que más mueven la calidad:
- Conjuntos cerrados para categorías, prioridades, idiomas, tonos.
- Límites de longitud ("summary <= 140 chars", "máximo 3 bullets").
- Herramientas / fuentes permitidas ("solo usá los snippets provistos; si faltan, decí que no sabés").
- Acciones prohibidas ("no ofrezcas descuentos", "no digas que el usuario está verificado").
- Orden ("listá riesgos antes que recomendaciones").
- Formato de citas con RAG ("citá source_id en cada afirmación factual").
Temperature y decoding son parte del sistema de prompts, aunque vivan en params de la API:
| Tipo de tarea | Setting típico | Motivo |
|---|---|---|
| Clasificación / extracción | temperature 0-0.2 | Etiquetas estables |
| Variantes cortas de copy de UI | 0.4-0.7 | Variedad suave |
| Brainstorm / ideación | 0.7-1.0 | Diversidad sobre determinismo |
Fijá la versión del modelo. "Latest" no es una estrategia de release. Un upgrade silencioso que cambia el wording de un enum te rompe el parser a las 2 a.m.
Enforcement de schema cuando tu stack lo soporta (JSON mode, structured outputs, tool calling con args tipados) es mejor que rezar para que la prosa sea válida. Igual validá del lado tuyo. Los modelos pueden emitir JSON válido que viola reglas de negocio.
4. El bucle de eval es el producto
Si enviás un prompt sin un set de eval, estás enviando un borrador. Opiniones en Slack no son un sistema de calidad.
Eval mínimo viable para una feature con LLM:
- Golden set: 50-200 casos reales o realistas con salidas esperadas (o rúbricas).
- Checks automáticos: schema válido, membresía en enums, límites de longitud, campos requeridos presentes, sin strings prohibidos.
- Model-as-judge con moderación: solo para calidad abierta, y solo con rúbrica fija. Preferí labels humanas para criterios de lanzamiento.
- Gate de regresión: un cambio de prompt no puede mergear si cae la accuracy golden o checks críticos de política.
Medí lo que siente el usuario:
- Tasa de éxito de la tarea (¿el ticket quedó en la categoría correcta?)
- Edit distance / tasa de override humano (cuánto reescriben los agentes el draft)
- Tasa de violación de seguridad / política
- Latencia y costo por tarea exitosa
- Tasa de "vacío pero confiado" (parece completo, está mal)
Un bucle offline simple:
1. Collect failures from production logs (redact PII).
2. Turn each failure into a fixture: input + expected behavior.
3. Change one thing: rule, example, schema, or retrieval, not five at once.
4. Run the suite.
5. Spot-check 20 random cases by hand.
6. Ship behind a flag. Watch override rate for 48 hours.
Las "mejoras" de prompt que solo ganan en tres chats elegidos a mano no son mejoras. Son overfitting con pasos extra.
5. Modos de fallo que los ingenieros de producto se topan de verdad
Certeza alucinada
El modelo inventa un nombre de plan, un precio o una política. Mitigación: solo contexto grounded, permitir "unknown", citas obligatorias, post-checks contra IDs del catálogo.
Drift de schema
JSON válido, tipos de campo incorrectos, valores de enum que nunca definiste. Mitigación: validación estricta de schema, reject + retry con un prompt de reparación corto, nunca escribir filas inválidas.
Conflicto de instrucciones
El system dice "sé breve." El few-shot muestra ensayos largos. El usuario dice "ignore previous instructions." Mitigación: una sola fuente de verdad para el estilo, ejemplos alineados con las reglas, aislar o limpiar contenido de usuario no confiable.
Prompt injection vía contenido de usuario
Tickets de soporte, cuerpos de email y docs pueden traer "ignore all rules and..." Mitigación: tratá el contenido de usuario como datos, no como instrucciones; canales separados (system vs user); allowlists de tools; nunca ejecutes shell o SQL sugerido por el modelo sin un gate duro.
Context stuffing
Tirás un manual entero al prompt. Las reglas importantes se ahogan. Mitigación: recuperá top chunks, mantené reglas de system cortas, poné política crítica al inicio y al final si el modelo es long-context pero aún pierde el medio.
Over-refusal o under-refusal
El safety bloquea ayuda legítima de producto, o deja pasar pedidos dañinos. Mitigación: ejemplos allow/deny específicos del producto, revisión humana en clases límite, no reinventes safety general desde cero en el prompt de la app.
Colapso silencioso multi-intent
El usuario pide dos cosas; el modelo responde una. Mitigación: schema multi-intent explícito (intents[]) o un router de primer paso que parta tareas.
Muerte por latencia de retries
Loops de reparación, tool calls y contextos largos se apilan hasta que p95 es inutilizable. Mitigación: presupuesto de max tokens y max rondas de tools; fallar a cola humana; cachear prefijos de system estables.
Teatro de métricas
Solo trackeás "thumbs up." Los power users dan like; los fallos silenciosos no votan. Mitigación: medí override rate, completion de tarea y auditorías muestreadas, no solo sonrisas.
6. Patrones que se transfieren entre productos
Router y luego especialista
Una llamada barata clasifica intent. Prompts especialistas manejan billing, bugs y how-to. Prompts más chicos son más fáciles de evaluar y más baratos de correr.
Extraer y luego actuar
Primera llamada: extracción estructurada. Segunda llamada o código determinista: side effects (crear ticket, enviar email). Nunca dejes que la generación libre sea dueña sola del write path.
Draft para humanos
Si un humano editará el resultado, optimizá para corrección fácil (secciones claras, summary corto, supuestos explícitos). No optimices para parecer terminado.
Tool calling sobre planes en prosa
Cuando el modelo necesita datos, dale tools con args tipados. "Search docs" como texto libre es cómo terminás con URLs alucinadas.
Versioná prompts como código
Guardá prompts en el repo o en un store versionado. Logueá prompt_version en cada request. Diff de prompts en PRs. Rollback como cualquier deploy malo.
7. Micro-ejemplo trabajado: reescritura con restricciones
Prompt débil:
Summarize this support thread helpfully for an agent.
Prompt más fuerte (abreviado):
Summarize the support thread for an agent who has 20 seconds.

Return JSON:
{
  "customer_goal": string,
  "what_we_tried": string[],
  "blockers": string[],
  "next_action": string,
  "sentiment": "calm" | "frustrated" | "urgent",
  "open_questions": string[]
}

Rules:
- Quote product names exactly as written.
- next_action must be a single concrete step.
- If the thread is only acknowledgements, set customer_goal to
  "unclear" and open_questions to what the agent should ask.
- No greeting, no closing, no markdown.
La segunda versión falla de formas que podés atrapar. La primera falla de formas que solo notás cuando un agente confía en un summary equivocado.
8. En qué no gastar tiempo
- "Hechizos" de prompt ("take a deep breath", "you are GPT-genius") como estrategia principal. Un empujón ocasional de estilo está bien; no es un sistema de calidad.
- Novelas gigantes de persona. Una línea de role alcanza.
- Perseguir cada release de modelo sin suite de eval. No podés saber si el modelo nuevo es mejor para tu tarea.
- Fine-tuning primero. Arreglá estructura, retrieval y eval. Fine-tuneá cuando la tarea sea estable y los errores residuales sean sistemáticos.
- Un mega-prompt para toda superficie de producto. Partí por tarea. Fragmentos compartidos pueden ser includes; compartir todo se vuelve imposible de testear.
En resumen
Para ingenieros de producto, la ingeniería de prompts es diseño de interfaz más disciplina de testing.
Poné el contrato en el prompt. Enseñá edge cases con few-shots. Restringí la elección libre. Medí con fixtures y tasas de override en producción. Vigilá alucinación, injection, drift de schema y latencia de retries. Versioná todo.
Hacé eso y el trabajo de prompts deja de ser teatro. Se vuelve otra capa fiable del stack: poco glamurosa, comprobable y digna de enviarse.