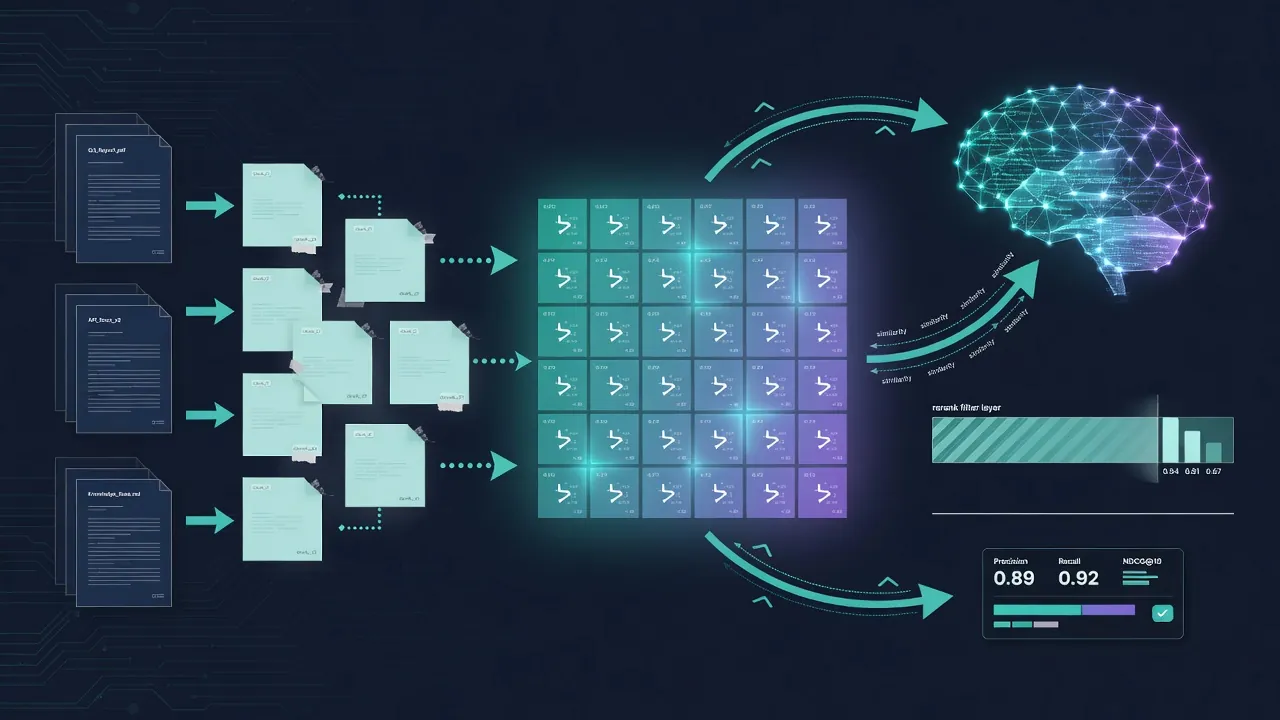
La generación aumentada por recuperación (RAG) parece simple en una diapositiva: embeber documentos, guardar vectores, recuperar top-k, rellenar el prompt y generar. En producción ese pipeline pierde calidad en cada etapa. Este post es un recorrido concreto de un stack RAG práctico, las decisiones que de verdad mueven la aguja y los casos en los que RAG es la herramienta equivocada.
El conocimiento aquí se enmarca a inicios de 2026. Los nombres de herramientas cambian; los modos de fallo, casi no.
Qué estás construyendo de verdad
Un modelo mental útil tiene cinco etapas:
- Ingerir y trocear (chunk) el corpus en unidades que el modelo pueda usar.
- Embeber esas unidades en un espacio vectorial (y a menudo mantener también un índice de palabras clave).
- Recuperar candidatos para una consulta (denso, disperso o híbrido).
- Reordenar (rerank) esos candidatos con un modelo más fuerte y más lento.
- Generar y luego evaluar las respuestas frente a verdad de referencia para mejorar el ciclo.
Si omites la evaluación, afinas por intuición. Si omites el reranking y la búsqueda híbrida, le das demasiado crédito al modelo de embeddings por problemas que no puede resolver.
Documentos -> Chunker -> Embedder -> Almacén vectorial (+ BM25)
                              ^
Consulta de usuario ----------+--> Retrieve híbrido -> Rerank -> Prompt + LLM -> Respuesta
                                                              |
                                                         Harness de eval (offline)
Etapa 1: Chunking (donde se pierde calidad al principio)
Los embeddings no "entienden documentos". Puntúan similitud sobre la unidad que guardaste. Límites de chunk malos producen mala recuperación, da igual el modelo.
Defaults prácticos
| Estrategia | Tamaño típico | Cuándo funciona | Fallo habitual |
|---|---|---|---|
| Tokens fijos con solapamiento | 256-512 tokens, 10-20% overlap | Prosa uniforme, políticas, wikis | Parte tablas, código o procedimientos a medias |
| Por estructura (títulos, secciones) | Sección con tope de longitud | Markdown, sitios de docs, manuales | Secciones enormes aún necesitan un segundo corte |
| Splitters semánticos / recursivos | Variable | Corpus mixtos | Más difíciles de depurar; deriva si cambia el splitter |
| Padre-hijo (retrieve pequeño, contexto grande) | Hijo ~128-256, padre ~1k+ | Manuales largos | Más complejidad de índice y almacenamiento |
Reglas que aguantan en la práctica:
- Prefiere estructura frente a ventanas puras de tokens cuando el origen tiene encabezados.
- Mantén una idea por chunk cuando puedas. Los procedimientos y ejemplos de API no deben cortarse a medias.
- Guarda metadatos ricos: ruta, título, sección, versión de producto, idioma, última actualización, ACL de acceso.
- El overlap ayuda a la continuidad, pero un 50% de solapamiento suele quemar almacenamiento y complicar el dedup.
- En tablas, guarda un chunk resumen en prosa y conserva la tabla estructurada si las respuestas dependen de números exactos.
Boceto de ejemplo (estilo Python, agnóstico de librería):
def chunk_markdown(md: str, max_tokens: int = 400, overlap: int = 40):
    sections = split_on_headings(md)  # conservar límites # / ##
    chunks = []
    for section in sections:
        if token_len(section) <= max_tokens:
            chunks.append(section)
        else:
            chunks.extend(sliding_window(section, max_tokens, overlap))
    return chunks
Si la recuperación es débil, vuelve a trocear antes de cambiar el modelo de embeddings. Ese arreglo es más barato y suele ser el correcto.
Etapa 2: Embeddings
Tu modelo de embeddings define la geometría de la búsqueda. En 2025-2026 funcionan tanto modelos abiertos multilingües como APIs comerciales fuertes; la elección es latencia, coste, cobertura de idiomas y si los datos pueden salir de tu VPC.
Checklist de selección
- Dimensión y coste: más dimensiones no son gratis a escala (almacenamiento + memoria ANN).
- Longitud máxima de entrada: si los chunks son de 512 tokens, un embedder de 256 trunca en silencio.
- Dominio: legal, médico y código a menudo necesitan embeddings afinados al dominio.
- Versión fijada: nunca "latest" en producción. Re-embeber un corpus completo es una migración.
- Mismo modelo para query y documento, salvo que uses un par asimétrico entrenado así.
Consejos de índice:
- Usa HNSW o un equivalente gestionado para la mayoría de corpus a escala de aplicación.
- Normaliza vectores si usas similitud coseno (muchos clientes lo hacen por ti).
- Mantén el texto crudo junto al vector. Lo necesitarás para prompts, citas y reindexado.
# Pseudocódigo: embeber y upsert
vectors = embed_model.encode(chunk_texts, normalize=True)
store.upsert([
    {"id": ids[i], "vector": vectors[i], "text": chunk_texts[i], "meta": metas[i]}
    for i in range(len(ids))
])
Etapa 3: Retrieval (solo denso no basta)
La búsqueda vectorial pura falla con identificadores exactos: códigos de error, SKUs, nombres de función, números de factura, IDs de política. La búsqueda solo por palabras clave falla en paráfrasis. El retrieval híbrido es el default en apps serias.
Un patrón híbrido sólido
- Búsqueda densa (top 30-50).
- Búsqueda BM25 / sparse (top 30-50).
- Fusionar con Reciprocal Rank Fusion (RRF) o fusión ponderada de scores.
- Deduplicar chunks casi idénticos (misma fuente + alto solapamiento de texto).
- Pasar la shortlist fusionada al reranker.
def rrf(rank_lists, k=60):
    scores = {}
    for ranks in rank_lists:
        for rank, doc_id in enumerate(ranks, start=1):
            scores[doc_id] = scores.get(doc_id, 0.0) + 1.0 / (k + rank)
    return sorted(scores, key=scores.get, reverse=True)
Mejoras del lado de la query que importan
- Reescritura de query: expandir acrónimos, añadir nombres de producto del contexto de sesión.
- Multi-query: generar 2-4 paráfrasis, recuperar por cada una y fusionar.
- Filtros primero: aplica ACL, tenant, idioma y versión antes o dentro del ANN, no después de generar.
- HyDE (embeddings de documentos hipotéticos) puede ayudar en corpus dispersos; mídalo, no lo asumas.
Si los usuarios hacen preguntas multi-hop ("compara el precio del plan A y B tras el cambio de 2024"), el top-k de un solo disparo suele fallar. Necesitas retrieval multi-paso o una capa grafo/estructurada. Eso es una decisión de producto, no un ajuste de prompt.
Etapa 4: Reranking
Los bi-encoders (embeber query y doc por separado) son rápidos y aproximados. Un reranker cross-encoder lee query y documento juntos y suele reordenar la shortlist con mucha más precisión.
Patrón típico:
- Recuperar 30-50 candidatos baratos.
- Rerankear a top 5-10 para el prompt.
- Presupuestar latencia: los rerankers cuestan más; cachea por (hash de query, id de doc) cuando el tráfico se repite.
pairs = [(query, doc["text"]) for doc in candidates]
scores = reranker.predict(pairs)
top = [doc for _, doc in sorted(zip(scores, candidates), reverse=True)[:8]]
Cuándo más ayuda el reranking: políticas parecidas, manuales casi duplicados, ruido de "sección casi correcta". Cuándo no: corpus vacío o equivocado, mal chunking, o preguntas que necesitan cálculo más que citas.
Etapa 5: Prompt de generación (aburrido y estricto)
El generador debe estar acotado:
- Responder solo desde el contexto proporcionado.
- Citar ids de chunk o rutas de origen.
- Decir no lo sé cuando el contexto no baste.
- Preferir citas extractivas para números y lenguaje legal.
Boceto:
Eres un asistente de soporte. Usa SOLO los bloques de CONTEXTO.
Si la respuesta no está en CONTEXTO, di que no lo sabes.
Cita las fuentes como [n] según el número de bloque.

PREGUNTA: {question}

CONTEXTO:
[1] {chunk_1}
[2] {chunk_2}
...
Temperatura baja para bots de soporte factual. No metes 20 chunks largos: pagas en coste, latencia y errores de "lost in the middle". Tras el rerank, 4-8 chunks enfocados superan a 20 mediocres.
Etapa 6: Evaluación (sin esto estás adivinando)
La eval offline es cómo comparas tamaños de chunk, modelos y prompts sin enviar regresiones a usuarios.
Construye un golden set pequeño
Empieza con 50-200 preguntas reales de tickets, logs de búsqueda o expertos. Por cada ítem guarda:
- pregunta
- respuesta esperada (o hechos clave)
- ids de docs / chunks relevantes (etiquetas)
- opcional: hard negatives
Métricas que mapean a etapas del pipeline
| Etapa | Métrica | Qué te dice |
|---|---|---|
| Retrieval | Recall@k, MRR, nDCG | ¿Entró el chunk correcto en la shortlist? |
| Rerank | nDCG / MRR tras rerank | ¿Mejoró el orden? |
| Generación | Faithfulness / groundedness | ¿Inventó hechos el modelo? |
| Generación | Relevancia de la respuesta | ¿Abordó la pregunta? |
| Extremo a extremo | Exact match / F1 / LLM-as-judge con rúbricas | Calidad global |
Bucle práctico:
- Arregla primero el recall (chunking, híbrido, filtros).
- Luego mejora la precisión en el prompt (rerank, menos chunks mejores).
- Luego aprieta la generación (prompt, citas, comportamiento de rechazo).
- Vuelve a ejecutar la suite en cada cambio de chunker, versión de embedder o system prompt.
Las señales online siguen importando: thumbs down, escalado a humano, clics en citas, etiquetas de "no útil". Los golden sets offline envejecen; renueva cada trimestre.
Arquitectura de referencia mínima
Para un bot de conocimiento interno de tamaño medio (decenas de miles de páginas):
| Componente | Elección pragmática |
|---|---|
| Ingest | Crawler programado + webhook en actualizaciones de docs |
| Chunk | Markdown/HTML por estructura, 300-500 tokens, muchos metadatos |
| Embed | Un modelo multilingüe fijado; re-embed en batch al subir de versión |
| Store | Postgres + pgvector o un vector DB gestionado; BM25 en el mismo sistema o OpenSearch |
| Retrieve | Híbrido + filtros de metadatos + RRF |
| Rerank | Cross-encoder o API reranker sobre el top 40 |
| LLM | El que ya confíes por latencia/coste; temperatura baja |
| Eval | Golden set en CI; bloquear deploys si regresa recall@10 |
| Observabilidad | Log de query, ids recuperados, scores, citas finales, desglose de latencia |
No necesitas cinco frameworks de agentes. Un pipeline aburrido con buen chunking y eval gana a un grafo de agentes ingenioso sobre un índice desordenado.
Cuándo falla el RAG (sé honesto con stakeholders)
RAG no es una capa de inteligencia general. Falla de formas predecibles:
1. La respuesta no está en el corpus
Ningún truco de retrieval inventa una política que falta. Mide cobertura. Si soporte pregunta por el producto X y la docs solo cubren Y, el comportamiento correcto es rechazar, no adivinar con confianza.
2. La pregunta necesita razonar sobre muchos hechos
Multi-hop, comparación temporal y "resume todo lo que sabemos" estiran el RAG de un solo disparo. Puede hacer falta retrieval multi-paso, datos estructurados o un flujo humano.
3. Exactitud y aritmética
Totales de factura, cálculos de dosis y matemáticas de SLA pertenecen a herramientas o bases de datos, no a "ojalá el párrafo correcto". Combina RAG con calculadoras y SQL donde importen los números.
4. Fuentes en conflicto o caducadas
Dos versiones de una política en el índice producen respuestas que cambian de un día a otro. Filtros de versión, reglas de supersesión y metadatos de recencia son features de producto, no extras opcionales.
5. Errores de control de acceso
Recuperar un doc que el usuario no puede ver es un bug de seguridad. Aplica ACL en el momento del retrieval. No confíes en que el LLM "no mencione" texto restringido que ya está en el prompt.
6. Teatro de evaluación
Demos de leaderboard con preguntas elegidas a mano ocultan el dolor de producción. Si no puedes mostrar recall@k en una muestra real de queries, no sabes si el sistema funciona.
7. Cuándo fine-tuning o búsqueda simple es mejor
- Tareas de estilo/tono estables: fine-tuning o buen prompting pueden ganar a la retrieval.
- Lookup de ítem conocido ("abre el ticket #1842"): gana keyword y búsqueda estructurada.
- Datos personales muy dinámicos: consulta el sistema de registro; no lo congeles en vectores a diario salvo que debas.
Orden de construcción corto si empiezas esta semana
- Define el trabajo: FAQ de soporte, Q&A de wiki interna, docs de código. Acota el corpus.
- Reúne 50 preguntas reales y etiqueta los docs relevantes.
- Publica un hybrid retrieve aburrido + prompt simple con citas y rechazo.
- Mide recall@10 y faithfulness en ese set.
- Añade reranking solo cuando el recall de retrieval sea decente.
- Automatiza ingest y reindex ante cambios de docs.
- Pon la eval en CI antes de pulir la UI.
La mayoría de equipos invierte este orden: UI y demos de agentes primero, calidad de retrieval al final. Los usuarios notan ese orden al instante.
Cierre
Un pipeline RAG práctico es, sobre todo, recuperación de información con un LLM al final. Trocea para que las unidades coincidan con cómo pregunta la gente. Embebe con un modelo fijado. Recupera en híbrido. Reordena la shortlist. Genera con reglas estrictas de grounding. Evalúa cada cambio.
Cuando el corpus está incompleto, la pregunta es multi-hop o la tarea es puro cálculo, dilo y construye el componente correcto. RAG es potente dentro de su carril. Fuera de ese carril se convierte en una forma fluida de equivocarse.